
xpath爬虫实战-爬取小说斗罗大陆第四部
爬取思路
- 用到的第三方库文件
lxml,requests,fake_agent - 用fake_agent里的UserAgent修饰爬虫
- 用requests进行基本的请求
- 用lxml进行html的分析
- 用xpath进行网页元素的选择
爬取的一些问题
1.编码问题这两个编码无法转换成utf-8
- UnicodeEncodeError: ‘gbk’ codec can’t encode character ‘\xa0’ in position 15: illegal multibyte sequence
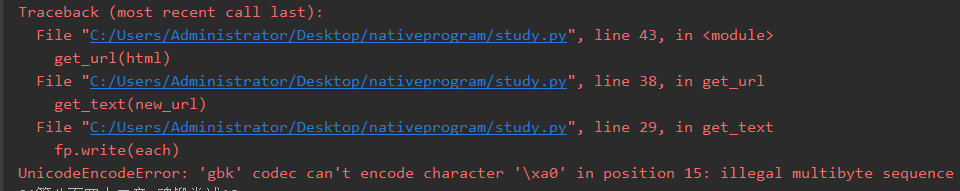
- UnicodeEncodeError: ‘gbk’ codec can’t encode character ‘\xufeff’ in position 15: illegal multibyte sequence
- 解决:将这两个提前换成空字符
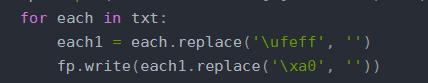
2.要提前建好一个txts的文件夹
全部源码
from lxml import etree

import requests

from fake_useragent import UserAgent

url1 = 'https://www.ibiquge.net/66_66791/'

url2 = 'https://www.ibiquge.net'

# 爬取HTML的函数

def get_html(url):

    ua = UserAgent()

    kv = {'user-agent': ua.random}

    re = requests.get(url, headers=kv)

    re.encoding = 'utf-8'

    htm1 = re.text

    return htm1

# 根据url获得文章并保存的函数

def get_text(url):

    html = get_html(url)

    selector = etree.HTML(html)

    title = selector.xpath('//*[@id="main"]/div/div/div[2]/h1/text()')

    txt = selector.xpath('//*[@id="content"]/text()')

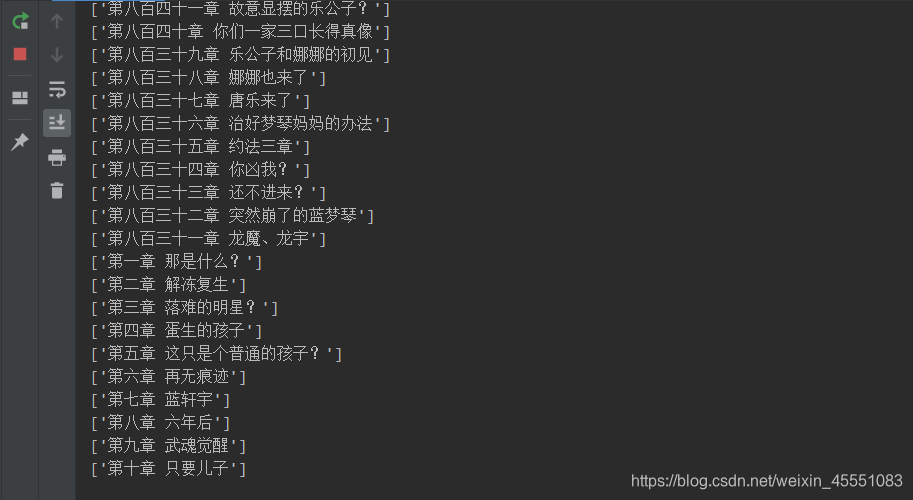
    print(title)

    fp = open('txts\\' + title[0] + '.txt', 'w')

    for each in txt:

        each1 = each.replace('\ufeff', '')

        fp.write(each1.replace('\xa0', ''))

    fp.close()

def get_url(html):

    selector = etree.HTML(html)

    url_list = selector.xpath('//*[@id="list"]/dl/dd/a/@href')

    for url in url_list:

        new_url = url2 + url

        get_text(new_url)

if __name__ == '__main__':

    html = get_html(url1)

    get_url(html)
爬取过程
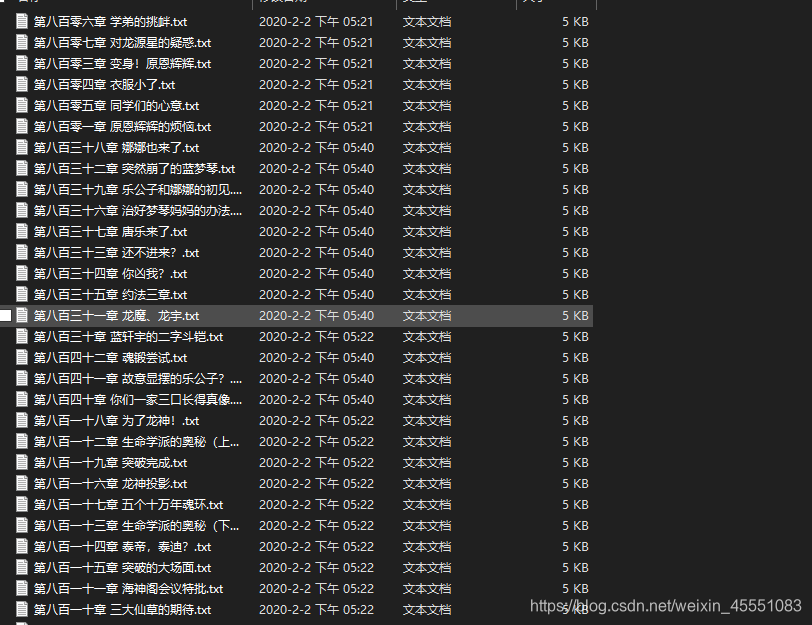
爬取结果
如有侵权,联系删除
xpath爬虫实战-爬取小说斗罗大陆第四部的更多相关文章
- python爬虫实战---爬取大众点评评论
python爬虫实战—爬取大众点评评论(加密字体) 1.首先打开一个店铺找到评论 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经 ...
- 第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解
第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解 封装模块 #!/usr/bin/env python # -*- coding: utf- ...
- Python实战项目网络爬虫 之 爬取小说吧小说正文
本次实战项目适合,有一定Python语法知识的小白学员.本人也是根据一些网上的资料,自己摸索编写的内容.有不明白的童鞋,欢迎提问. 目的:爬取百度小说吧中的原创小说<猎奇师>部分小说内容 ...
- 九 web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解
封装模块 #!/usr/bin/env python # -*- coding: utf-8 -*- import urllib from urllib import request import j ...
- 初次尝试python爬虫,爬取小说网站的小说。
本次是小阿鹏,第一次通过python爬虫去爬一个小说网站的小说. 下面直接上菜. 1.首先我需要导入相应的包,这里我采用了第三方模块的架包,requests.requests是python实现的简单易 ...
- Scrapy爬虫实战-爬取体彩排列5历史数据
网站地址:http://www.17500.cn/p5/all.php 1.新建爬虫项目 scrapy startproject pfive 2.在spiders目录下新建爬虫 scrapy gens ...
- python2.7 爬虫_爬取小说盗墓笔记章节及URL并导入MySQL数据库_20161201
1.爬取页面 http://www.quanshu.net/book/9/9055/ 2.用到模块urllib(网页下载),re正则匹配取得title及titleurl,urlparse(拼接完整ur ...
- 慕课爬虫实战 爬取百度百科Python词条相关1000个页面数据
http://www.imooc.com/learn/563 spider_main.py #!/usr/bin/python # coding=utf-8 #from baike_spider im ...
- Node.js爬虫实战 - 爬你喜欢的
前言 今天没有什么前言,就是想分享些关于爬虫的技术,任性.来吧,各位客官,里边请... 开篇第一问:爬虫是什么嘞? 首先咱们说哈,爬虫不是"虫子",姑凉们不要害怕. 爬虫 - 一种 ...
随机推荐
- 解决Pycharm导入当前项目的.py文件错误
如图所示错误,由左边导航栏可见.py文件存在: 解决办法:右键单击导包错误文件所在目录,选择[Mark Directory as]+[Sources Root] 错误已解决:
- Vue 里面对树状数组进行增删改查 的方法
[{"id":"5e4c3b02fc984961a17607c37712eae0", "optLock":0, "parentId ...
- 关于visocode 自动保存时自动添加分号问题
先下载插件: Vueter 打开设置的配置文件,写入一下代码: // //是否需要保存时自动格式化 "editor.formatOnSave": true, //使js 文件保存 ...
- B. Kvass and the Fair Nut
B. Kvass and the Fair Nut time limit per test 1 second memory limit per test 256 megabytes input sta ...
- STM32F103ZET6外部中断
1.EXTI功能 外部中断/事件控制器EXTI管理了STM32的20个中断/事件线. EXTI的功能框图如下: 在功能框图中,可以看到很多在信号线上打了一个斜杠并标注“20”的字样,这是表示在STM3 ...
- find的基本查询命令《一》
一. find的基本查询命令 find命令最常用的是查找某个文件,如: find ./ -name "abc.txt" 则会在当前目录及子目录下查找abc.txt文件 更常用的是查 ...
- Wireshark的使用(抓包、过滤器)
Wireshark的使用(抓包.过滤器) 听语音 分步阅读 Wireshark这个转包工具的简单实用 工具/原料 Wireshark软件包 方法/步骤 Wireshark是世界上最流行的网络分析工具. ...
- 「给产品经理讲JVM」:垃圾收集算法
纠结的我,给我的JVM系列终于起了第三个名字,害,我真是太难了.从 JVM 到 每日五分钟,玩转 JVM 再到现在的给产品经理讲 JVM ,虽然内容为王,但是标题可以让更多的人看到我的文章,所以,历经 ...
- Tcl编程第三天,数学运算
1.tcl语言没有自己的数学计算,如果想要使用数学公式,必须得用C语言的库.使用方法如下. #!/usr/bin/tclsh set value [expr 8/5] puts $value set ...
- Spring XML Bean 定义的加载和注册
前言 本篇文章主要介绍 Spring IoC 容器怎么加载 bean 的定义元信息. 下图是一个大致的流程图: 第一次画图,画的有点烂.