
python2.7 爬虫_爬取小说盗墓笔记章节及URL并导入MySQL数据库_20161201
1、爬取页面 http://www.quanshu.net/book/9/9055/
2、用到模块urllib(网页下载),re正则匹配取得title及titleurl,urlparse(拼接完整url),MySQLdb(导入MySQL) 数据库
3、for 循环遍历列表 取得盗墓笔记章节title 和 titleurl
4、try except 异常处理
5、python 代码
#-*-coding: utf-8 -*-

import urllib

import re

import urlparse

import MySQLdb

rooturl='http://www.quanshu.net/book/9/9055/'

#getlist返回包含title 和titleurl的列表

def getlist(url):

    html=urllib.urlopen(url).read()

    html=html.decode('gb2312').encode('utf-8')

    reg=r'<li><a href="(.*?)" title=".*?">(.*?)</a></li>'

    return re.findall(reg,html)

try:

    conn = MySQLdb.connect(host='localhost', user='root', passwd='Admin@', db='local_db', port=3306, charset='utf8')

    with conn:

        cursor = conn.cursor()

        #如果存在daomubiji数据表先删除

        drop_table_sql='DROP  TABLE IF EXISTS daomubiji'

        cursor.execute(drop_table_sql)

        conn.commit()

        #如果存在daomubiji数据表 先删除后接着创建daomubiji表

        create_table_sql = '''

           CREATE TABLE daomubiji (

           ID INT(11),

           title VARCHAR(255),

           titleurl VARCHAR(255)

           )ENGINE=INNODB DEFAULT CHARSET=utf8

        '''

        cursor.execute(create_table_sql)

        conn.commit()

        #下面调用getlist()函数获取rooturl下所有章节的titleurl 和title 组成的列表

        urllist = getlist(rooturl)

        #href属性取得的url不完整 仅取出了完整url的右半段 因此下面for循环变量名起名righturl

        ID=0

        #对列表进行遍历 取 titleurl 和title

        for righturl in urllist:

            title = righturl[1]

            newurl = righturl[0]

            #urlparse 模块的urlparse.urljoin方法将righturl 按照rooturl格式拼接成完整url

            titleurl = urlparse.urljoin(rooturl, newurl)

            ID+=1

            print ID,title, titleurl

            cursor.execute("INSERT INTO  daomubiji values(%s,%s,%s)", (ID,title, titleurl))

            conn.commit()

        print "输入了"+ str(ID) +"条数据"

except MySQLdb.Error:

    print "连接失败!"
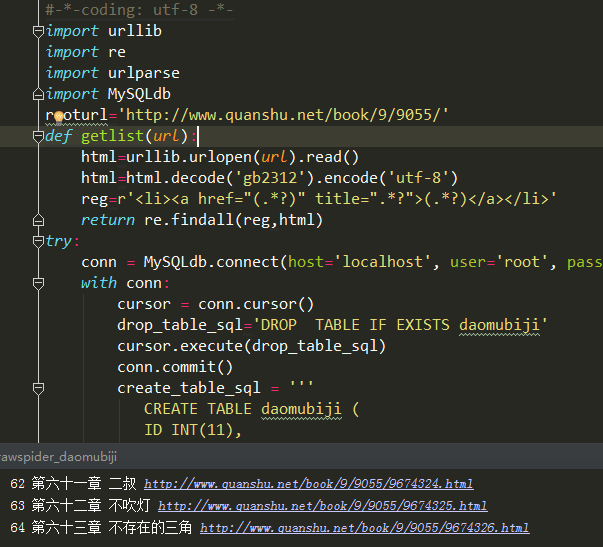
代码执行情况:
6、MySQL数据库查询是否导入成功
SELECT * FROM daomubiji
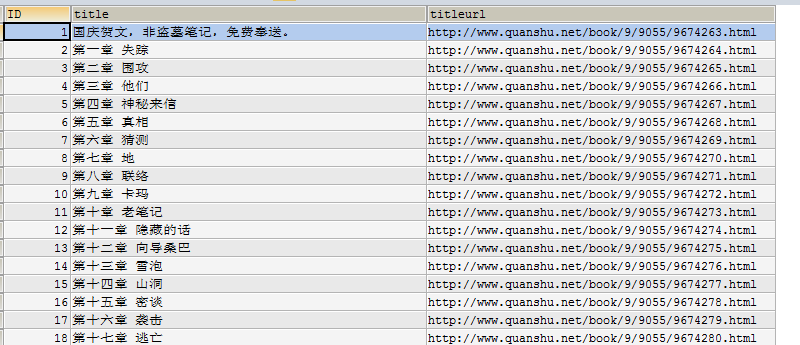
7、执行成功
python2.7 爬虫_爬取小说盗墓笔记章节及URL并导入MySQL数据库_20161201的更多相关文章
- python爬虫:爬取易迅网价格信息,并写入Mysql数据库
本程序涉及以下方面知识: 1.python链接mysql数据库:http://www.cnblogs.com/miranda-tang/p/5523431.html 2.爬取中文网站以及各种乱码处 ...
- Python实战项目网络爬虫 之 爬取小说吧小说正文
本次实战项目适合,有一定Python语法知识的小白学员.本人也是根据一些网上的资料,自己摸索编写的内容.有不明白的童鞋,欢迎提问. 目的:爬取百度小说吧中的原创小说<猎奇师>部分小说内容 ...
- 初次尝试python爬虫,爬取小说网站的小说。
本次是小阿鹏,第一次通过python爬虫去爬一个小说网站的小说. 下面直接上菜. 1.首先我需要导入相应的包,这里我采用了第三方模块的架包,requests.requests是python实现的简单易 ...
- Python网络爬虫_爬取Ajax动态加载和翻页时url不变的网页
1 . 什么是 AJAX ? AJAX = 异步 JavaScript 和 XML. AJAX 是一种用于创建快速动态网页的技术. 通过在后台与服务器进行少量数据交换,AJAX 可以使网页实现异步更新 ...
- xpath爬虫实战-爬取小说斗罗大陆第四部
爬取思路 用到的第三方库文件 lxml,requests,fake_agent 用fake_agent里的UserAgent修饰爬虫 用requests进行基本的请求 用lxml进行html的分析 用 ...
- python爬虫26 | 把数据爬取下来之后就存储到你的MySQL数据库。
小帅b说过 在这几篇中会着重说说将爬取下来的数据进行存储 上次我们说了一种 csv 的存储方式 这次主要来说说怎么将爬取下来的数据保存到 MySQL 数据库 接下来就是 学习python的正确姿势 真 ...
- scrapy爬取小说盗墓笔记
# -*- coding: utf-8 -*- import scrapy from daomu.items import DaomuItem class DaomuspiderSpider(scra ...
- scrapy进阶(CrawlSpider爬虫__爬取整站小说)
# -*- coding: utf-8 -*- import scrapy,re from scrapy.linkextractors import LinkExtractor from scrapy ...
- python爬虫——爬取小说 | 探索白子画和花千骨的爱恨情仇(转载)
转载出处:药少敏 ,感谢原作者清晰的讲解思路! 下述代码是我通过自己互联网搜索和拜读完此篇文章之后写出的具有同样效果的爬虫代码: from bs4 import BeautifulSoup imp ...
随机推荐
- js常见函数汇总
/** * 隐藏元素 * @param {String} elem */ function hide(elem){ var curDisplay = getStyle(elem, 'di ...
- 快速判断ie10及以上版本浏览器
if (!(/msie [6|7|8|9]/i.test(navigator.userAgent))){ //ie10以上 }; 快速判断ie10及以上版本浏览器
- Socket编程基础——无连接UDP
与面向连接的网络连接相比,无连接的网络通信不需要在服务器与客户端之间建立连接.面向非连接的Socket通信是基于UDP的,服务器端不需要调用listen()和accept()函数来等待客户端的连接:客 ...
- javascript confirm()函数的用法
javascript confirm()函数的用法 confirm():确认消息对话框.用于允许用户做选择的动作.弹出的对话框中包含一确定按钮和一取消按钮. confirm(str) 参数说明: st ...
- Error:Execution failed for task ':app:transformClassesWithInstantRunForDebug'. > java.lang.ClassNotFoundException: io.realm.RealmObject
这问题错误是在运行时出现的,A-Jiang大神有说明解决方法,大神网址:https://github.com/AndroidJiang/StockChart 如果是as2.0+,可能会出现instan ...
- Maven学习5-聚合与继承
一.聚合 如果我们想一次构建多个项目模块,那我们就需要对多个项目模块进行聚合 1.1.聚合配置代码 1 <modules> 2 <module>模块一</module&g ...
- sqlserver2008 ,只能选C盘目录,不能选其它盘目录
数据库sql2008安装后,无论备份或还原,只能看到C盘,手工输入路径,错误提示如下:尝试打开或创建物理文件 'D:\数据库\db.mdf' 时,CREATE FILE 遇到操作系统错误 5(拒绝访问 ...
- 优秀IT技术文章集(最新)(高质量)
作者:赵磊 博客:http://elf8848.iteye.com 阅读优秀的文章可以使你快速进步,本文收集了广受好评的优秀IT技术文章,在你有空时读一读,安静下来思考一下. 不断更新中... --- ...
- google protocol buffer 使用说明
一:编译源码 下载地址:http://code.google.com/p/protobuf/downloads/list 下载后,根据编译说明进行编译. windows 平台,直接打开msvc中的工程 ...
- FullCalendar只可以从外部拖入,内部不能互相拖动
startDrag: function(ev) { if(ev.originalEvent.initEvent){ return; } if (!this.isListening) { // star ...