
YARN安装和使用
简介
Yet Another Resource Negotiator ,负责整个集群资源的调度,和管理,支持多框架资源统一调度(HIVE spark flink)
开启yarn
安装hadoop,可以看我之前的博文 这边就不讲了
编辑 etc/hadoop/mapred-site.xml: 添加如下配置
<configuration>

	<property>

		<name>mapreduce.framework.name</name>

		<value>yarn</value>

	</property>

</configuration>
编辑 etc/hadoop/yarn-site.xml: 添加如下配置
<configuration>

	<property>

		<name>yarn.nodemanager.aux-services</name>

		<value>mapreduce_shuffle</value>

	</property>

</configuration>
启动 RM 和 NM
Start ResourceManager daemon and NodeManager daemon:

  $ sbin/start-yarn.sh
关闭Yarn
sbin/stop-yarn.sh
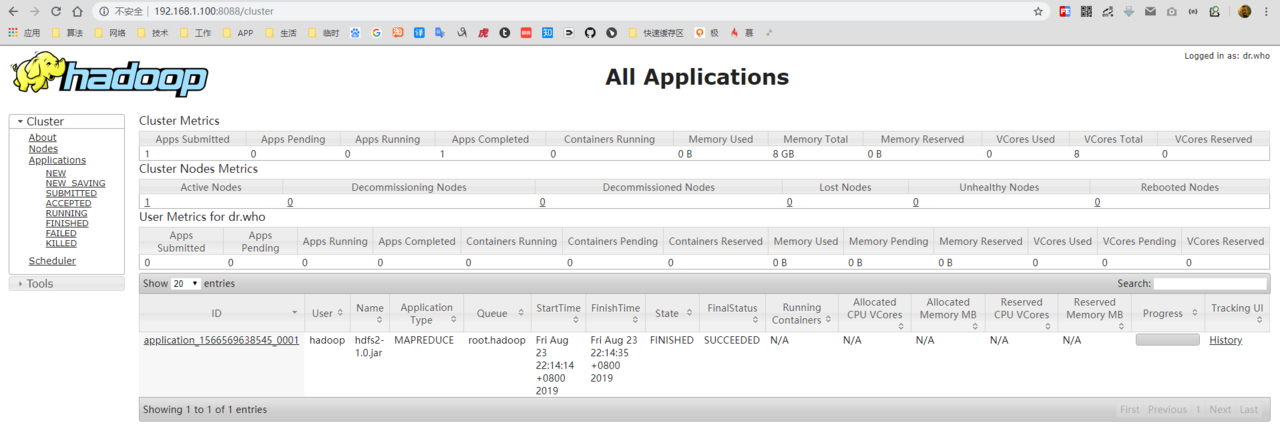
打开浏览器访问:http://192.168.1.100:8088/cluster
模块简介
ResourceManager (RM)
客户端提交作业到 RM, RM对应多个 NM ,RM是集群中对外提供的服务,同一时刻只有一个负责资源相关处理,客户端任务来了之后,先启动AM 然后监控AM。 并且还监控NM
ApplicationMaster(AM)
运行在NodeManager里面的,去RM里面申请资源用于在NM上启动对应的task ,每个应用程序对应一个AM.。 并且做数据的切分,为每个task向RM申请资源。并且和NM通信。
NodeManager(NM)
真正工作计算的节点,同时向RM发送心跳信息 任务执行情况。接受来自RM的请求 并且处理AM的命令。
Container
对于任务的运行抽象,一个Container既可以运行AM 也可以运行具体的 map 和 reduce
yarn的基本流程
- client向yarn提交job,首先找ResourceManager分配资源,
- ResourceManager开启一个Container,在Container中运行一个Application manager
- Application manager找一台nodemanager启动Application master,计算任务所需的计算
- Application master向Application manager(Yarn)申请运行任务所需的资源
- Resource scheduler将资源封装发给Application master
- Application master将获取到的资源分配给各个nodemanager
- 各个nodemanager得到任务和资源开始执行map task
- map task执行结束后,开始执行reduce task
- map task和 reduce task将执行结果反馈给Application master
- Application master将任务执行的结果反馈application manager
把作业提交到 yarn上面
自己的MapReduce 首先打成个jar包 传到服务器 然后执行
hadoop jar xxx.jar me.liangtian.App param1 param2
问题排查
我这边一直报错: **Exceeded MAX_FAILED_UNIQUE_FETCHES; bailing-out. **
可能是下面几点造成的
- 系统设置有关,文件较大,无法分配大内存
- 机器位数是64位导致这个问题
- /etc/hosts 里面没有配master的hostname
- 防火墙没关
- 临时目录问题
问题1我安装网上方法,对配置文件做了修改: vim /etc/security/limits.conf 加入 * soft nofile 102400 * hard nofile 409600 vim /etc/pam.d/login 加入:session required /lib/security/pam_limits.so但是还是没有办法解决
问题三:由于我是伪分布式,所以只要配本机就行,看了下配置了hostname
问题四:setup下看了我的防火墙,发现防火墙有两个,一个是firework一个是selinux,第一个关了,第二个没关 关了还是不行
最后发现是问题五: yarn.nodemanager.local-dirs对应的路径必须在hdfs-site.xml中的hadoop.tmp.dir路径下,否则yarn会报错找不到缓存文件 需要修改 yarn-site.xml 加上对应的文件目录
<property>

	<name>yarn.nodemanager.local-dirs</name>

	<value>hadoop.tmp.dir/nm-local-dir</value>

</property>
YARN安装和使用的更多相关文章
- npm、cnpm、yarn 安装删除异同
背景 一直觉得npm.cnpm.yarn的安装删除基本一样用哪个都行,不过俗话说的好,实践出真知,这里记录一下今天简单测试得到的结果总结. 可能会有错误,希望大家评论指正,十分感谢. 测试电脑系统:M ...
- Apache Hadoop集群离线安装部署(二)——Spark-2.1.0 on Yarn安装
Apache Hadoop集群离线安装部署(一)——Hadoop(HDFS.YARN.MR)安装:http://www.cnblogs.com/pojishou/p/6366542.html Apac ...
- 关于yarn安装,这里做一个备份
安装的是window版本,官网上有三种安装方式. 第一种下载一个.msi的安装包,然后当它运行时会指引你将 Yarn 安装到 Windows 上,因为点开以后页面是404,所以没有用这种方法. 第二种 ...
- 什么是yarn,如何使用yarn安装项目依赖
一.yarn的简介: Yarn是facebook发布的一款取代npm的包管理工具. 二.yarn的特点: 1.速度超快. Yarn 缓存了每个下载过的包,所以再次使用时无需重复下载. 同时利用并行下载 ...
- 关于npm和yarn 安装vue脚手架
第一篇博客有点小紧张.轻喷~ 第一步:安装node.js 地址 --------https://nodejs.org/en/ 详细步骤这里就不写了 可以去看 地址 ----- ...
- Storm on Yarn 安装配置
1.背景知识 在不修改Storm任何源代码的情况下,让Storm运行在YARN上,最简单的实现方法是将Storm的各个服务组件(包括Nimbus和Supervisor),作为单独的任务运行在YARN上 ...
- yarn安装部署
在HDFS HA(http://www.cnblogs.com/yinchengzhe/p/5140117.html)基础上进行yarn的安装. 1.配置yarn-site.xml 参数详情参考 ht ...
- Hadoop 2.x(YARN)安装配置LZO
今天尝试在Hadoop 2.x(YARN)上安装和配置LZO,遇到了很多坑,网上的资料都是基于Hadoop 1.x的,基本没有对于Hadoop 2.x上应用LZO,我在这边记录整个安装配置过程 1. ...
- Hadoop Yarn 安装
环境:Linux, 8G 内存.60G 硬盘 , Hadoop 2.2.0 为了构建基于Yarn体系的Spark集群.先要安装Hadoop集群,为了以后查阅方便记录了我本次安装的详细步骤. 事前准备 ...
随机推荐
- 利用AppMetrics对Web进行监控教程
利用AppMetrics对Web进行监控教程 一.基础准备 1. 安装依赖 这里可以通过nuget或使用命令行进行安装,具体需要安装的类库如下(注意版本): Install-Package App.M ...
- pandas 使用总结
import pandas as pd import numpy as np ## 从字典初始化df ipl_data = {'Team': ['Riders', 'Riders', 'Devils' ...
- Codeforces_101498
A.map统计数量,更新最大值. #include<bits/stdc++.h> using namespace std; int n; map<int,int> mp; in ...
- layui父子页面方法互调
父级页面调用子页面方法 layer.open({ type: 2, content: 'test/iframe.html', success: function(layero, index){ var ...
- 《C# 爬虫 破境之道》:第二境 爬虫应用 — 第六节:反爬策略研究
之前的章节也略有提及反爬策略,本节,我们就来系统的对反爬.反反爬的种种,做一个了结. 从防盗链说起: 自从论坛兴起的时候,网上就有很多人会在论坛里发布一些很棒的文章,与当下流行的“点赞”“分享”一样, ...
- C++用rand()和srand()生成随机数
内容来自<编程实战宝典> 首先来看函数原型 int rand(void); void srand(unsigned int seed); 1.rand()函数不需要任何参数,直接返回一个随 ...
- 幸存者偏差Survivorship Bias
"最不符合逻辑的地方,一定埋藏着最深刻的逻辑."——余秋雨<行者无疆> 为什么要说幸存者偏差? 因为2018年全国II卷的描述即为典型的“幸存者偏差”,且这一例子被引入 ...
- postman批量接口测试/批量导入/批量参数化简要全过程及遇到问题处理方法
简单说明下postman批量接口调用的过程及注意事项: 1.报文调试(建议先调通再批量执行,统筹安排时间) 2.参数化,例如: "address": "{{address ...
- 数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)
一.二次排序问题. MR/hadoop两种方案: 1.让reducer读取和缓存给个定键的所有值(例如,缓存到一个数组数据结构中,)然后对这些值完成一个reducer中排序.这种方法不具有可伸缩性,因 ...
- Angular RxJs:针对异步数据流编程工具
一. RxJs:针对异步数据流编程工具 1. 创建subject类对象(发送方) 2. subject.subscribe(观察者); (注册观察者对象observer,可以注册多个相当于回调函数取数 ...