
数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)
一、二次排序问题。

MR/hadoop两种方案:
1.让reducer读取和缓存给个定键的所有值(例如,缓存到一个数组数据结构中,)然后对这些值完成一个reducer中排序。这种方法不具有可伸缩性,因为reducer要接受一个给定键的所有值,这种方法可能导致reducer的内存耗尽(OOM)。另一方面,如果值数量很少,就不会导致内存溢出,那么这种方法可行。
2.使用MR框架对reducer的值排序(这样一来,就不再需要对传入reducer的值完成排序。)这种方法“会为自然键增加部分或整个值来创建一个组合键以实现排序目标”(参考 java Code Geeks)。这种方法可伸缩,不会产生内存溢出错误。在这里,排序工作基本上由MR框架来完成。
使用MR框架的二次排序设计模式,规约器值到达时就是有序地。(也就是说,不再需要在内存中对值进行排序)。这种技术使用了MR框架的洗牌和排序技术完成规约器值的排序。这种解决方案比1更可取,不再依赖内存完成排序。
思考分析:对返回数据形式进行分析,自定义对象和reducer的分区策略。(当然为了实现排序,要对自定义的对象进行实现comparele接口,重写compare方法。)
spark两种方案:
1.将一个给定键的所有值读取缓存到一个List数组结构中,然后对这些值完成排序。优缺点同MR方案1.
2.使用Spark框架对规约器值排序(这种做法不需要对传入规约器的值完成规约器中排序)。这种方法“会为自然建增加部分或整个值来创建一个组合键以实现排序目标。”
二。 Top N问题。
列表L的TopN 算法大致描述:L列表的元素是一个scala的tuple结构,通过java的TreeMap将一个tuple添加到其中,然后对TreeMap进>N的if操作,来进行remove操作。
1.唯一键。
例子:
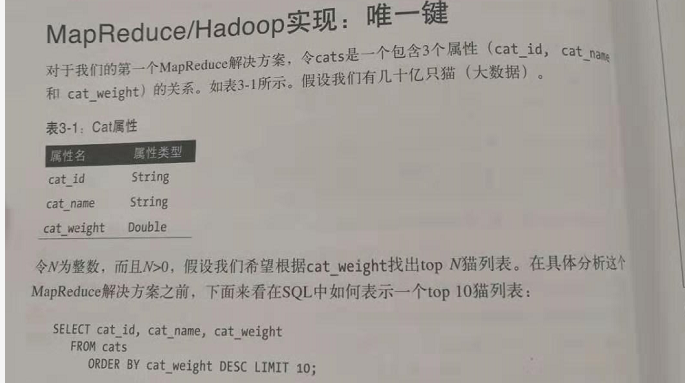
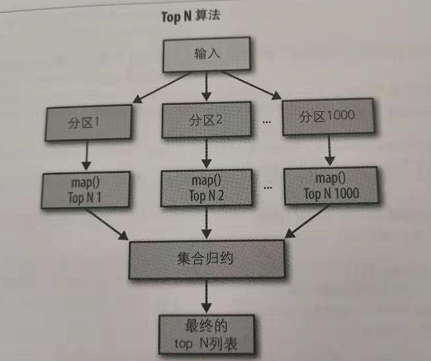
在这个问题上,可以使用一个规约器完成对所有数据的接收,所有压力和负载全部是都在这一个节点上。在这里不糊带来性能问题,为什么呢。假设有由1000个映射,每个映射器只会生成10个键值对,因为,这个规约器只会得到10*1000个记录,这个数据量还不至于导致性能瓶颈。
2.非唯一键
例子:
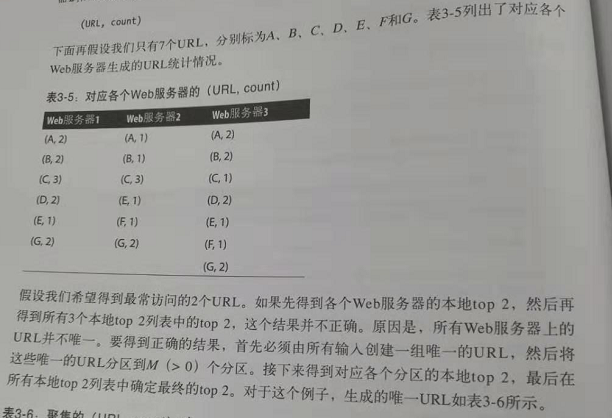
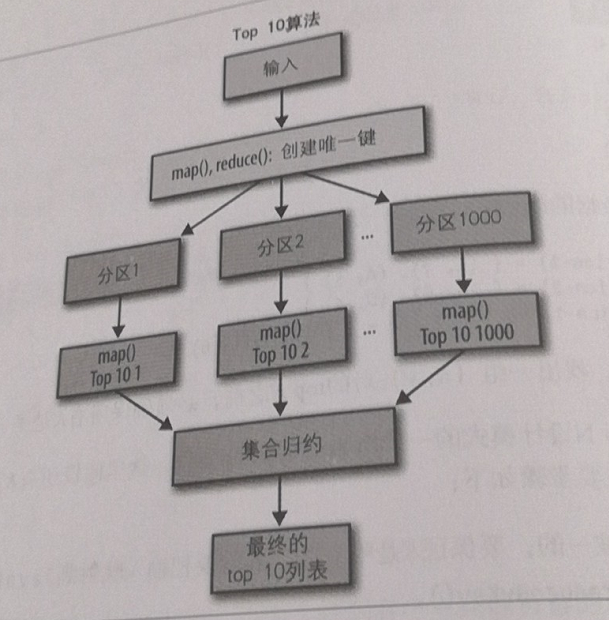
topN设计模式:这里假设所有K不是唯一的,主要步骤:
①。确保所有K是唯一的。要保证K是唯一的(存在不唯一的,直接把相同的K的V相加。),我们要把输入映射到JavaPairRDD<K,V>对,然后交给reduceByKey().
②。将所有唯一的(K,V)对划分为M个分区。
③。找出个个分区的Top N。
④。找出所有本地topN的最终top N.
数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)的更多相关文章
- 数据算法 --hadoop/spark数据处理技巧 --(5.移动平均 6. 数据挖掘之购物篮分析MBA)
五.移动平均 多个连续周期的时间序列数据平均值(按相同时间间隔得到的观察值,如每小时一次或每天一次)称为移动平均.之所以称之为移动,是因为随着新的时间序列数据的到来,要不断重新计算这个平均值,由于会删 ...
- 数据算法 --hadoop/spark数据处理技巧 --(9.基于内容的电影推荐 10. 使用马尔科夫模型的智能邮件营销)
九.基于内容的电影推荐 在基于内容的推荐系统中,我们得到的关于内容的信息越多,算法就会越复杂(设计的变量更多),不过推荐也会更准确,更合理. 本次基于评分,提供一个3阶段的MR解决方案来实现电影推荐. ...
- 数据算法 --hadoop/spark数据处理技巧 --(11.K-均值聚类 12. k-近邻)
十一.k-均值聚类 这个需要MR迭代多次. 开始时,会选择K个点作为簇中心,这些点成为簇质心.可以选择很多方法啦初始化质心,其中一种方法是从n个点的样本中随机选择K个点.一旦选择了K个初始的簇质心,下 ...
- 数据算法 --hadoop/spark数据处理技巧 --(3.左外连接 4.反转排序)
三. 左外连接 考虑一家公司,比如亚马逊,它拥有超过2亿的用户,每天要完成数亿次交易.假设我们有两类数据,用户和交易: users(user_id,location_id) transactions( ...
- 数据算法 --hadoop/spark数据处理技巧 --(17.小文件问题 18.MapReuce的大容量缓存)
十七.小文件问题 十八.MR的大容量缓存 在MR中使用和读取大容量缓存,(也就是说,可能包括数十亿键值对,而无法放在一个商用服务器的内存中).本次提出的算法通用,可以在任何MR范式中使用.(eg:MR ...
- 数据算法 --hadoop/spark数据处理技巧 --(13.朴素贝叶斯 14.情感分析)
十三.朴素贝叶斯 朴素贝叶斯是一个线性分类器.处理数值数据时,最好使用聚类技术(eg:K均值)和k-近邻方法,不过对于名字.符号.电子邮件和文本的分类,则最好使用概率方法,朴素贝叶斯就可以.在某些情况 ...
- 数据算法 --hadoop/spark数据处理技巧 --(15.查找、统计和列出大图中的所有三角形 16.k-mer计数)
十五.查找.统计和列出大图中的所有三角形 第一步骤的mr: 第二部mr: 找出三角形 第三部:去重 spark: 十六: k-mer计数 spark:
- 数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)
七,共同好友. 在所有用户对中找出“共同好友”. eg: a b,c,d,g b a,c,d,e map()-> <a,b>,<b,c,d,g> ;< ...
- 哈,我自己翻译的小书,马上就完成了,是讲用python处理大数据框架hadoop,spark的
花了一些时间, 但感觉很值得. Big Data, MapReduce, Hadoop, and Spark with Python Master Big Data Analytics and Dat ...
随机推荐
- rest实践2
通过url读取图片资源 其他的上传图片和对应的添加信息到数据库等的相关操作则引入crud来操作,编写相关代码的话==>要引入相关的crud包.
- python方法的重写
方法的重写: 在子类中重写定义一个父类拥有的方法, 调用时使用子类中重写定义的方法. 效果图: 代码: class Animal: def run(self): print('动物会跑~~~') de ...
- C# 中 ConfigureAwait 相关答疑FAQ
C# 中 ConfigureAwait 相关答疑FAQ 在前段时间经常看到园子里有一些文章讨论到 ConfigureAwait,刚好今天在微软官方博客看到了 Stephen Toub 前不久的一篇答疑 ...
- CF - 一直交换元素的规律
Dima is a beginner programmer. During his working process, he regularly has to repeat the following ...
- 获取当前URL
HttpContext.Current.Request.Url.ToString();
- 关于爬虫的日常复习(3)—— request库
- java面试题-spring篇
这次是关于spring的面试题,和上次一样依旧挑了几个具有代表性的. 一. 谈谈你对 Spring 的理解 Spring 是一个开源框架,为简化企业级应用开发而生.Spring 可以是使简单的 Ja ...
- ORM执行原生SQL语句
# 1.connectionfrom django.db import connection, connections cursor = connection.cursor() # cursor = ...
- c#数字图像处理(四)线性点运算
灰度图像的点运算可分为线性点运算和非线性点运算两种.4.1线性点运算定义线性点运算就是输出灰度级与输入灰度级呈线性关系的点运算.在这种情况下,灰度变换函数的形式为: g(x, y)=pf(x,y)+L ...
- 'NoneType' object has no attribute shape
使用cv2读取图片时,输出图片形状大小时出现报错“ 'NoneType' object has no attribute shape”,后来排查发现读取图片的返回值image为None, 这就说明图片 ...