
Coursera, Deep Learning 4, Convolutional Neural Networks, week3, Object detection
学习目标
- Understand the challenges of Object Localization, Object Detection and Landmark Finding
- Understand and implement non-max suppression
- Understand and implement intersection over union
- Understand how we label a dataset for an object detection application
- Remember the vocabulary of object detection (landmark, anchor, bounding box, grid, ...)
Objective Localization
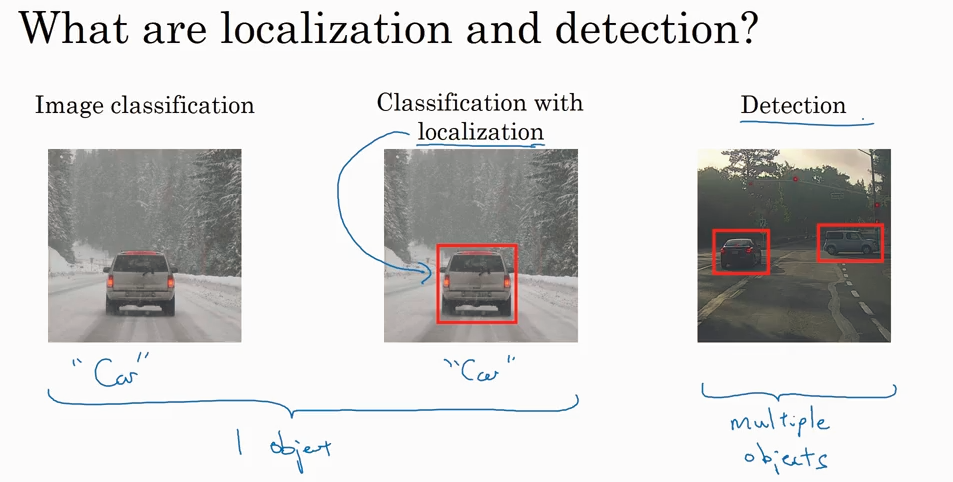
分类,分类加定位,检测。前两种问题都是针对一个object, detection 是针对多个object
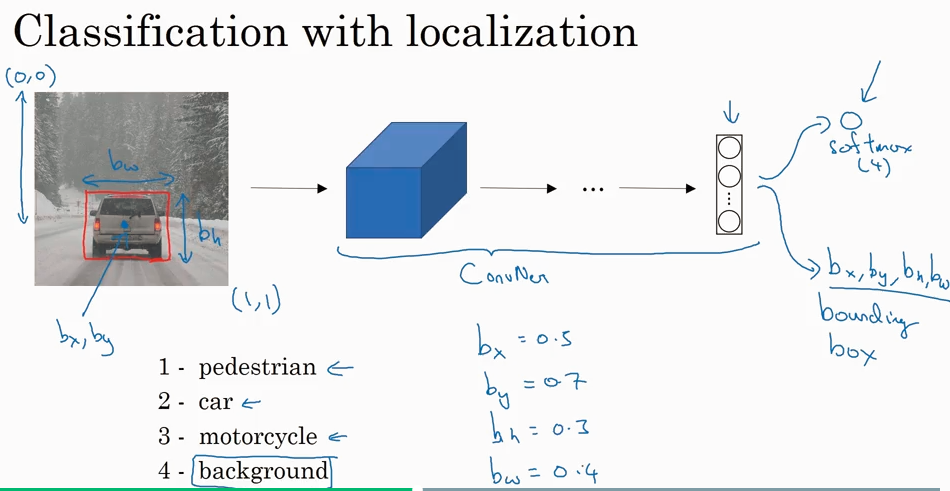
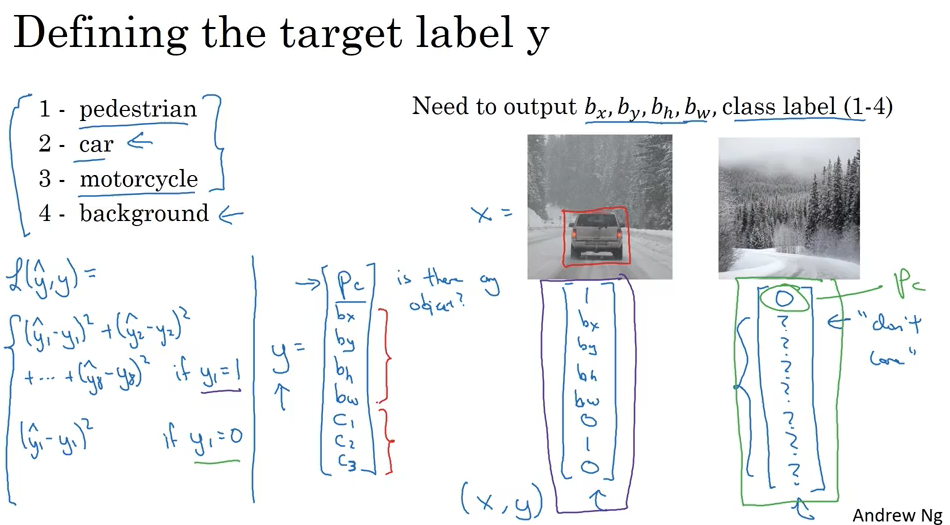
在classification with localization 问题中,就是在output 的 softmax 输出的基础上在加了4个参数来定位bounding box.
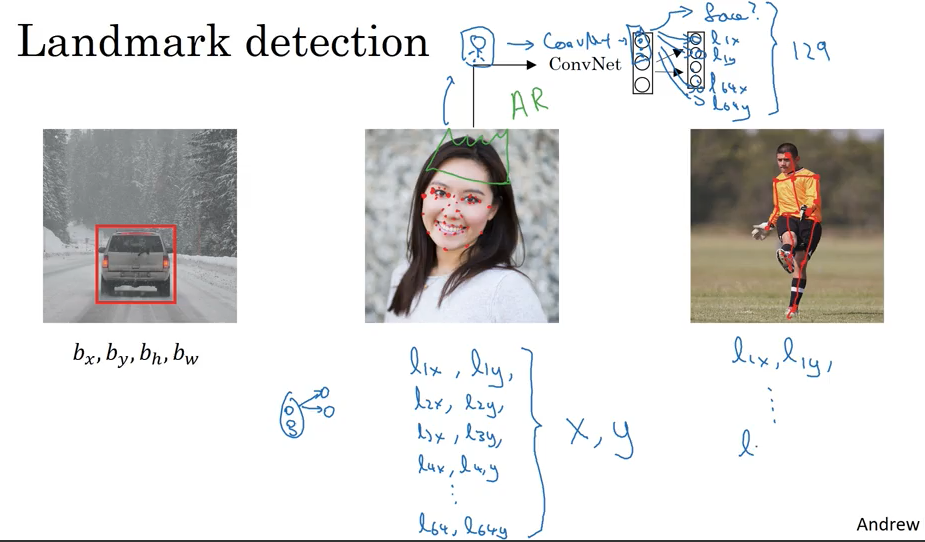
Landmark detection
Object detection
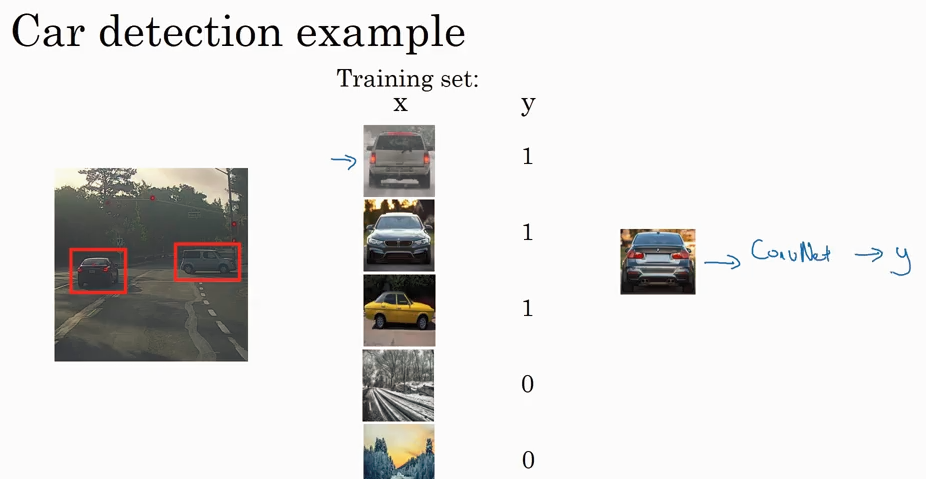
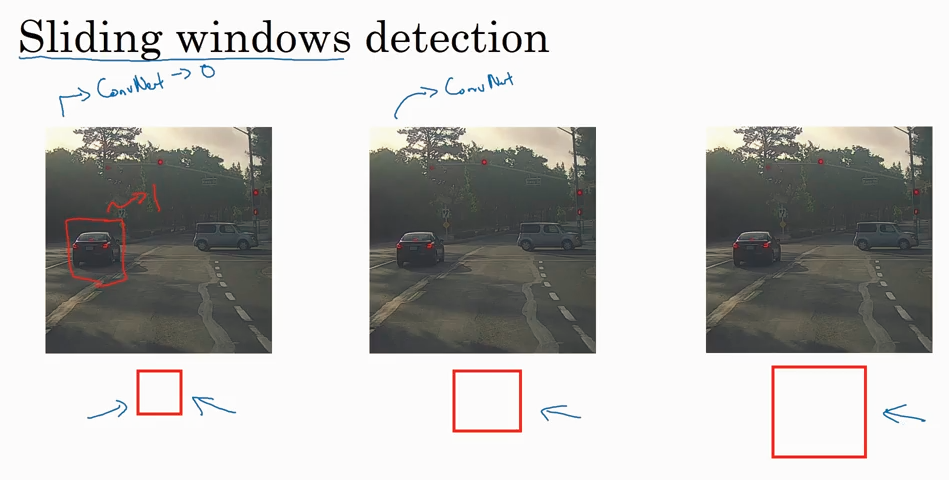
Sliding windown detection 算法最大的缺点是computational cost. 在早期人们用简单的线性分类器去分类的时候还好,现在用conv net 去分类尤其在stride 很小的情况下就cost太高了。幸运的是这个问题有办法解决. 接着往下看
Convolutional implementation of Sliding Windows
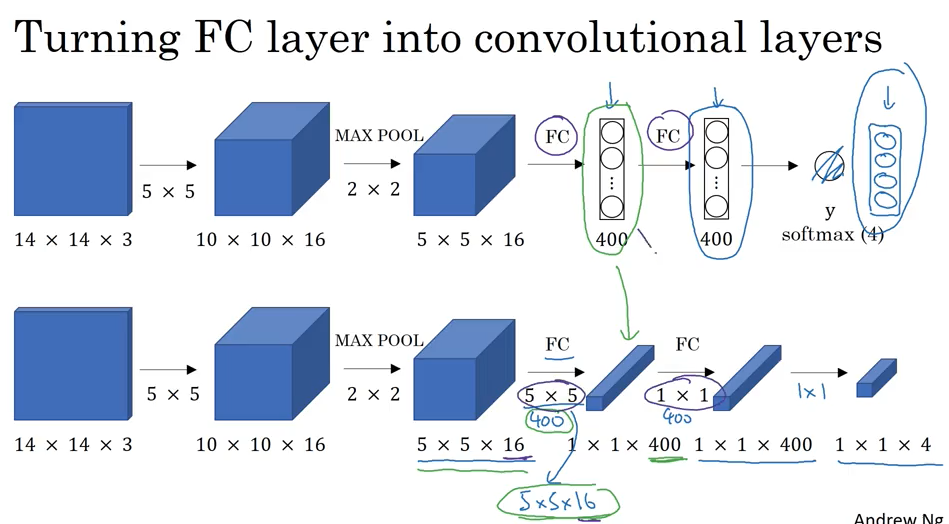
下图表示了怎么把fully connected layer 转化为convolutional layer.
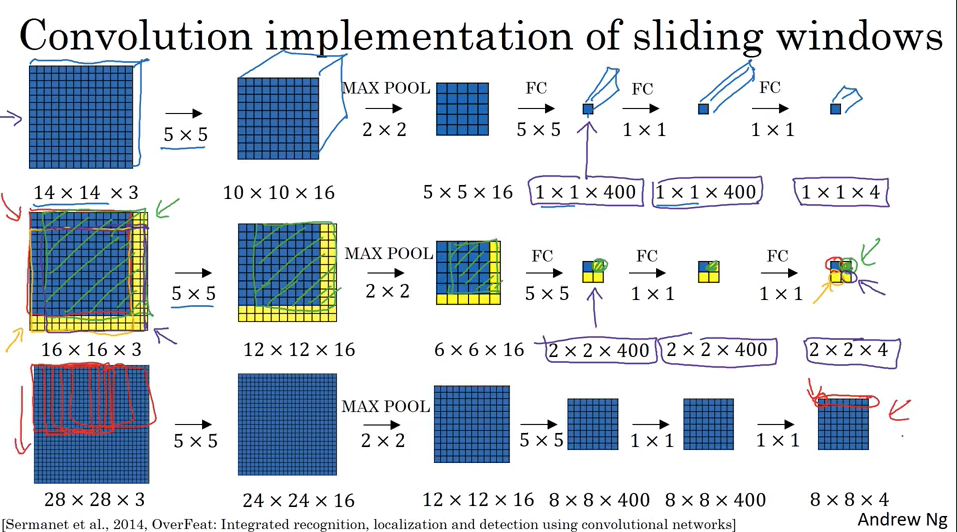
下面显示4次计算高度重复,下图第二行演示了使用第一行训练出来的filter parameter 去预测label,这样可以图像的share的重合的部分,极大提高计算效率。Convolutional 实现可以一次性求出结果而不是循环很多次.
现在还剩一个问题就是只考虑了分类问题没有考虑定位localization问题. 那么怎么定位呢,我们很容易想到前面介绍的classification+localization, 请继续往下看。
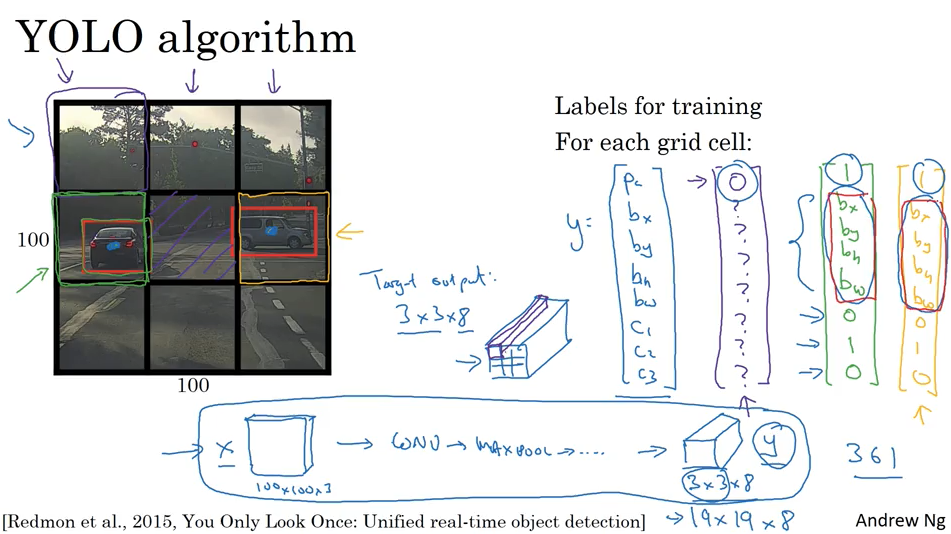
下图演示了用3x3的分割来做分类和定位,实际工作中会更细的分割,比如19x19。
一个对象的midpoint在哪个cell里,就说这个对象属于哪个cell.
YOLO 算法
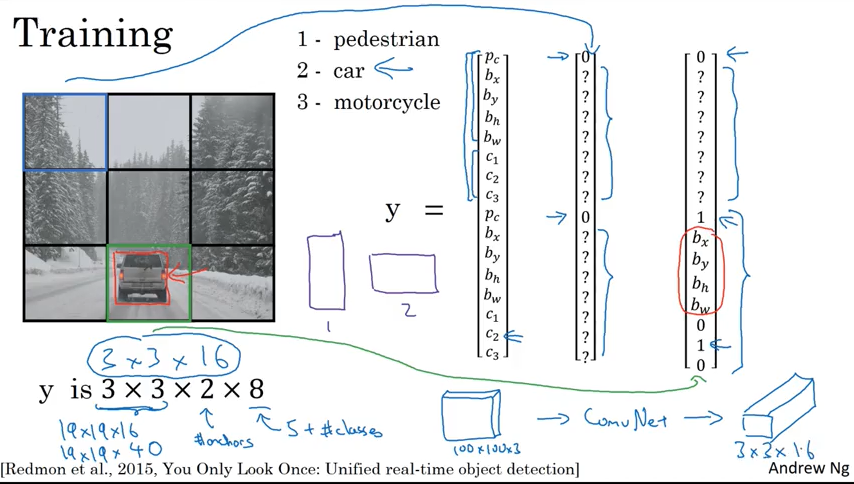
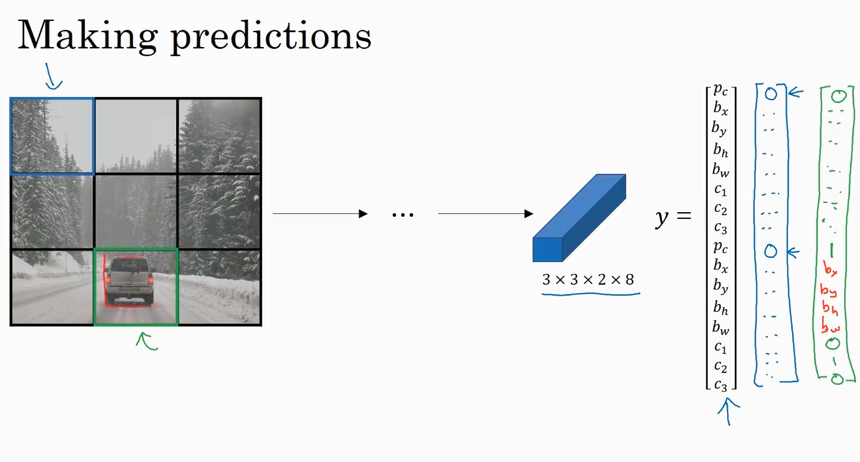
YOLO 算法就是前面介绍的知识点的集成,对每一个小方框使用了classification+localization, 然后对整个9个小方框并没有循环,而是使用了convolutional 实现一次性计算。
YOLO 算法能更精确的预测bounding box. 因为解决了不能正好框住object的问题.
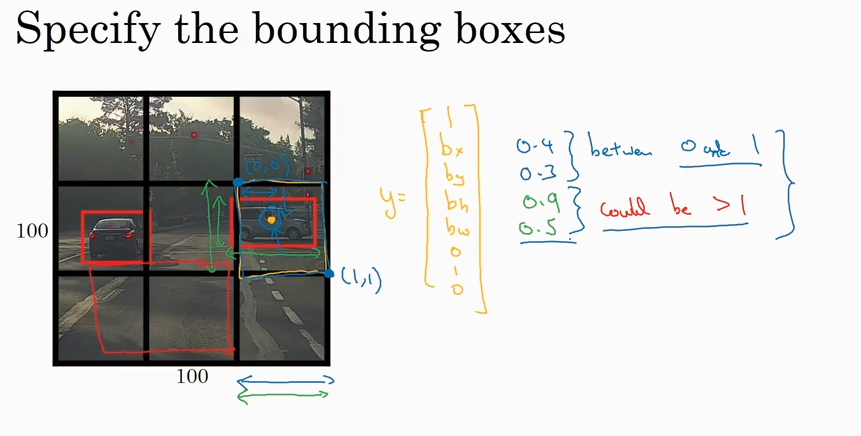
bounding box 的encoding. bh, bw 是和小框边长的比例,可以>1.
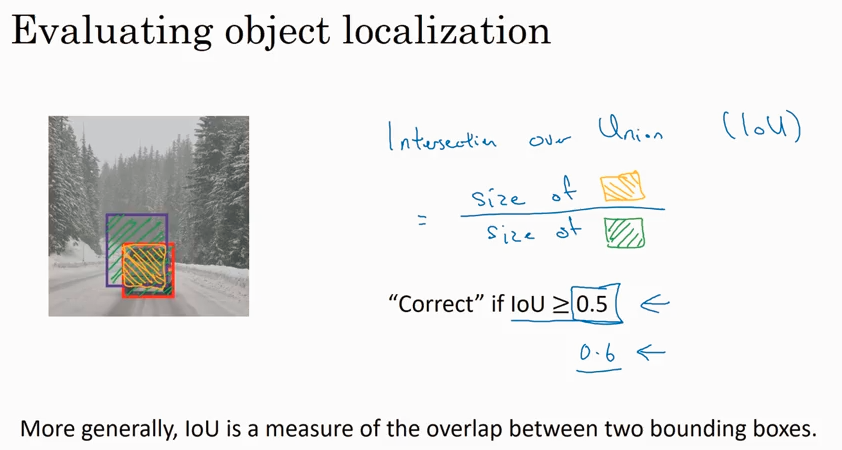
IoU (Intersection over Union)
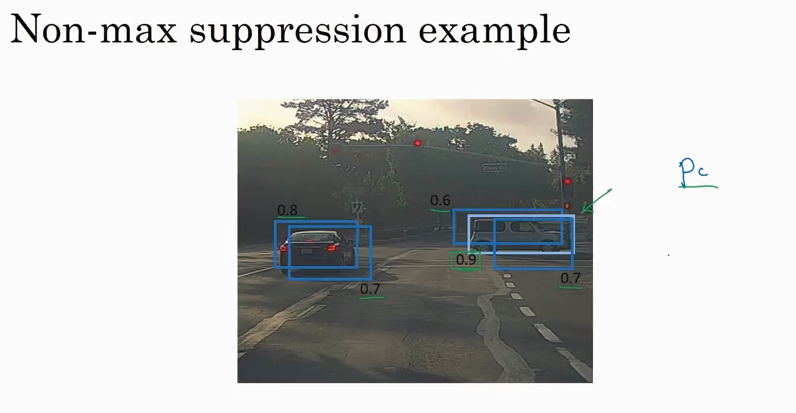
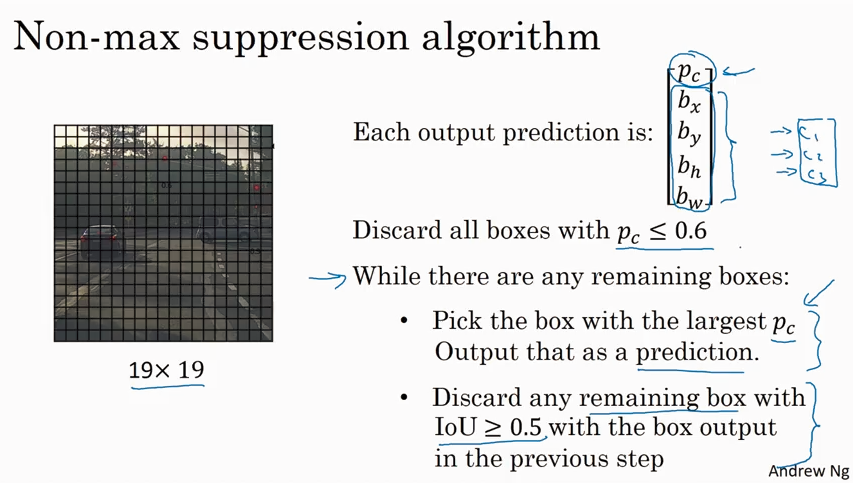
Non-max suppression
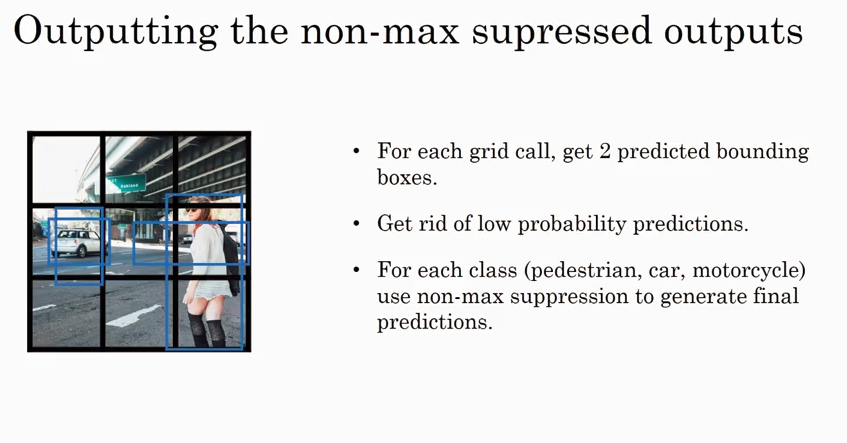
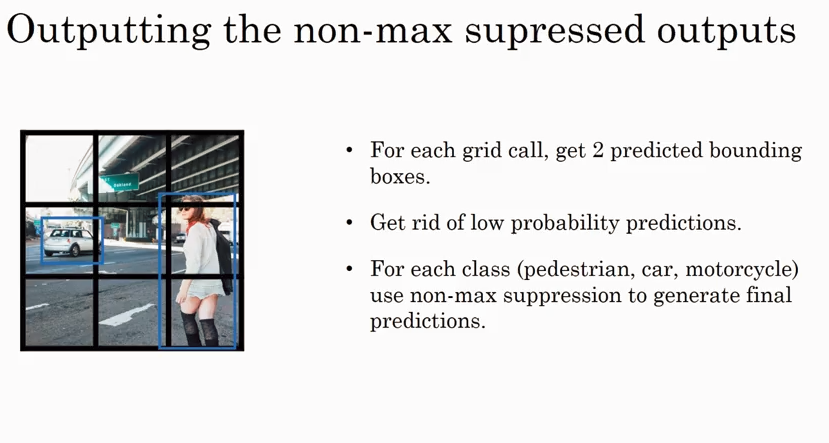
解决同一个对象被多次检测到的情况, 去除那些可能性小的bounding box 只留下最可能的
Anchor Boxes
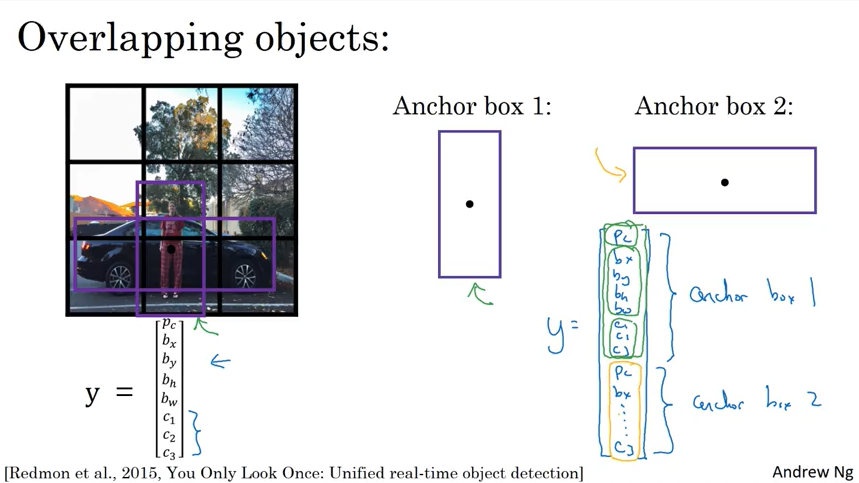
Anchor Boxes 是干什么的?- 使得可以检测多个Object.
为什么之前讲的就是一个cell 只能检测一个Object呢?因为一个y 向量里面只有一个bounding box.
学习过程了产生了一个问题,为什么一定要预定义一些Anchor Box呢?直接像只处理单个Object那样测量一个bounding box, 只不过对多个object的情况测量多个bounding box 不就行了吗? 这里加一些个人理解,我觉得测量多个bounding box这样做也可以,本质上来说Anchor Box 就是bounding box, 只是Anchor Box 尺寸固定更加容易对input 图片标注. 纯属个人理解,希望有人看到这里指教一下.
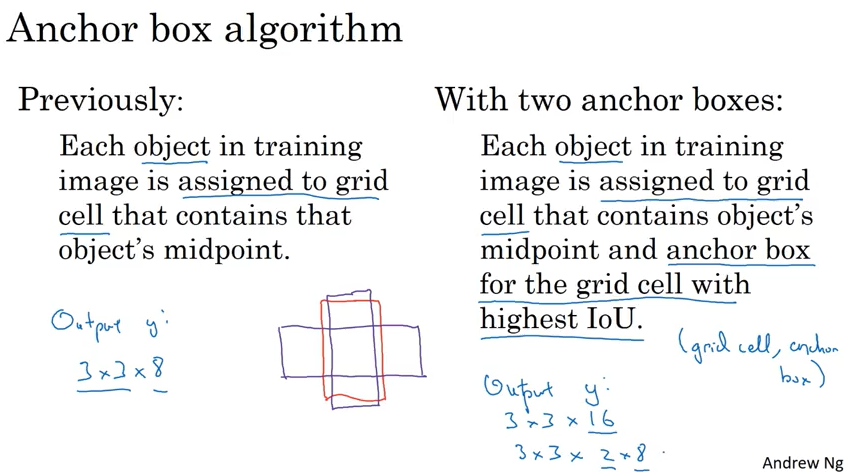
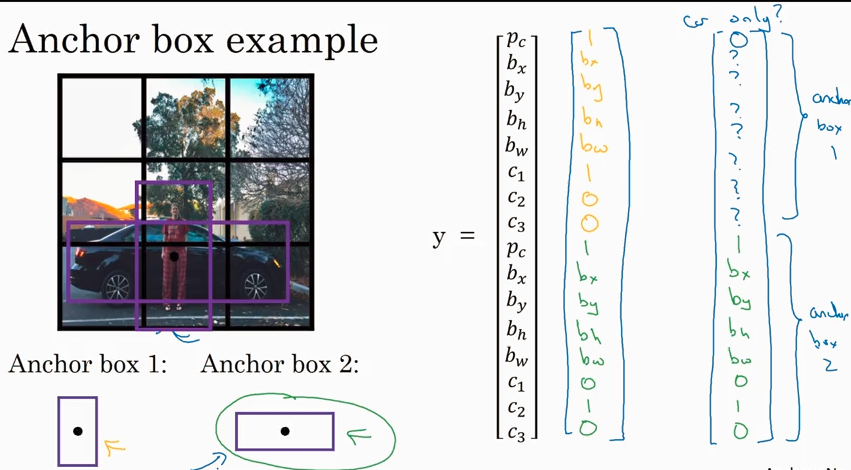
怎么选Anchor box呢?
人们一般手动选择5-10个可以cover 待检测对象的box. 更好的做法是用K-means算法来归类待检测对象,然后自动选出anchor box.
YOLO Algorithm
前面讲了核心的 YOLO算法,然后又讲了一个特殊情况的处理,已经一个对象多次被检测到的情况就需要 non-max suppression, 多个对象共同属于一个cell的情况就需要 Anchor Box. 所以这里集成了完整的YOLO算法.
R-CNN
Region CNN - 忽略一些明显没有用的grid cell
Coursera, Deep Learning 4, Convolutional Neural Networks, week3, Object detection的更多相关文章
- Coursera, Deep Learning 4, Convolutional Neural Networks - week1
CNN 主要解决 computer vision 问题,同时解决input X 维度太大的问题. Edge detection 下面演示了convolution 的概念 下图的 vertical ed ...
- Coursera, Deep Learning 4, Convolutional Neural Networks - week4,
Face recognition One Shot Learning 只看一次图片,就能以后识别, 传统deep learning 很难做到这个. 而且如果要加一个人到数据库里面,就要重新train ...
- Coursera, Deep Learning 4, Convolutional Neural Networks - week2
Case Study (Note: 红色表示不重要) LeNet-5 起初用来识别手写数字灰度图片 AlexNet 输入的是227x227x3 的图片,输出1000 种类的结果 VGG VGG比Ale ...
- Deep Learning Tutorial - Convolutional Neural Networks(LENET)
CNN很多概述和要点在CS231n.Neural Networks and Deep Learning中有详细阐述,这里补充Deep Learning Tutorial中的内容.本节前提是前两节的内容 ...
- 论文笔记之:Learning Multi-Domain Convolutional Neural Networks for Visual Tracking
Learning Multi-Domain Convolutional Neural Networks for Visual Tracking CVPR 2016 本文提出了一种新的CNN 框架来处理 ...
- [CVPR2015] Is object localization for free? – Weakly-supervised learning with convolutional neural networks论文笔记
p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 13.0px "Helvetica Neue"; color: #323333 } p. ...
- 【论文阅读】Learning Dual Convolutional Neural Networks for Low-Level Vision
论文阅读([CVPR2018]Jinshan Pan - Learning Dual Convolutional Neural Networks for Low-Level Vision) 本文针对低 ...
- 【DeepLearning学习笔记】Coursera课程《Neural Networks and Deep Learning》——Week2 Neural Networks Basics课堂笔记
Coursera课程<Neural Networks and Deep Learning> deeplearning.ai Week2 Neural Networks Basics 2.1 ...
- 论文阅读:MDNet: Learning Multi-Domain Convolutional Neural Networks for Visual Tracking
前言 CVPR2016 来自Korea的POSTECH这个团队 大部分算法(例如HCF, DeepLMCF)只是用在大量数据上训练好的(pretrain)的一些网络如VGG作为特征提取器,这些做法 ...
随机推荐
- java ee Concurrency 并发编程
https://www.javacodegeeks.com/2014/07/java-ee-concurrency-api-tutorial.html This is a sample chapter ...
- iview 模态框点击确定按钮不消失
<div slot="footer"> <Button type="text" size="large" @click=& ...
- 封装一个基于NLog+NLog.Mongo的日志记录工具类LogUtil,nloglogutil
封装一个基于NLog+NLog.Mongo的日志记录工具类LogUtil,代码比较简单,主要是把MongoTarget的配置.FileTarget的配置集成到类中,同时利用缓存依赖来判断是否需要重新创 ...
- iconv: iconv_open(pToCharset, pFromCharset); 的附加参数//IGNORE
今天在转换一个文件时iconv() 老是返回 -1, 提示编码转换失败. 一共 30 多个文件, 原编码都是一样的,为什么有的转换会失败,返回 -1呢? 网上搜索了一下, 找到一个随加参数: //IG ...
- webpack 非严格模式设置 npm i babel-plugin-transform-remove-strict-mode
安装插件:npm i babel-plugin-transform-remove-strict-mode 在.babelrc文件的插件项添加:"transform-remove-strict ...
- django2+uwsgi+nginx上线部署到服务器Ubuntu16.04(最新最详细版)
1.前期准备 1.打开Terminal终端,执行以下命令,将项目所需要的依赖包,都记录到一个文件内备用. pip freeze >requirements.txt 2.将项目文件夹→右键→添加压 ...
- pycharm 出现 "PEP:8 expected 2 blank lines ,found 0"
https://blog.csdn.net/modangtian/article/details/79687623 这句话的意思是“有两个空白行,但是没有发现.” 在声明函数的那一行的上方必须有两行的 ...
- JS数据交换的三种方式
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- jq实现百度图片移入移出内容提示框上下左右移动的效果
闲来无聊,看到百度图片hover的时候提示框的效果,遂想试一试自己能否实现. 百度图片hover的效果: 需求: 1. 当鼠标从图片上部移入的时候,提示框从上部移到正常位置.从上部移出的时候,提示框从 ...
- Mysql查询数据库 整理
一. 查询数据: 查询所有列:SELECT * FROM student; 查询指定列:SELECT id,NAME,gender FROM student; 格式:select字段名, ...