
Python数据科学手册-Pandas数据处理之简介
Pandas是在Numpy基础上建立的新程序库,提供了一种高效的DataFrame数据结构
本质是带行标签 和 列标签、支持相同类型数据和缺失值的 多维数组
增强版的Numpy结构化数组
行和列不在只是简单的整数索引,还可以带上标签,
- 三个基本数据结构
Series DataFrame Index
Series
Series将一组数据和一组索引绑定在一起
可以通过values 和 index属性获取数据,
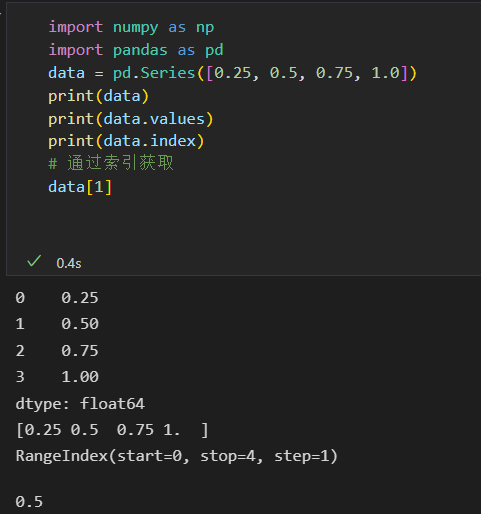
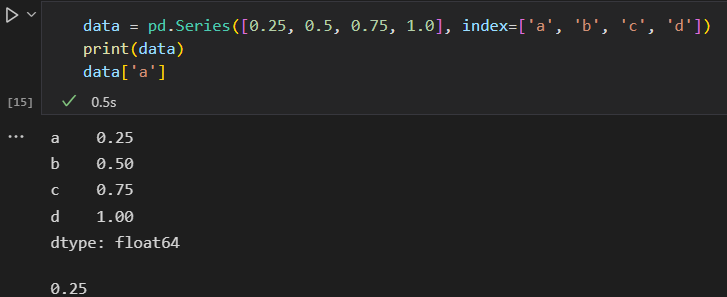
与Numpy数据的区别:Numpy数组通过隐式定义的整数索引获取数值,Pandas 的Series用显示定义的索引与数值关联
Series是特殊的字典
字典是一种将任意键映射到一组任意值的数据结构
Series对象是一种将类型键映射到一组类型值 的数据结构, 类型至关重要。
因为有类型信息,所以比Python字典更高效
可以直接使用Python字典创建一个Series对象
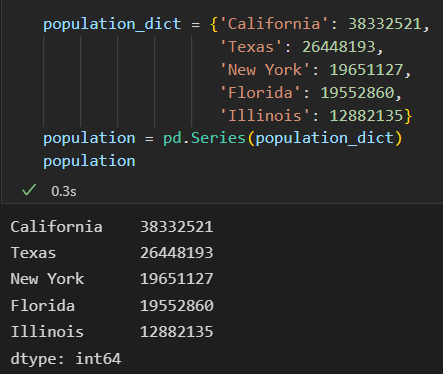
- 和字典不同,Series对象还支持数组形式的操作
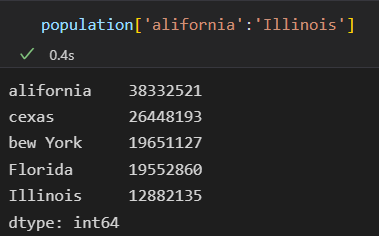
创建Series对象
pd.Series(data, index=index)
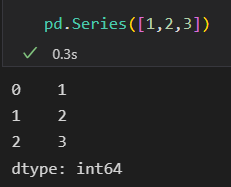
index是一个可选参数,data参数支持多种数据类型, 可以是列表 或 Numpy数组, index默认值为整数序列
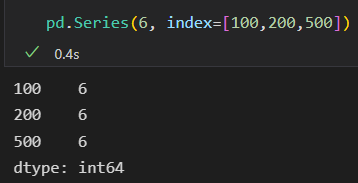
data可以是个标量,创建对象是会重复填充到每个索引上。
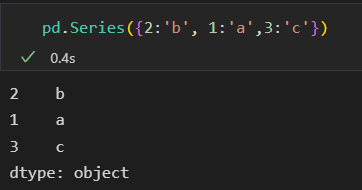
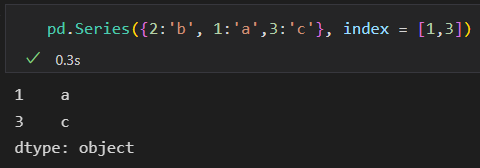
data可以是字典,索引是默认的,不排序,老版本的好像对index进行排序了。
每一种形式都可以通过显示指定索引 筛选需要的结果
Pandas的DataFrame对象
也可以作为一个通用型的Numpy数组,也可以看做特殊的Python字典
DataFrame :通用的Numpy数组
Series是 有 灵活索引的一维 数组 , DataFrame是 一种 既有 灵活的行索引,又有灵活列名 的二维数组 。
DataFrame也可以看成 是若干个Series对象。。索引相同。

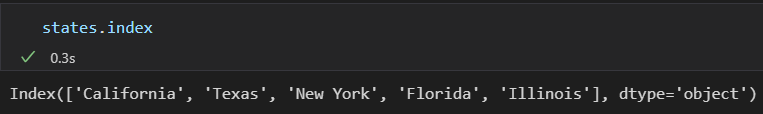
index属性获取索引标签
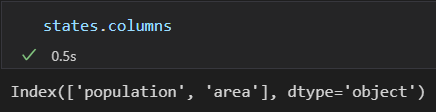
DataFrame还有一个columns属性, 是存放列标签的Index对象:
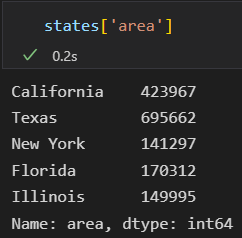
DataFrame :特殊的字典
字典是一个键映射一个值,而DataFrame是 一个列名映射一个Series的数据。
创建DataFrame对象
1)通过单个Series对象创建。DataFrame是一组Series对象的集合
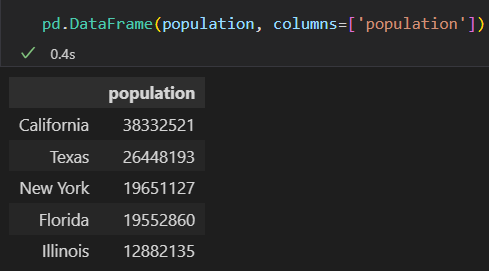
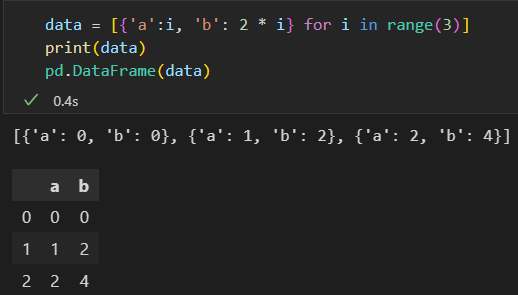
2)通过字典列表创建。 任何元素是字典的列表都可以变成DataFrame
3)通过Series对象常见,开始介绍那样子。
4)通过Numpy二维数组创建
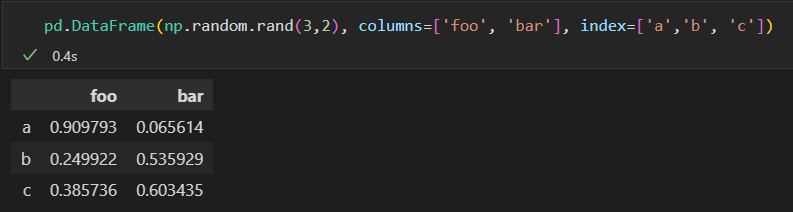
5)通过Numpy结构化数组创建
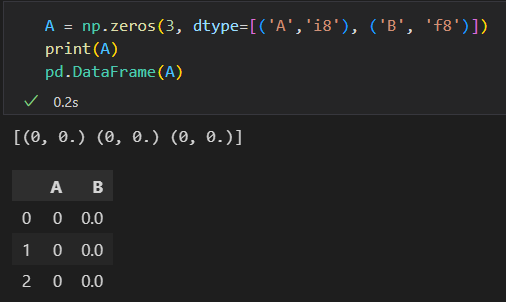
Pandas的Index对象
Series 和 DataFrame 对象都使用便于引用和调整的 显示索引。
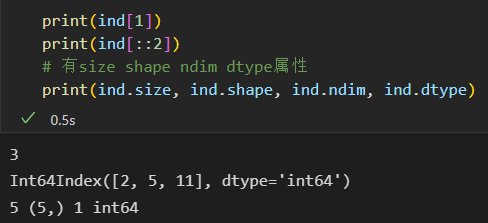
Pandas的Index对象是一个很有趣的数据结构。 可以将它看作是一个 不可变数组 或 有序集合,
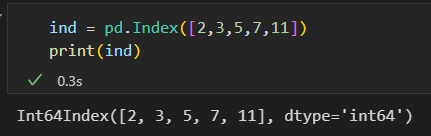
1)将Index看作不可变数组
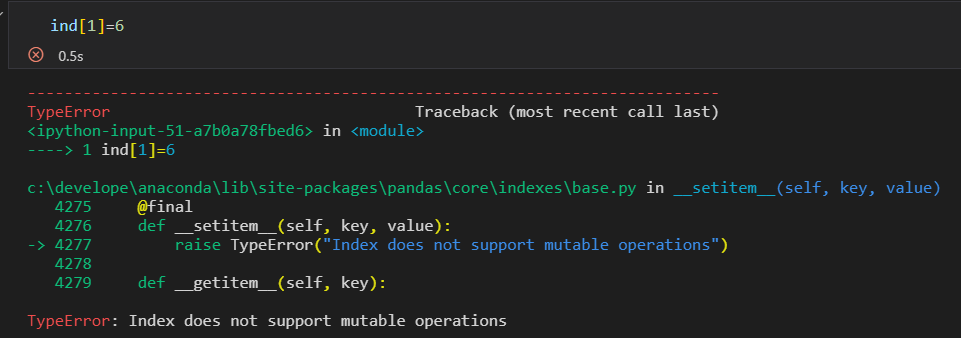
如果修改索引值会报错。对象的不可变性,使得多个DataFrame和数组之间进行索引共享是更加安全
2)将Index看作有序集合
Pandas对象被设计用于实现多操作。 如连接数据集。并集 交集 差集
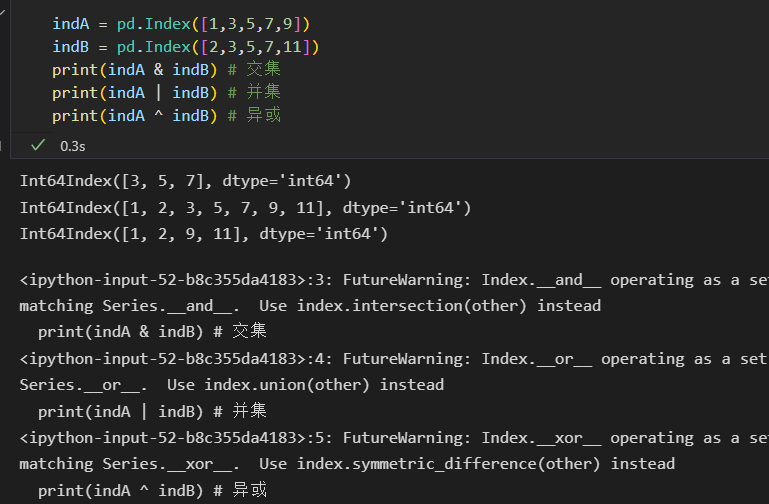
不过好像不推荐用这种方式了。哈哈
使用对象方法

Python数据科学手册-Pandas数据处理之简介的更多相关文章
- Python数据科学手册-Pandas:向量化字符串操作、时间序列
向量化字符串操作 Series 和 Index对象 的str属性. 可以正确的处理缺失值 方法列表 正则表达式. Method Description match() Call re.match() ...
- Python数据科学手册-Pandas:累计与分组
简单累计功能 Series sum() 返回一个 统计值 DataFrame sum.默认对每列进行统计 设置axis参数,对每一行 进行统计 describe()可以计算每一列的若干常用统计值. 获 ...
- Python数据科学手册-Pandas:数值运算方法
Numpy 的基本能力之一是快速对每个元素进行运算 Pandas 继承了Numpy的功能,也实现了一些高效技巧. 对于1元运算,(函数,三角函数)保留索引和列标签 对于2元运算,(加法,乘法),Pan ...
- Python数据科学手册-Pandas:数据取值与选择
Numpy数组取值 切片[:,1:5], 掩码操作arr[arr>0], 花哨的索引 arr[0, [1,5]],Pandas的操作类似 Series数据选择方法 Series对象与一维Nump ...
- Python数据科学手册-Pandas:层级索引
一维数据 和 二维数据 分别使用Series 和 DataFrame 对象存储. 多维数据:数据索引 超过一俩个 键. Pandas提供了Panel 和 Panel4D对象 解决三维数据和四维数据. ...
- Python数据科学手册-Pandas:合并数据集
将不同的数据源进行合并 , 类似数据库 join merge . 工具函数 concat / append pd.concat() 简易合并 合并高维数据 默认按行合并. axis=0 ,试试 axi ...
- 100天搞定机器学习|day45-53 推荐一本豆瓣评分9.3的书:《Python数据科学手册》
<Python数据科学手册>共五章,每章介绍一到两个Python数据科学中的重点工具包.首先从IPython和Jupyter开始,它们提供了数据科学家需要的计算环境:第2章讲解能提供nda ...
- Python数据科学手册
Python数据科学手册(高清版)PDF 百度网盘 链接:https://pan.baidu.com/s/1KurSdjNWiwMac3o3iLrzBg 提取码:qogy 复制这段内容后打开百度网盘手 ...
- Matplotlib 使用 - 《Python 数据科学手册》学习笔记
一.引入 import matplotlib as mpl import matplotlib.pyplot as plt 二.配置 1.画图接口 Matplotlib 有两种画图接口: (1)一个是 ...
随机推荐
- Java开发学习(九)----IOC之核心容器
这里所说的核心容器,大家可以把它简单的理解为ApplicationContext,前面虽然已经用到过,但是并没有系统的介绍过,接下来咱们从以下几个问题入手来下容器的相关知识: 如何创建容器? 创建好容 ...
- Spring和SpringMVC整合及关系
SpringMVC扼要的讲,就是控制请求和处理.有必要将Spring和SpringMVC整合,否则仅配置SpringMVC并完成Spring的功能,会造成业务逻辑混乱. 简要总结:①原理:采用监听器, ...
- IO流原理及流的分类
IO原理 I/O是Input/Output的缩写, I/O技术是非常实用的技术,用于 处理设备之间的数据传输.如读/写文件,网络通讯等. Java程序中,对于数据的输入/输出操作以"流(st ...
- C# 11 的新特性和改进前瞻
前言 .NET 7 的开发还剩下一个多月就要进入 RC,C# 11 的新特性和改进也即将敲定.在这个时间点上,不少新特性都已经实现完毕并合并入主分支 C# 11 包含的新特性和改进非常多,类型系统相比 ...
- kubernetes 调度
pod 分配给特定的node节点 目的:在一般业务场景,有些pod需要运行在特定的物理节点上,可以通过kubernetes的nodeSelector.nodeName安排pod到指定的节点上运行. # ...
- day05 Java_循环_基本类型数组
精华笔记: 循环结构: for结构:应用率高.与次数相关的循环 三种循环结构的选择规则: 先看循环是否与次数相关: 若相关----------------------------直接上for 若无关, ...
- 函数式接口的概念&函数式接口的定义和函数式接口的使用
函数式接口概念 函数式接口在Java中是指:有且仅有一个抽象方法的接口. 函数式接口,即适用于函数式编程场景的接口.而Java中的函数式编程体现就是Lambda,所以函数式接口就是可以适用于Lambd ...
- 并发异步编程之争:协程(asyncio)到底需不需要加锁?(线程/协程安全/挂起/主动切换)Python3
原文转载自「刘悦的技术博客」https://v3u.cn/a_id_208 协程与线程向来焦孟不离,但事实上是,线程更被我们所熟知,在Python编程领域,单核同时间内只能有一个线程运行,这并不是什么 ...
- Odoo 14 Action URL 生成
from werkzeug.urls import url_encode url = '/web#%s' % url_encode({ 'action': 'hr.plan_wizard_action ...
- 数据仓库模型之CDM、LDM与PDM的区别
在数据仓库建设中,概念数据模型设计与逻辑数据模型设计.物理数据模型设计是数据库及数据仓库模型设计的三个主要步骤. conceptual data model 概念数据模型是最终用户对数据存储的看法,反 ...