
Elasticsearch:top_hits aggregation
top_hits指标聚合器跟踪要聚合的最相关文档。 该聚合器旨在用作子聚合器,以便可以按存储分区汇总最匹配的文档。
top_hits聚合器可以有效地用于通过存储桶聚合器按某些字段对结果集进行分组。 一个或多个存储桶聚合器确定将结果集切成哪些属性。
选项:
- from-要获取的第一个结果的偏移量。
- size-每个存储桶要返回的最匹配匹配项的最大数目。 默认情况下,返回前三个匹配项。
- 排序-匹配的热门匹配的排序方式。 默认情况下,命中按主要查询的分数排序。
我们还是来用一个例子来展示如何使用这个:
准备数据:
我们选用Kibana里带的官方的Sample web logs来作为我们的索引:
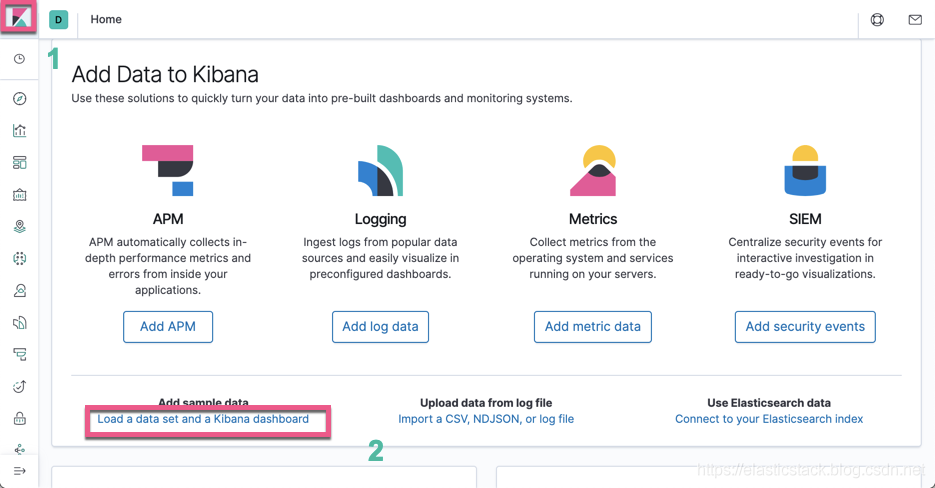
然后加载我们的索引:
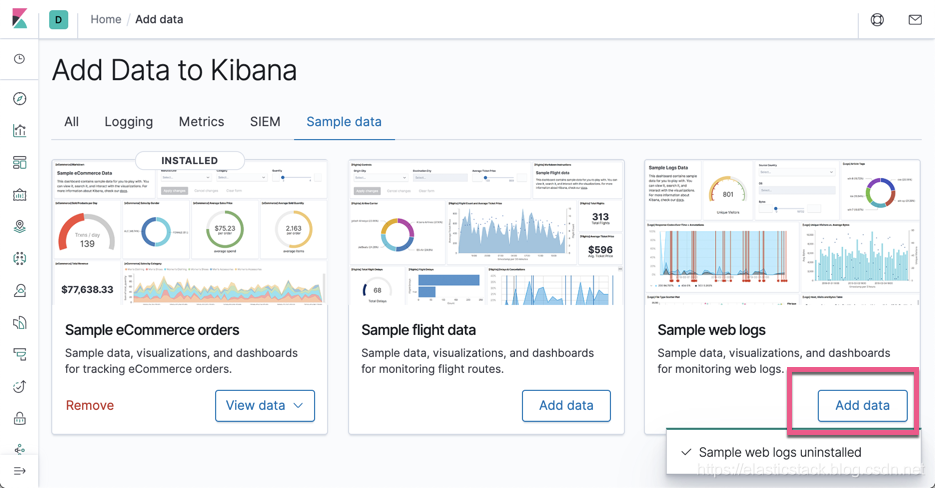
这样我们的数据就加载完成了。
Top hits aggregation
首先,我们先做一个简单的基于hosts的aggregation:
GET kibana_sample_data_logs/_search

{

  "size": 0,

  "aggs": {

    "hosts": {

      "terms": {

        "field": "host.keyword",

        "size": 2

      }

    }

  }

}
上面的搜索的结果是我们想得到2个桶的数据(这里为了说明问题的方便,设定为2)。而这两个桶是基于hosts的值。搜索的结果是:
"aggregations" : {

    "hosts" : {

      "doc_count_error_upper_bound" : 0,

      "sum_other_doc_count" : 2807,

      "buckets" : [

        {

          "key" : "artifacts.elastic.co",

          "doc_count" : 6488

        },

        {

          "key" : "www.elastic.co",

          "doc_count" : 4779

        }

      ]

    }

  }
现在的要求是:我们想针对这里的每个桶得到按照我们需要排序的前面的几个结果,比如下面的搜索:
GET kibana_sample_data_logs/_search

{

  "size": 0,

  "aggs": {

    "hosts": {

      "terms": {

        "field": "host.keyword",

        "size": 2

      },

      "aggs": {

        "most_bytes": {

          "top_hits": {

            "sort": [

              {

                "bytes": {

                  "order": "desc"

                }

              }

            ],

            "_source": {

              "includes": [

                "bytes",

                "hosts",

                "ip",

                "clientip"

              ]

            },

            "size": 2

          }

        }

      }

    }

  }

}
上面实际上市一个pipleline的聚合。它在针对上面的桶来做了一个top_hits的聚合。针对每个桶,我们需要安装bytes的大小,降序排列,并且每个桶只需要两个数据:
  "aggregations" : {

    "hosts" : {

      "doc_count_error_upper_bound" : 0,

      "sum_other_doc_count" : 2807,

      "buckets" : [

        {

          "key" : "artifacts.elastic.co",

          "doc_count" : 6488,

          "most_bytes" : {

            "hits" : {

              "total" : {

                "value" : 6488,

                "relation" : "eq"

              },

              "max_score" : null,

              "hits" : [

                {

                  "_index" : "kibana_sample_data_logs",

                  "_type" : "_doc",

                  "_id" : "dnNIHm8BjrINWI3xXlRc",

                  "_score" : null,

                  "_source" : {

                    "bytes" : 19929,

                    "ip" : "127.155.255.9",

                    "clientip" : "127.155.255.9"

                  },

                  "sort" : [

                    19929

                  ]

                },

                {

                  "_index" : "kibana_sample_data_logs",

                  "_type" : "_doc",

                  "_id" : "OXNIHm8BjrINWI3xX1td",

                  "_score" : null,

                  "_source" : {

                    "bytes" : 19904,

                    "ip" : "100.177.58.231",

                    "clientip" : "100.177.58.231"

                  },

                  "sort" : [

                    19904

                  ]

                }

              ]

            }

          }

        },

        {

          "key" : "www.elastic.co",

          "doc_count" : 4779,

          "most_bytes" : {

            "hits" : {

              "total" : {

                "value" : 4779,

                "relation" : "eq"

              },

              "max_score" : null,

              "hits" : [

                {

                  "_index" : "kibana_sample_data_logs",

                  "_type" : "_doc",

                  "_id" : "4nNIHm8BjrINWI3xYWQl",

                  "_score" : null,

                  "_source" : {

                    "bytes" : 19986,

                    "ip" : "233.204.30.48",

                    "clientip" : "233.204.30.48"

                  },

                  "sort" : [

                    19986

                  ]

                },

                {

                  "_index" : "kibana_sample_data_logs",

                  "_type" : "_doc",

                  "_id" : "wnNIHm8BjrINWI3xW0Rj",

                  "_score" : null,

                  "_source" : {

                    "bytes" : 19956,

                    "ip" : "129.237.102.30",

                    "clientip" : "129.237.102.30"

                  },

                  "sort" : [

                    19956

                  ]

                }

              ]

            }

          }

        }

      ]

    }

  }
从上面的返回结果可以看出来两个hosts artifacts.elastic.co及www.elastic.co各返回两个结果,并且它们是按照bytes的大小进行降序排列的。
细心的读者可能会发现这个和我之前介绍的field collapsing有些类似。只是field collapsing里针对每个桶有一个结果,并且是按照我们的要求进行排序的最高结果的那个。当然我们也可以含有多几个返回结果在inner_hits之中。
Elasticsearch:top_hits aggregation的更多相关文章
- Elasticsearch:运用search_after来进行深度分页
在上一篇文章 "Elasticsearch:运用scroll接口对大量数据实现更好的分页",我们讲述了如何运用scroll接口来对大量数据来进行有效地分页.在那篇文章中,我们讲述了 ...
- Elasticsearch:Index生命周期管理入门
如果您要处理时间序列数据,则不想将所有内容连续转储到单个索引中. 取而代之的是,您可以定期将数据滚动到新索引,以防止数据过大而又缓慢又昂贵. 随着索引的老化和查询频率的降低,您可能会将其转移到价格较低 ...
- Elasticsearch:Pinyin 分词器
Elastic的Medcl提供了一种搜索Pinyin搜索的方法.拼音搜索在很多的应用场景中都有被用到.比如在百度搜索中,我们使用拼音就可以出现汉字: 对于我们中国人来说,拼音搜索也是非常直接的.那么在 ...
- Elasticsearch:定制分词器(analyzer)及相关性
转载自:https://elasticstack.blog.csdn.net/article/details/114278163 在许多的情况下,我们使用现有的分词器已经足够满足我们许多的业务需求,但 ...
- Elasticsearch:如何实现对 emoji 表情符号进行搜索
转摘自:https://elasticstack.blog.csdn.net/article/details/114261636 Elasticsearch 是一个应用非常广泛的搜索引擎.它可以对文字 ...
- Elasticsearch:使用 GeoIP 丰富来自内部专用 IP 地址
转载自:https://blog.csdn.net/UbuntuTouch/article/details/108614271 对于公共 IP,可以创建表来指定 IP 属于哪个城市的特定范围.但是,互 ...
- Elasticsearch:aggregation介绍
聚合(aggregation)功能集是整个Elasticsearch产品中最令人兴奋和有益的功能之一,主要是因为它提供了一个非常有吸引力对之前的facets的替代. 在本教程中,我们将解释Elasti ...
- Elasticsearch:significant terms aggregation
在本文中,我们将重点关注significant terms和significant text聚合.这些聚合旨在搜索数据集中有趣和/或不寻常的术语,这些术语可以告诉您有关数据的隐藏属性的更多信息.此功能 ...
- Elasticsearch:运用 shard_size 来提高term aggregation的精度
随机推荐
- 霍普菲尔得神经网络(Hopfield Neural Network)
设计一个反馈网络存储下列目标平衡点: T = [ 1 -1; -1 1 ]; 并用6组任意随机初始列矢量,包括一组在目标平衡点连线的垂直平分线上的一点作为输入矢量对所设计的网络的平衡点进行测试,观 ...
- 循环控制-break语句和continue语句
break关键字的用法有常见的两种: 1.可以用switch语句当中,一旦执行,整个switch语句立刻结束 2.还可以用在循环语句当中,一定执行,整个循环语句立刻结束,打断循环 关于循环的选择,有一 ...
- 在 SQL Server 中使用 Try Catch 处理异常
如何在 SQL Server 中使用 Try Catch 处理错误? 从 SQL Server 2005 开始,我们在TRY 和 CATCH块的帮助下提供了结构错误处理机制.使用TRY-CATCH的语 ...
- 虚拟机win7系统安装
win7 x64虚拟机安装步骤 1.点击创建新虚拟机,选择典型 2.选择客户机操作系统:windows 7 x64 3.命名虚拟机 4.指定磁盘容量 5.点击完成 6.编辑此虚拟机设置 7.内存设置 ...
- 【Unity基础知识】认识常用的生命周期函数(Awake、Start、Update...)
一.了解帧的概念 游戏的本质就是一个死循环 每一次循环都会处理游戏逻辑 并 更新一次游戏画面 之所以能看到画面在动 是因为 切换画面速度达到一定速度时 人眼就会认为画面是动态且流畅的 一帧就是执行了一 ...
- “杀死” App 上的疑难崩溃
在移动应用性能方面,崩溃带来的影响是最为严重的,程序崩了可以打断用户正在进行的操作体验,造成关键业务中断.用户留存率下降.品牌口碑变差.生命周期价值下降等影响.很多公司将崩溃率作为优先级最高的技术指标 ...
- 浅谈 Lucas 定理
Lucas 定理是用来求 \(C^n_m\bmod p\) 的. 定理 \[C^n_m\equiv C^{n\bmod p}_{m\bmod p}\cdot C^{\lfloor n/p\rfloor ...
- 基于ABP和Magicodes实现Excel导出操作
前端使用的vue-element-admin框架,后端使用ABP框架,Excel导出使用的Magicodes.IE.Excel.Abp库.Excel导入和导出操作几乎一样,不再介绍.文本主要介绍E ...
- Python 爬取汽车之家口碑数据
本文仅供学习交流使用,如侵立删!联系方式见文末 汽车之家口碑数据 2021.8.3 更新 增加用户信息参数.认证车辆信息等 2021.3.24 更新 更新最新数据接口 2020.12.25 更新 添加 ...
- (WebFlux)002、如何打印日志与链路ID
一.背景 最近在持续改造项目,想通过日志查看用户所有的接口链路日志.在原来基于SpirngMVC的时候,那是比较好处理的,通过ThreadLocal,放入TraceId,就可以把一个TraceId传到 ...