
Hive(十三)【Hive on Spark 部署搭建】
Hive on Spark 官网详情:https://cwiki.apache.org//confluence/display/Hive/Hive+on+Spark:+Getting+Started
一.安装Hive
具体安装参考:Hive(一)【基本概念、安装】
安装和Spark对应版本一起编译的Hive,当前官网推荐的版本关系如下:
| HiveVersion | SparkVersion |
|---|---|
| 1.1.x | 1.2.0 |
| 1.2.x | 1.3.1 |
| 2.0.x | 1.5.0 |
| 2.1.x | 1.6.0 |
| 2.2.x | 1.6.0 |
| 2.3.x | 2.0.0 |
| 3.0.x | 2.3.0 |
| master | 2.3.0 |
二.安装Spark
①在Hive所在机器安装Spark,配置Spark on Yarn模式。
可以将spark的日志,集成到Yarn上
②配置Spark的环境变量。
export SPARK_HOME=/opt/module/spark

export PATH=$PATH:$SPARK_HOME/bin
source /etc/profile.d/my_env.sh
具体安装参考:Spark(一)【spark-3.0安装和入门】
三.向HDFS上传Spark纯净版jar包
使用不带hadoop的spark的包:spark-3.0.0-bin-without-hadoop.tgz
①解压
tar -zxvf /opt/software/spark/spark-3.0.0-bin-without-hadoop.tgz
②上传只HDFS的/spark-jars目录,该目录在下面需要配置
hadoop fs -put spark-3.0.0-bin-without-hadoop/jars/* /spark-jars
四.修改hive-site.xml文件
添加如下内容
<!--Spark依赖位置,上面上传jar包的hdfs路径-->

<property>

    <name>spark.yarn.jars</name>

    <value>hdfs://hadoop102:8020/spark-jars/*</value>

</property>

<!--Hive执行引擎,使用spark-->

<property>

    <name>hive.execution.engine</name>

    <value>spark</value>

</property>

<!--Hive和spark连接超时时间-->

<property>

    <name>hive.spark.client.connect.timeout</name>

    <value>10000ms</value>

</property>
注意: hive.spark.client.connect.timeout的默认值是1000ms,如果执行hive的insert语句时,抛如下异常,可以调大该参数到10000ms
FAILED: SemanticException Failed to get a spark session: org.apache.hadoop.hive.ql.metadata.HiveException: Failed to create Spark client for Spark session d9e0224c-3d14-4bf4-95bc-ee3ec56df48e
五.测试
①启动hive的metstore服务和hive客户端
[root@hadoop102 ~]$ hive --service metastore

[root@hadoop102 hive]$ bin/hive
②创建一张测试表
hive (default)> create table student(id int, name string);
③通过insert测试效果
hive (default)> insert into table student values(1,'abc');
若结果如下,则说明配置成功,第一次初始化spark session比较费时间,下次执行就很快了。
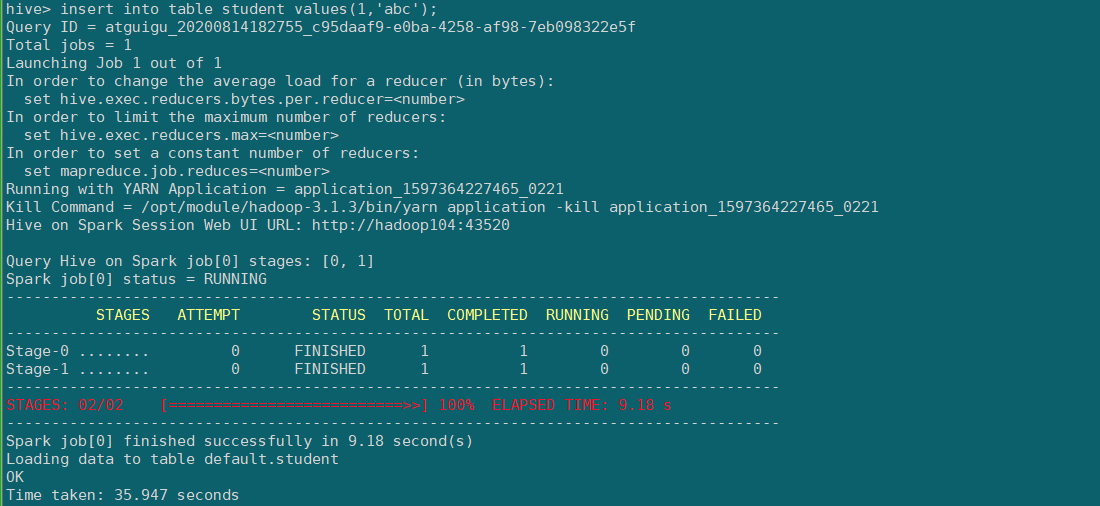
hive on spark 的相关原理可参考
FAQ
1.执行sql语句,报错信息。
hive> insert into table student values(1,'abc');

Query ID = atguigu_20200814150018_318272cf-ede4-420c-9f86-c5357b57aa11

Total jobs = 1

Launching Job 1 out of 1

In order to change the average load for a reducer (in bytes):

  set hive.exec.reducers.bytes.per.reducer=<number>

In order to limit the maximum number of reducers:

  set hive.exec.reducers.max=<number>

In order to set a constant number of reducers:

  set mapreduce.job.reduces=<number>

Job failed with java.lang.ClassNotFoundException: org.apache.spark.AccumulatorParam

FAILED: Execution Error, return code 3 from org.apache.hadoop.hive.ql.exec.spark.SparkTask. Spark job failed during runtime. Please check stacktrace for the root cause.
原因:由于当前的hive的版本3.1.2,spark版本3.0.0,只能自己编译。
建议用官方发布的hive+spark版本搭配。
2.启动hive的metstore服务,不然可能报错
hive> insert into table student values(1,'abc');

FAILED: HiveException java.lang.RuntimeException: Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClient
Hive(十三)【Hive on Spark 部署搭建】的更多相关文章
- 再谈spark部署搭建和企业级项目接轨的入门经验(博主推荐)
进入我这篇博客的博友们,相信你们具备有一定的spark学习基础和实践了. 先给大家来梳理下.spark的运行模式和常用的standalone.yarn部署.这里不多赘述,自行点击去扩展. 1.Spar ...
- Hive On Spark环境搭建
Spark源码编译与环境搭建 Note that you must have a version of Spark which does not include the Hive jars; Spar ...
- Spark环境搭建(四)-----------数据仓库Hive环境搭建
Hive产生背景 1)MapReduce的编程不便,需通过Java语言等编写程序 2) HDFS上的文缺失Schema(在数据库中的表名列名等),方便开发者通过SQL的方式处理结构化的数据,而不需要J ...
- Hive记录-Hive on Spark环境部署
1.hive执行引擎 Hive默认使用MapReduce作为执行引擎,即Hive on mr.实际上,Hive还可以使用Tez和Spark作为其执行引擎,分别为Hive on Tez和Hive on ...
- 【原创】大叔经验分享(24)hive metastore的几种部署方式
hive及其他组件(比如spark.impala等)都会依赖hive metastore,依赖的配置文件位于hive-site.xml hive metastore重要配置 hive.metastor ...
- Hive 1.2.1&Spark&Sqoop安装指南
目录 目录 1 1. 前言 1 2. 约定 2 3. 服务端口 2 4. 安装MySQL 2 4.1. 安装MySQL 2 4.2. 创建Hive元数据库 4 5. 安装步骤 5 5.1. 下载Hiv ...
- Hadoop Hive概念学习系列之hive三种方式区别和搭建、HiveServer2环境搭建、HWI环境搭建和beeline环境搭建(五)
说在前面的话 以下三种情况,最好是在3台集群里做,比如,master.slave1.slave2的master和slave1都安装了hive,将master作为服务端,将slave1作为服务端. 以 ...
- 数仓Hive和分布式计算引擎Spark多整合方式实战和调优方向
@ 目录 概述 Spark on Hive Hive on Spark 概述 编译Spark源码 配置 调优思路 编程方向 分组聚合优化 join优化 数据倾斜 任务并行度 小文件合并 CBO 谓词下 ...
- ubuntu下搭建hive(包括hive的web接口)记录
Hive版本 0.12.0(独立模式) Hadoop版本 1.12.1 Ubuntu 版本 12.10 今天试着搭建了hive,差点迷失在了网上各种资料中,现在把我的经验分享给大家,亲手实践过,但未必 ...
随机推荐
- 编译内核错误:Can't use 'defined(@array)' (Maybe you should just omit the defined()?) at kernel/timeconst.pl line 373
最近在编译一个新的rk sdk的时候,编译内核报错 CHK include/linux/version.h CHK include/generated/utsrelease.h make[1]: 'i ...
- linux下创建文件的文件权限问题
今天发现创建文件的权限和自己规定的权限不一致,了解到了权限掩码的问题,这里总结一下. 首先权限掩码umask是chmod配套的,总共为4位(gid/uid,属主,组权,其它用户的权限),不过通常我们都 ...
- hdu 2199 Can you solve this equation?(二分法求多项式解)
题意 给Y值,找到多项式 8*x^4 + 7*x^3 + 2*x^2 + 3*x + 6 == Y 在0到100之间的解. 思路 从0到100,多项式是单调的,故用二分法求解. 代码 double c ...
- PHP笔记2__变量/字符串/类型转换/常量/,,
<?php //可变变量 $a = "ok"; $$a = "fine"; $$$a = "er"; echo $ok; echo & ...
- 我的笔记本电脑瞬间扩大一个T的容量!
前言 不知道有多少人在家里搭建中央存储设备的,也就是NAS.这个东西在我日常生活中,存储了大量的个人资料,家人们的照片,技术的资料,还有各种高清影视剧.搭配公网的IP,可以真正做到,任何时候任何地点的 ...
- 在纯JaveScript中实现报表导出:从“PDF”到“JPG”
我们在前端报表中完成了各种工作数据的输入或内容处理之后,需要做什么? 数据的导出! 这些数据的常用导出格式有:PDF.Excel.HTML和图片几大类型. 但总有一些实际应用场景,需要的不仅仅是将现有 ...
- Element - 日期禁用集合(持续更新)
当前日期之前的日期禁用 <el-date-picker v-model="form.startTime" type="date" placeholder= ...
- 面试官:熟悉JS中的new吗?能手写实现吗?
目录 1 new 运算符简介 2 new 究竟干了什么事 3 模拟实现 new 运算符 4 补充 预备知识: 了解原型和原型链 了解this绑定 1 new 运算符简介 MDN文档:new 运算符创建 ...
- 【lwip】04-内存管理
目录 前言 4. 内存管理 4.1 内存分配策略 4.1.1 固定大小的内存块 4.1.2 可变大小分配 4.2 动态内存池(pool) 4.2.1 介绍 4.2.2 内存池的预处理 4.2.3 内存 ...
- 【Go语言学习笔记】Go的函数
函数还是这几块: 参数 返回值 作用域 执行顺序 参数和返回值 func FuncName(/*参数列表*/) (o1 type1, o2 type2/*返回类型*/) { //函数体 return ...