
将白码平台数据存储到MySQL数据库
概述:
此前在白码平台上搭建并使用系统,若想要将白码平台上搭建的系统的数据存储到自己本地的MySQL数据库中的话,需要将数据导出后再对数据进行处理。如今想要实现这一需求,直接通过使用白码的数据库对接功能,将数据存储到自己本地的数据库中即可。平均一个数据表只需要一分钟的操作时间便能完成对接,效率提升十分显著。
实现效果:
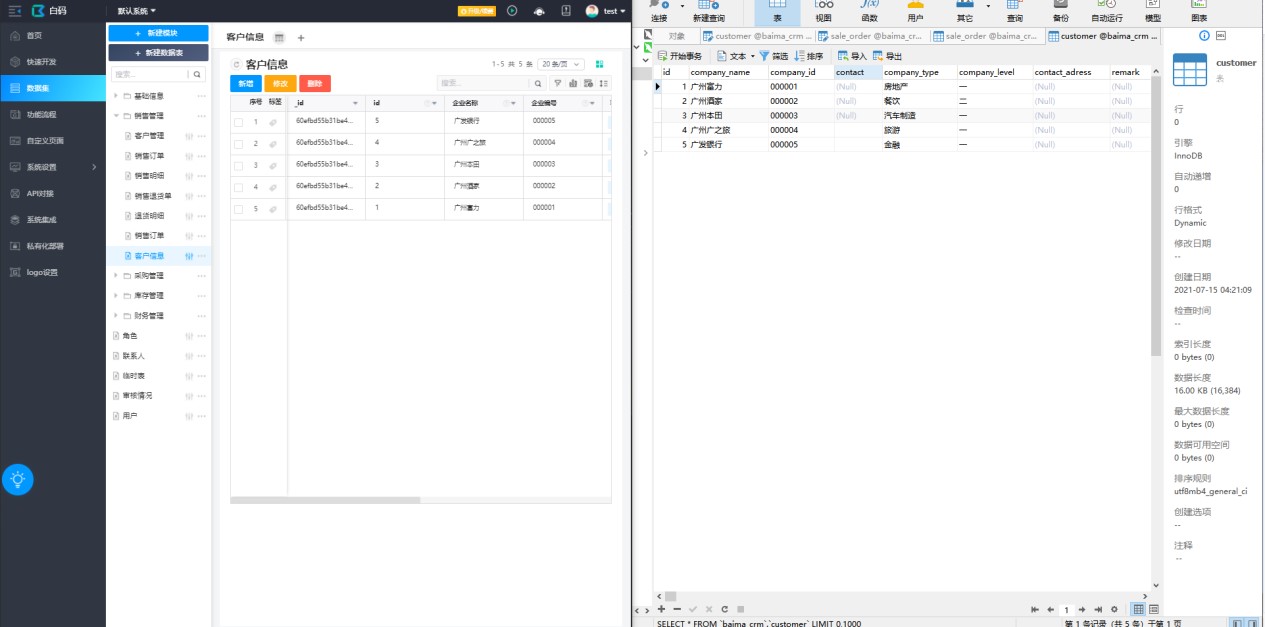
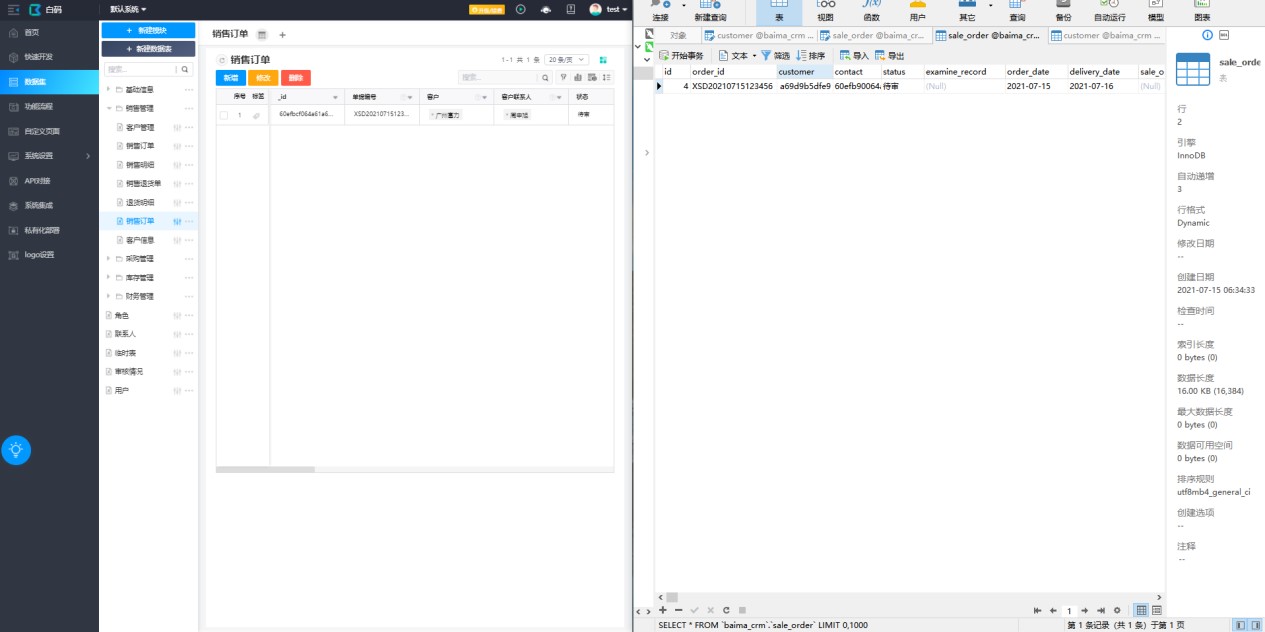
左边为白码数据表中的数据,右边为本地数据库的数据,点击自动生成后,字段以及数据就一并存储到本地的数据库中了,实现数据的同步。下面展示存储后的效果。
客户信息表:
销售订单表:
实现步骤:
本地数据库设置:
以进销存系统中的销售订单模块为例,订单表关联了多个数据表,包括客户信息表,销售明细表等。依次将这几个表在数据库中创建出来,不用再重新设计表结构,添加完主键并填写表名保存就可以了,字段以及数据使用对接功能自动同步。
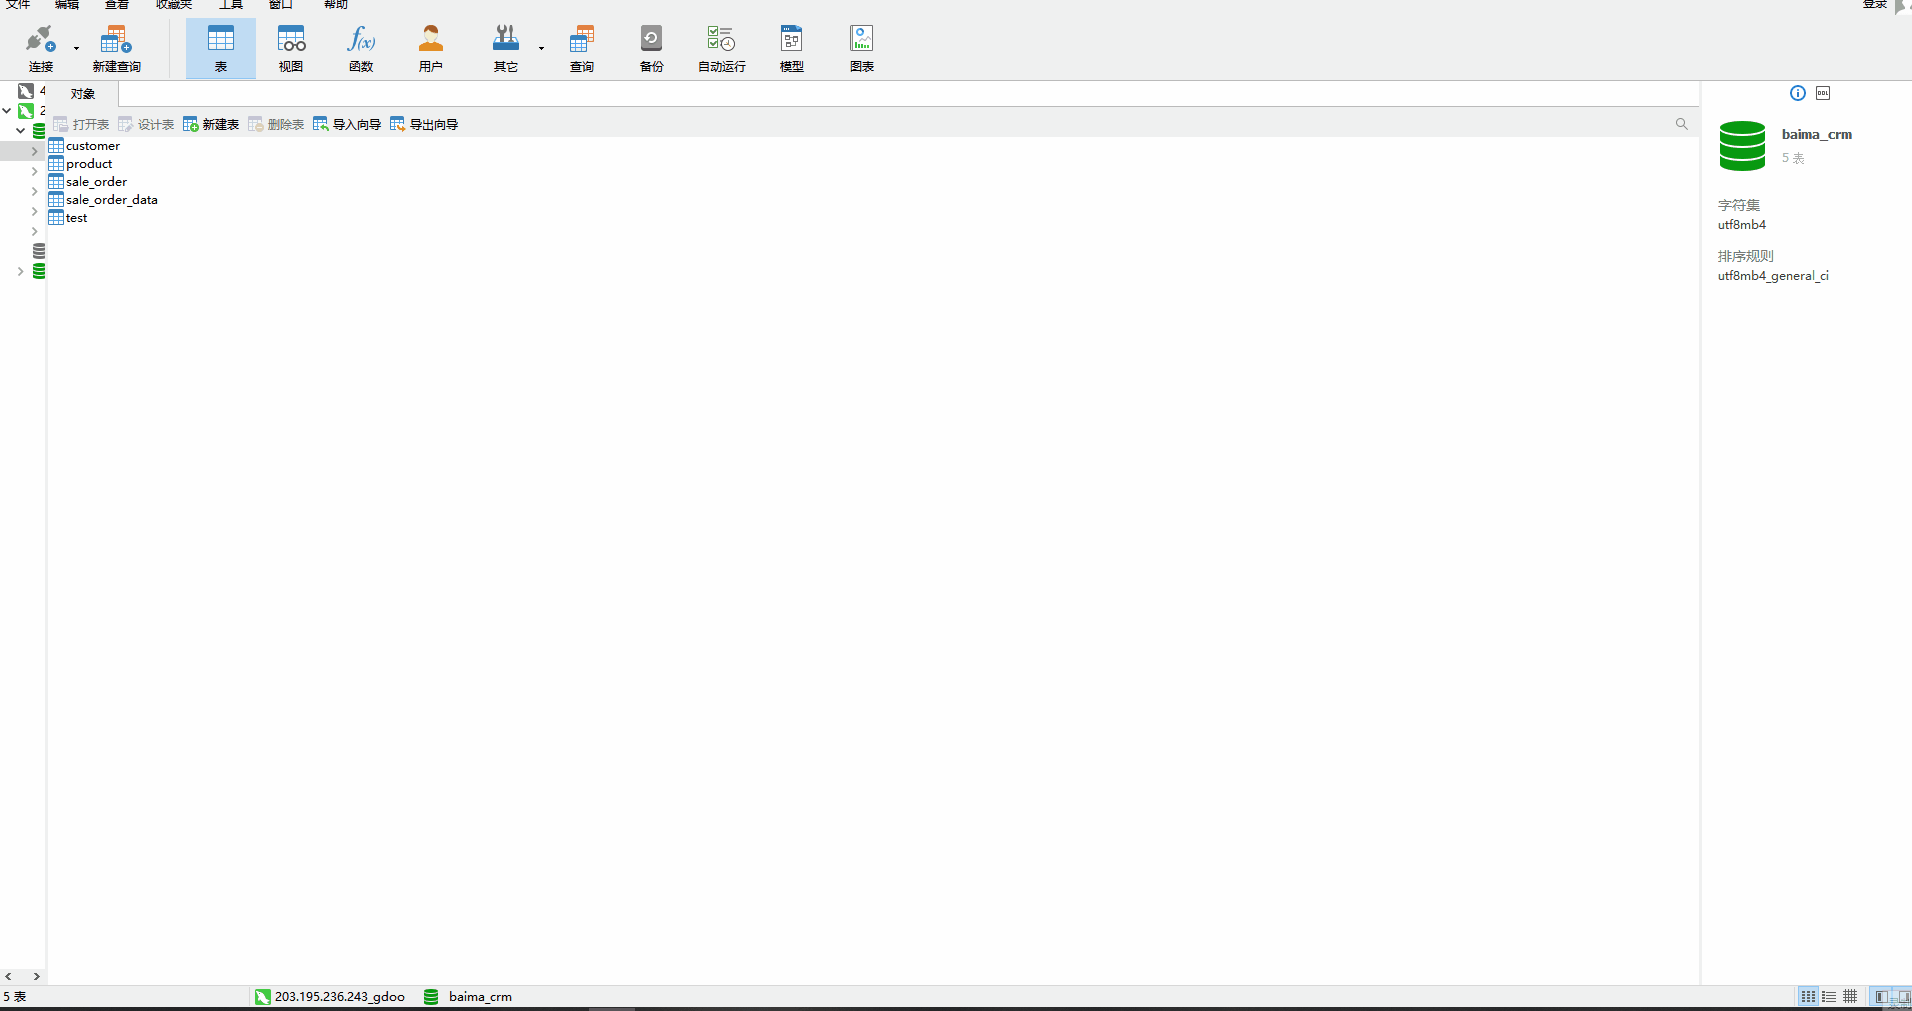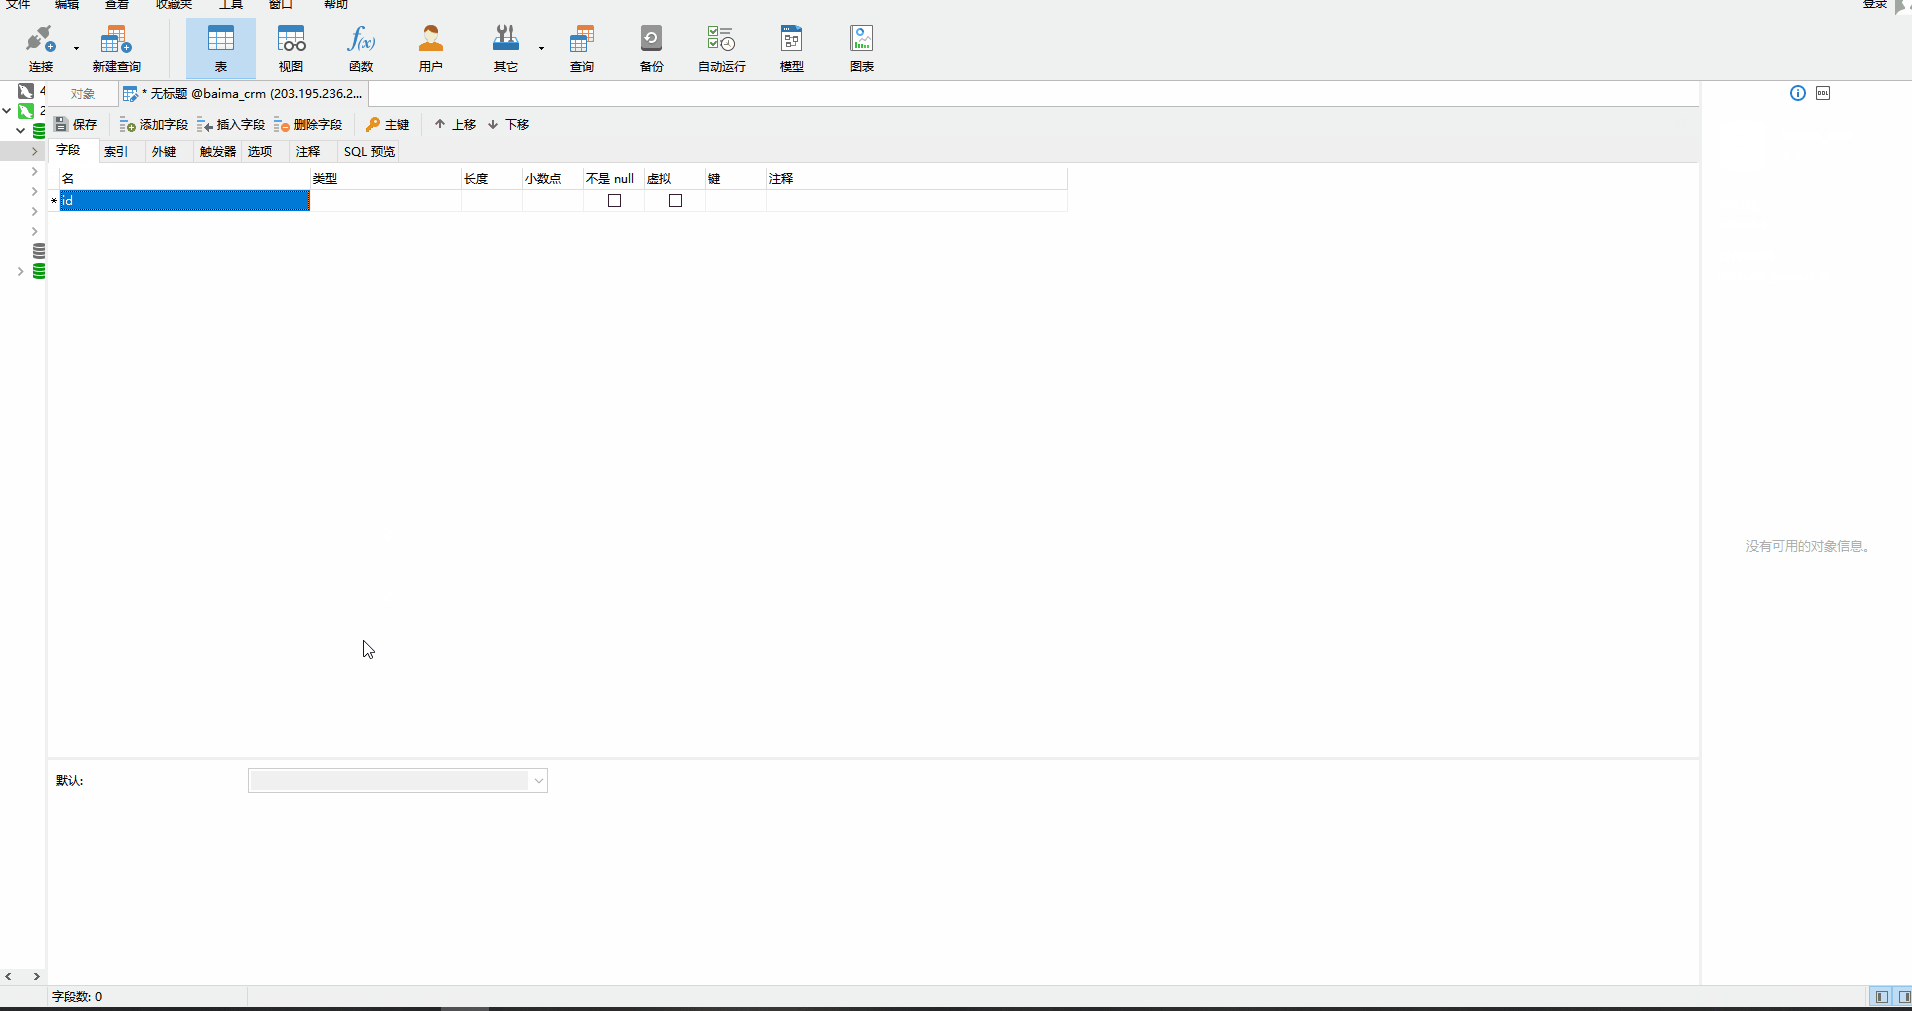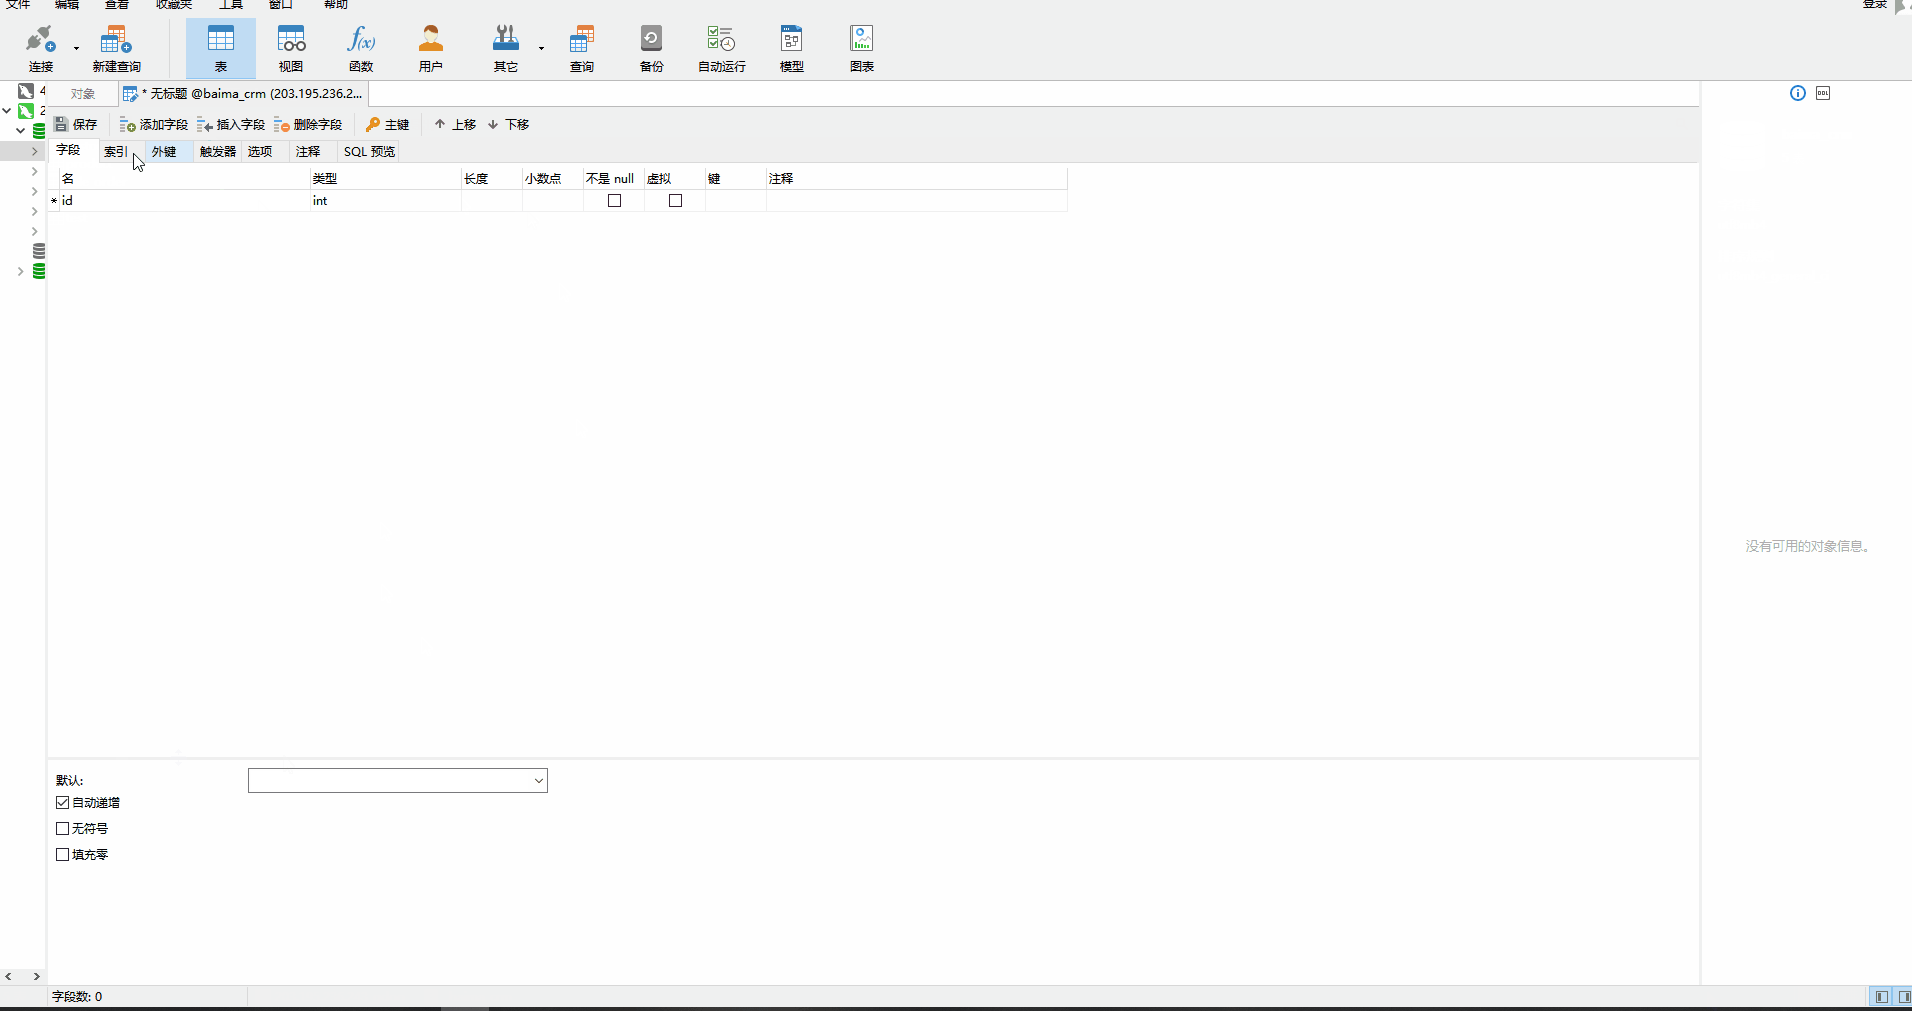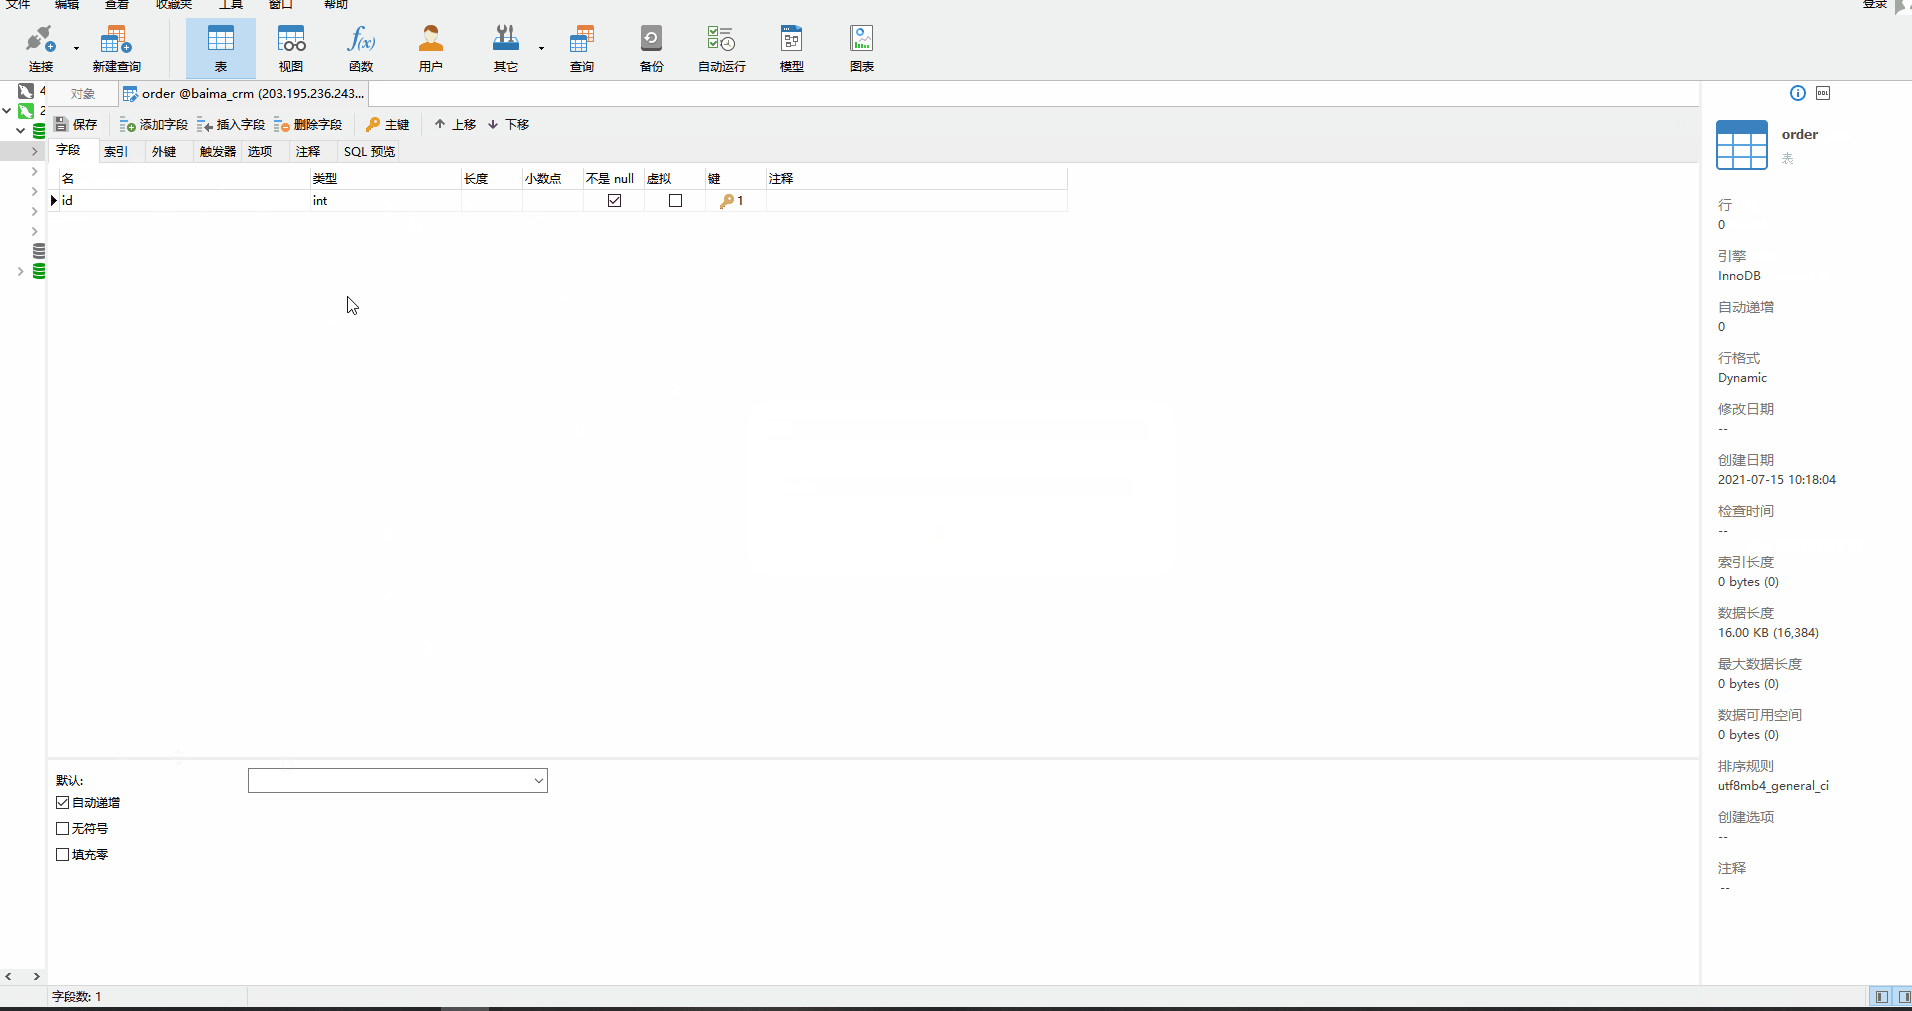
在本地数据库中创建完对应的表后,需要在白码平台上对数据表进行数据库对接配置。
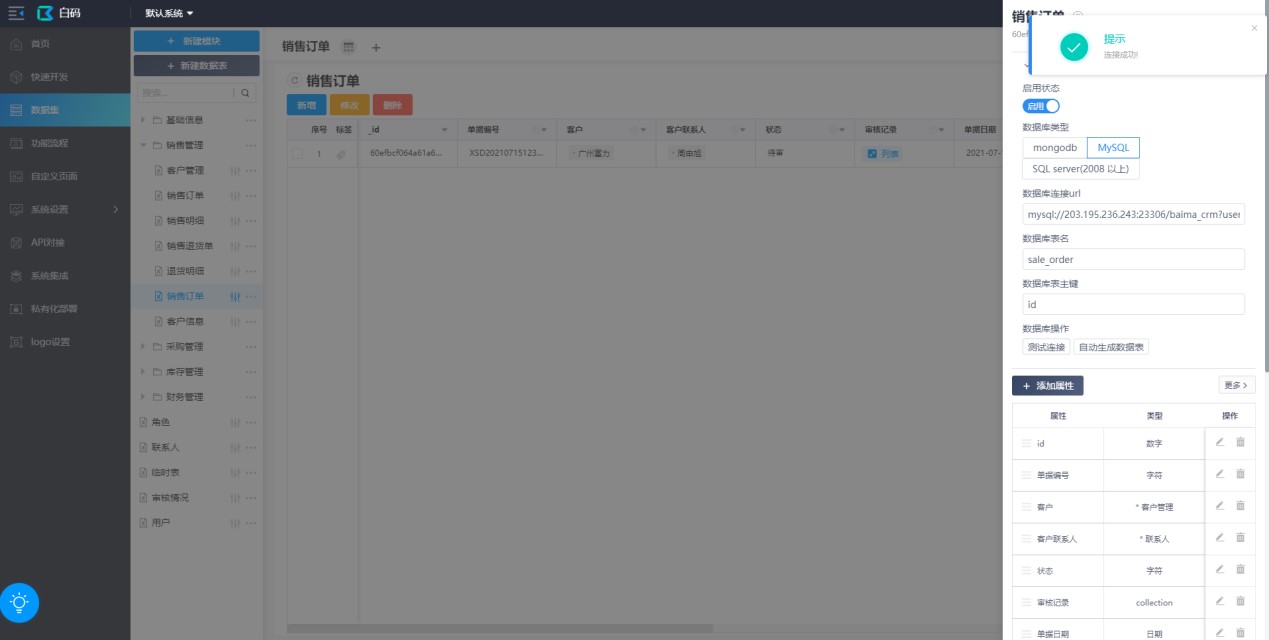
数据库对接配置操作步骤:
- 启用数据库对接功能。
- 选择数据库类型(MySQL)。
- 输入数据库连接URL。
- 输入对应的数据表名。
- 输入刚刚本地创建数据表时设置的主键。
- 点击保存后测试有没有连接成功。
- 点击“自动生成数据表”在本地数据库中自动生成数据表。
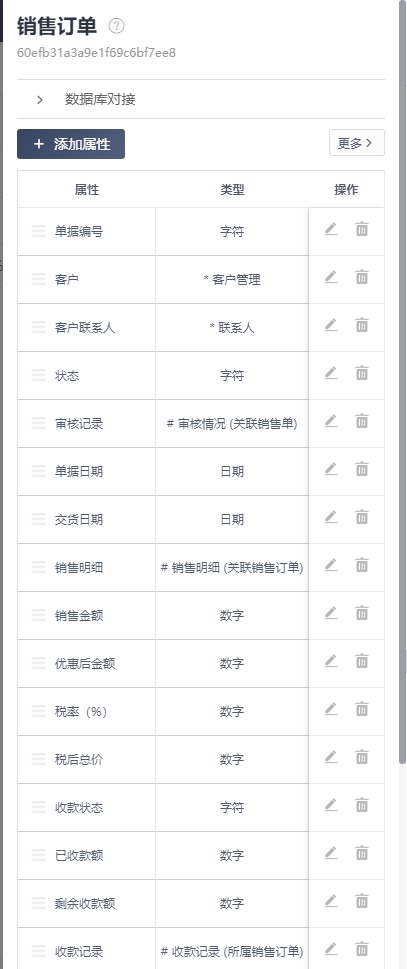
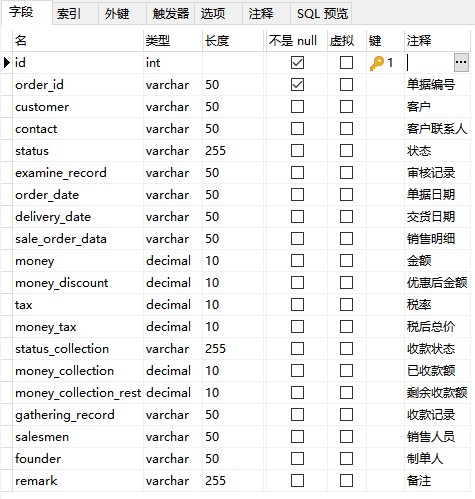
数据表字段类型说明:
- 关联类型对应 varchar 50
- 字符类型对应 varchar 255
- 数字类型对应 decimal
- 时间类型对应 varchar 50
- 日期类型对应 varchar 50
客户信息表字段:
白码:
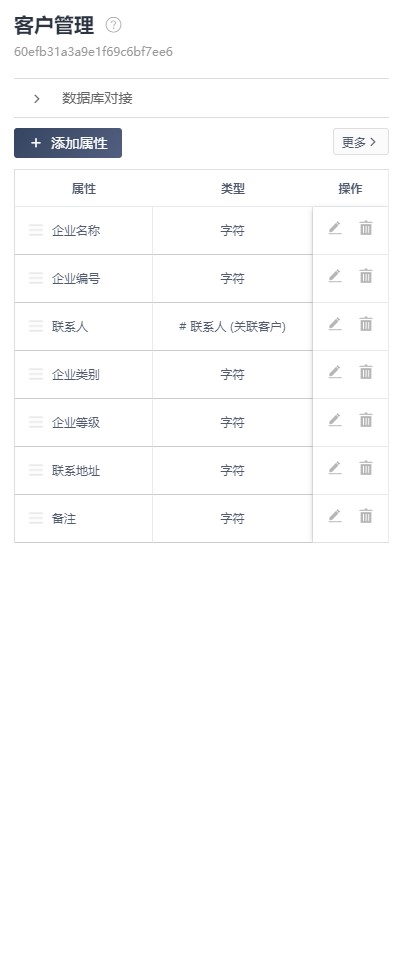
MySQL数据库:
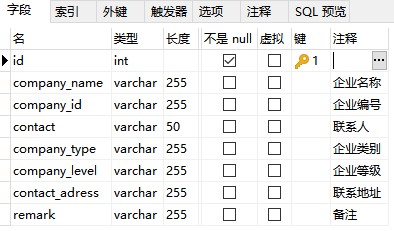
销售订单表字段:
白码:
MySQL数据库:
将白码平台数据存储到MySQL数据库的更多相关文章
- 猫眼电影爬取(一):requests+正则,并将数据存储到mysql数据库
前面讲了如何通过pymysql操作数据库,这次写一个爬虫来提取信息,并将数据存储到mysql数据库 1.爬取目标 爬取猫眼电影TOP100榜单 要提取的信息包括:电影排名.电影名称.上映时间.分数 2 ...
- scrapy数据存储在mysql数据库的两种方式
方法一:同步操作 1.pipelines.py文件(处理数据的python文件) import pymysql class LvyouPipeline(object): def __init__(se ...
- 猫眼电影爬取(二):requests+beautifulsoup,并将数据存储到mysql数据库
上一篇通过requests+正则爬取了猫眼电影榜单,这次通过requests+beautifulsoup再爬取一次(其实这个网站更适合使用beautifulsoup库爬取) 1.先分析网页源码 可以看 ...
- 爬取网贷之家平台数据保存到mysql数据库
# coding utf-8 import requests import json import datetime import pymysql user_agent = 'User-Agent: ...
- 猫眼电影爬取(三):requests+pyquery,并将数据存储到mysql数据库
还是以猫眼电影为例,这次用pyquery库进行爬取 1.简单demo,看看如何使用pyquery提取信息,并将提取到的数据进行组合 # coding: utf-8 # author: hmk impo ...
- Python爬虫抓取东方财富网股票数据并实现MySQL数据库存储
Python爬虫可以说是好玩又好用了.现想利用Python爬取网页股票数据保存到本地csv数据文件中,同时想把股票数据保存到MySQL数据库中.需求有了,剩下的就是实现了. 在开始之前,保证已经安装好 ...
- python3下scrapy爬虫(第十卷:scrapy数据存储进mysql)
上一卷中我将爬取的数据文件直接写入文本文件中,现在我将数据存储到mysql中,我依然用的是pymysql,这个很麻烦建表需要在外面建 这次代码只需要改变pipyline就行 来 现在看下结果: 对比发 ...
- 如何将MongoDB数据库的数据迁移到MySQL数据库中
FAQ v2.0终于上线了,断断续续忙了有2个多月.这个项目是我实践的第一个全栈的项目,从需求(后期有产品经理介入)到架构,再到设计(有征询设计师的意见).构建(前端.后台.数据库.服务器部署),也是 ...
- Python爬取招聘信息,并且存储到MySQL数据库中
前面一篇文章主要讲述,如何通过Python爬取招聘信息,且爬取的日期为前一天的,同时将爬取的内容保存到数据库中:这篇文章主要讲述如何将python文件压缩成exe可执行文件,供后面的操作. 这系列文章 ...
随机推荐
- python使用笔记006-函数+json操作
一.函数 函数:提高代码的复用性 1.1 函数的定义 1 def hello(): 2 print('hello') 3 print('fdsfjslkfs') 4 5 #函数不调用就不会执行 6 h ...
- C语言:缓冲区
缓冲区(Buffer)又称为缓存(Cache),是内存空间的一部分.也就是说,计算机在内存中预留了一定的存储空间,用来暂时保存输入或输出的数据,这部分预留的空间就叫做缓冲区(缓存).有时候,从键盘输入 ...
- C语言:c++ ++c
#include <stdio.h> int main() {int a=3,x; x=(a++)+(++a)+(++a); printf("%d",x); getch ...
- LeetCode 847. Shortest Path Visiting All Nodes
题目链接:https://leetcode.com/problems/shortest-path-visiting-all-nodes/ 题意:已知一条无向图,问经过所有点的最短路径是多长,边权都为1 ...
- 【爬虫系列】0. 无内鬼,破解前端JS参数签名
PS:这是一个系列,坐等我慢慢填坑. PS:不太会直接能跑的代码,抛砖引玉. PS:那些我也不太熟练的就不搞了,包括(破滑块.验证码..) PS: 反编译搞Apk会有很长的几个文章,稍后慢慢更. 最近 ...
- 简单快速安装Apache+PHP+MySql服务环境(一)
由于自己只是普通的coder,对于服务器的操作不是很熟悉,在网上找了很多关于PHP和apache服务器环境搭建的帖子,不过都不尽相同,尤其是编译安装更是看的云里雾里的,所以选择了一种比较简单的方式进行 ...
- 【贪心+排序】排队接水 luogu-1223
题目描述 有n个人在一个水龙头前排队接水,假如每个人接水的时间为Ti,请编程找出这n个人排队的一种顺序,使得n个人的平均等待时间最小. 分析 注意要开longlong AC代码 #include &l ...
- tomcat日志详解
1 tomcat 日志详解 1.1 tomcat 日志配置文件 tomcat 对应日志的配置文件:tomcat目录下的/conf/logging.properties. tomcat 的日志等级有:日 ...
- redis故障时的一些概念
1.缓存穿透 概念访问一个不存在的key,缓存不起作用,请求会穿透到DB,流量大时DB会挂掉. 解决方案采用布隆过滤器,使用一个足够大的bitmap,用于存储可能访问的key,不存在的key直接被过滤 ...
- 对一个sql的分析
select * FROM LPEdorItem a, LCCont b, LPEdorApp c WHERE a.edoracceptno = c.edoracceptno and a.ContNo ...