
分布式ID生成器的解决方案总结
在互联网的业务系统中,涉及到各种各样的ID,如在支付系统中就会有支付ID、退款ID等。那一般生成ID都有哪些解决方案呢?特别是在复杂的分布式系统业务场景中,我们应该采用哪种适合自己的解决方案是十分重要的。下面我们一一来列举一下,不一定全部适合,这些解决方案仅供你参考,或许对你有用。
一个ID一般来说有下面几种要素:
- 唯一性:确保生成的ID是全网唯一的。
- 有序递增性:确保生成的ID是对于某个用户或者业务是按一定的数字有序递增的。
- 高可用性:确保任何时候都能正确的生成ID。
- 带时间:ID里面包含时间,一眼扫过去就知道哪天的交易。
系统时间毫秒数
我们可以使用当前系统时间精确到毫秒数+业务属性+用户属性+随机数+…等参数组合形式来确保ID的唯一性,缺点是ID的有序性难以保证,要保证有序性就要依赖数据库或者其他中间存储媒介。
UUID
Java自带的生成UUID的方式就能生成一串唯一随机32位长度数据,而且够我们用N亿年,保证唯一性肯定是不用说的了,但缺点是它不包含时间、业务数据可读性太差了,而且也不能ID的有序递增。
这是一种简单的生成方式,简单,高效,但在一般业务系统中我还没见过有这种生成方式。
数据库自增ID
我们都知道为数据库主键设置自增序号,以一定的趋势自增,以保证主键ID的唯一性。
这个方案很简单,但最主要的问题在于依赖数据库本身,这就无形增加了对数据库的访问压力和依赖,一旦对单库进行分库分表或者数据迁移就尴尬了。
所以,这也不是合适的ID生成方法。
批量生成ID
一次按需批量生成多个ID,每次生成都需要访问数据库,将数据库修改为最大的ID值,并在内存中记录当前值及最大值。这样就避免了每次生成ID都要访问数据库并带来压力。
这种方案服务就是单点了,如果服务重启势必会造成ID丢失不连续的情况,而且这种方式也不利于水平扩展。
中间件
Redis的所有命令操作都是单线程的,本身提供像incr这样的自增命令,所以能保证生成的ID肯定是唯一有序的。
这种方式不依赖关系数据库,而且速度快。但系统要引入Redis这一中间件,增加维护成本,而且编码和配置工作量比较大。即使已经有了Redis组件,但生成ID的高频率访问对单线程的Redis性能势必也会造成影响。
还可以利用像Zookeeper中的znode数据版本来生成序列号,及MongoDB的ObjectId等,这种利用中间件的做法不是很推荐。
snowflake算法
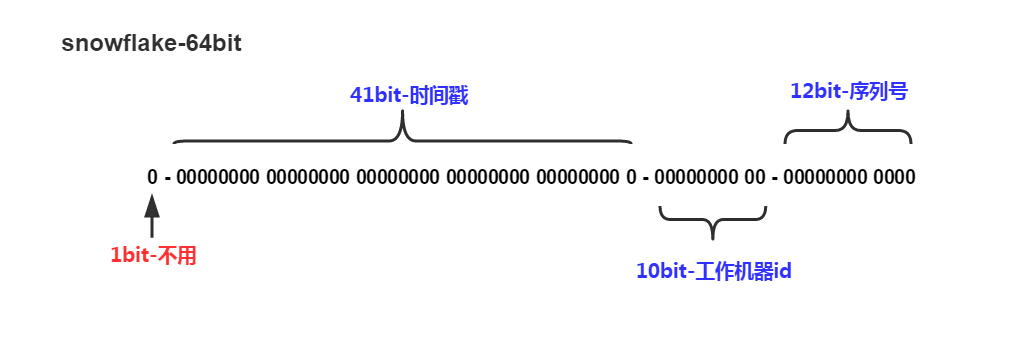
如上图的所示,Twitter的snowflake算法下面几部分组成:
- 41位的时间序列,精确到毫秒,可以使用69年
- 10位的机器标识,最多支持部署1024个节点
- 12位的序列号,支持每个节点每毫秒产生4096个ID序号,最高位是符号位始终为0。
这种方案性能好,在单机上是递增的,但是由于涉及到分布式环境,每台机器上的时钟不可能完全同步,也许有时候也会出现不是全局递增的情况。
而且这个项目在2010就停止维护了,但这个设计思路还是应用于其他各个ID生成器及变种。
UidGenerator
UidGenerator是百度开源的分布式ID生成器,基于于snowflake算法的实现,看起来感觉还行。不过,国内开源的项目维护性真是担忧。
大家可以参考具体使用:
https://github.com/baidu/uid-generator/blob/master/README.zh_cn.md
Leaf
Leaf是美团开源的分布式ID生成器,能保证全局唯一性、趋势递增、单调递增、信息安全,里面也提到了几种分布式方案的对比,但也需要依赖关系数据库、Zookeeper等中间件。
具体可以参考官网说明:
好了,就这么多了,不同的方案应用的场景和系统也是不同的。大家有更好的方案也可以在下面留言,一起讨论下大家都是怎么做的。
推荐阅读
分享Java干货,高并发编程,热门技术教程,微服务及分布式技术,架构设计,区块链技术,人工智能,大数据,Java面试题,以及前沿热门资讯等。
分布式ID生成器的解决方案总结的更多相关文章
- 常用的分布式ID生成器
为何需要分布式ID生成器 **本人博客网站 **IT小神 www.itxiaoshen.com **拿我们系统常用Mysql数据库来说,在之前的单体架构基本是单库结构,每个业务表的ID一般从1增,通过 ...
- c#分布式ID生成器
c#分布式ID生成器 简介 这个是根据twitter的snowflake来写的.这里有中文的介绍. 如上图所示,一个64位ID,除了最左边的符号位不用(固定为0,以保证生成的ID都是正数),还剩余 ...
- 基于redis的分布式ID生成器
基于redis的分布式ID生成器
- 分布式ID生成器PHP+Swoole实现(上) - 实现原理
1.发号器介绍 什么是发号器? 全局唯一ID生成器,主要用于分库分表唯一ID,分布式系统数据的唯一标识. 是否需要发号器? 1)是否需要全局唯一. 分布式系统应该不受单点递增ID限制,中心式的会涉及到 ...
- go语言实现分布式id生成器
本文:https://chai2010.cn/advanced-go-programming-book/ch6-cloud/ch6-01-dist-id.html 分布式id生成器 有时我们需要能够生 ...
- 来吧,自己动手撸一个分布式ID生成器组件
在经过了众多轮的面试之后,小林终于进入到了一家互联网公司的基础架构组,小林目前在公司有使用到架构组研究到分布式id生成器,前一阵子大概看了下其内部的实现,发现还是存在一些架构设计不合理之处.但是又由于 ...
- CosId 通用、灵活、高性能的分布式 ID 生成器
CosId 通用.灵活.高性能的分布式 ID 生成器 介绍 CosId 旨在提供通用.灵活.高性能的分布式系统 ID 生成器. 目前提供了俩大类 ID 生成器:SnowflakeId (单机 TPS ...
- CosId 1.0.0 发布,通用、灵活、高性能的分布式 ID 生成器
CosId 通用.灵活.高性能的分布式 ID 生成器 介绍 CosId 旨在提供通用.灵活.高性能的分布式系统 ID 生成器. 目前提供了俩大类 ID 生成器:SnowflakeId (单机 TPS ...
- CosId 1.0.3 发布,通用、灵活、高性能的分布式 ID 生成器
CosId 通用.灵活.高性能的分布式 ID 生成器 介绍 CosId 旨在提供通用.灵活.高性能的分布式系统 ID 生成器. 目前提供了俩大类 ID 生成器:SnowflakeId (单机 TPS ...
随机推荐
- 什么是php递归
程序调用自身的编程技巧称为递归( recursion).递归做为一种算法在程序设计语言中广泛应用. 一个过程或函数在其定义或说明中有直接或间接调用自身的一种方法,它通常把一个大型复杂的问题层层转化为一 ...
- Cocos2d Box2D之静态刚体
| 版权声明:本文为博主原创文章,未经博主允许不得转载. b2_staticBody 在模拟环境下静态物体是不会移动的,就好像有无限大的质量.在Box2D的内部会将质量至反,存储为零.静态物体也可 ...
- .NET/VB.NET: solving the error “The system cannot find the file specified.” “\Temp\.NETFramework,Version=v4.0.AssemblyAttributes.vb”
Source Link Bumped into this error a while ago in Visual Studio 2010: Kind Error Number 80 Descripti ...
- Oracle学习笔记<5>
组函数(多值函数) 数据库中函数的分类:1)单值函数 Single Rows Functions 特点:n条数据参与函数处理,最终得到n条结果.2)多值函数(组函数) Multiple Rows Fu ...
- POJ 2112 /// 最大流+floyd+二分
题目大意: 有 k台挤奶机 和 c头奶牛 每台挤奶机最多为m头奶牛服务 给定所有挤奶机和奶牛两两之间的距离 求一种分配 使得 奶牛与挤奶机之间的最远距离 最小化 floyd求得所有挤奶机与奶牛两两之间 ...
- maven私服的项目使用配置
环境: eclipse .maven.nexus. 1.配置setting.xml文件 1.1.配置本地仓库位置:文件中,存在节点 “localRepository”,默认是注释,也就是本地仓库使用 ...
- hashlib加密模块,加密方式:(MD5,sha级别)
三,hashlib模块 算法介绍 Python的hashlib提供了常见的摘要算法,如MD5,SHA1等等. 什么是摘要算法呢?摘要算法又称哈希算法.散列算法.它通过一个函数,把任意长度的数据转换为一 ...
- Codeforces 1195E. OpenStreetMap (单调队列)
题意:给出一个n*m的矩形.询问矩形上所有的a*b的小矩形的最小值之和. 解法:我们先对每一行用单调栈维护c[i][j]代表从原数组的mp[i][j]到mp[i][j+b-1]的最小值(具体维护方法是 ...
- jvm加载包名和类名相同的类的规则,以及如何加载包名和类名相同的类(转)
jvm包括三种类加载器: 第一种:bootstrap classloader:加载java的核心类. 第二种:extension classloader:负责加载jre的扩展目录中的jar包. 第三种 ...
- Struts2关于命名空间的例子
佐证了这样一个原则,package存在,但action没找到,就自动去默认空间去找.如果package不存在,则自动向上一级目录找,一级级倒到根目录. 根目录再没找到,再去默认目录找 网上对于命名空 ...