
2019-03-22 Python Scrapy 入门教程 笔记
Python Scrapy 入门教程
入门教程笔记:
# 创建mySpider

scrapy startproject mySpider

# 创建itcast.py

cd C:\Users\theDataDiggers\mySpider\mySpider\spiders

scrapy genspider itcast "itcast.cn"

# itcast(itcast.py name)---ItcastSpider(类名)

#该类有3个强制的属性,和一个解析的方法(属性为name allowed_domains start_urls)

# 执行itcast.py

scrapy crawl itcast

scrapy crawl itcast -o teachers.csv

#在没有学习scrapy时,我们是先请求数据,然后返回数据的

response=request.get(url)

soup=BeautifulSoup(response.text,'lxml')

soup.select()

#学习了Scrapy后,发现

def parse(self,response):

#自带response,你可以进行以下操作

response.body()

response.xpath()

#顺便还复习了一下类的继承

class ItcastSpider(scrapy.Spider):

class ItcastItem(scrapy.Item):

class MyspiderPipeline(object):

#还有引用其它Python文件的类

from mySpider.items import ItcastItem
学习目标
- 创建一个Scrapy项目
- 定义提取的结构化数据(Item)
- 编写爬取网站的 Spider 并提取出结构化数据(Item)
- 编写 Item Pipelines 来存储提取到的Item(即结构化数据)
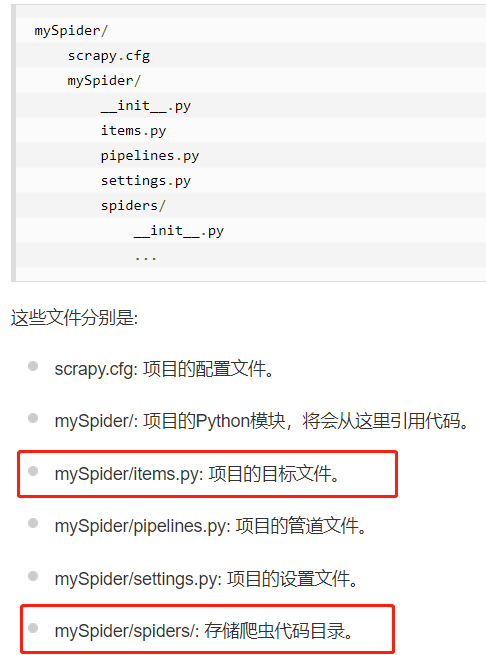
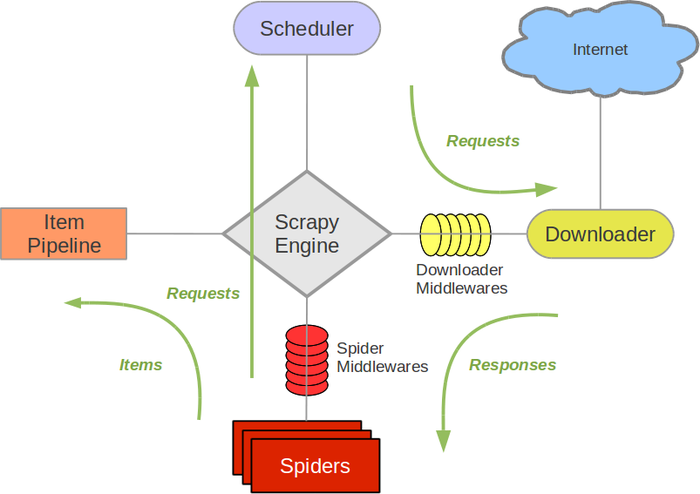
Scrapy Engine(引擎): 负责Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。
Scheduler(调度器): 它负责接受引擎发送过来的Request请求,并按照一定的方式进行整理排列,入队,当引擎需要时,交还给引擎。
Downloader(下载器):负责下载Scrapy Engine(引擎)发送的所有Requests请求,并将其获取到的Responses交还给Scrapy Engine(引擎),由引擎交给Spider来处理,
Spider(爬虫):它负责处理所有Responses,从中分析提取数据,获取Item字段需要的数据,并将需要跟进的URL提交给引擎,再次进入Scheduler(调度器).
Item Pipeline(管道):它负责处理Spider中获取到的Item,并进行进行后期处理(详细分析、过滤、存储等)的地方。
Downloader Middlewares(下载中间件):你可以当作是一个可以自定义扩展下载功能的组件。
Spider Middlewares(Spider中间件):你可以理解为是一个可以自定扩展和操作引擎和Spider中间通信的功能组件(比如进入Spider的Responses;和从Spider出去的Requests)
2019-03-22 Python Scrapy 入门教程 笔记的更多相关文章
- [转]Scrapy入门教程
关键字:scrapy 入门教程 爬虫 Spider 作者:http://www.cnblogs.com/txw1958/ 出处:http://www.cnblogs.com/txw1958/archi ...
- Scrapy入门教程
关键字:scrapy 入门教程 爬虫 Spider作者:http://www.cnblogs.com/txw1958/出处:http://www.cnblogs.com/txw1958/archive ...
- Python爬虫入门教程 43-100 百思不得姐APP数据-手机APP爬虫部分
1. Python爬虫入门教程 爬取背景 2019年1月10日深夜,打开了百思不得姐APP,想了一下是否可以爬呢?不自觉的安装到了夜神模拟器里面.这个APP还是比较有名和有意思的. 下面是百思不得姐的 ...
- Scrapy入门教程(转)
关键字:scrapy 入门教程 爬虫 Spider作者:http://www.cnblogs.com/txw1958/出处:http://www.cnblogs.com/txw1958/archive ...
- Python基础入门教程
Python基础入门教程 Python基础教程 Python 简介 Python环境搭建 Python 基础语法 Python 变量类型 Python 运算符 Python 条件语句 Python 循 ...
- Python爬虫入门教程 48-100 使用mitmdump抓取手机惠农APP-手机APP爬虫部分
1. 爬取前的分析 mitmdump是mitmproxy的命令行接口,比Fiddler.Charles等工具方便的地方是它可以对接Python脚本. 有了它我们可以不用手动截获和分析HTTP请求和响应 ...
- 无废话MVC入门教程笔记
自学mvc,看了园子里李林峰写的李林峰写的无废话MVC入门教程笔记,现在有的平时忽略的或是不太清楚的点记下来 1,Html.DropDownList //服务端写法 @{ //下拉列表的值 List& ...
- python之scrapy入门教程
看这篇文章的人,我假设你们都已经学会了python(派森),然后下面的知识都是python的扩展(框架). 在这篇入门教程中,我们假定你已经安装了Scrapy.如果你还没有安装,那么请参考安装指南. ...
- Python爬虫入门教程 37-100 云沃客项目外包网数据爬虫 scrapy
爬前叨叨 2019年开始了,今年计划写一整年的博客呢~,第一篇博客写一下 一个外包网站的爬虫,万一你从这个外包网站弄点外快呢,呵呵哒 数据分析 官方网址为 https://www.clouderwor ...
随机推荐
- python中的各个包的安装,用pip安装whl文件
在安装之前,一直比较迷惑究竟如何用,安装完后,发现竟然如此简单 首先我一般用的是python27,官网下载python27msi安装window7 64位后,已经自带了Pip 和 easy_insta ...
- 2015 Multi-University Training Contest 8 hdu 5383 Yu-Gi-Oh!
Yu-Gi-Oh! Time Limit: 2000ms Memory Limit: 65536KB This problem will be judged on HDU. Original ID: ...
- POJ 1091
这题确实是好. 其实是求x1*a1+x2*a2+....M*xn+1=1有解的条件.很明显,就是(a1,a2,...M)=1了.然后,可以想象,直接求有多少种,很难,所以,求出选择哪些数一起会不与M互 ...
- 每天自己主动备份mysql脚本
定时运行脚本: 1.运行 crontab -e 00 00 * * * /bin/bash yourpath/mysqlbak.sh 2.打开自己主动运行文件 vi /etc/crontab 在etc ...
- asp.net学习指南
个人总结了一些不错的基础视频教程 视频链接地址(猛戳这里)
- MongoDB初探系列之四:MongoDB与Java共舞
因为版本号不同,可能API也有所不同.本次学习用的是3.0版本号. 1.使用的mongodb的jdbc驱动版本号为:mongo-java-driver-3.0.0.jar 2.本节仅仅是简介JDBC操 ...
- Mac OS下PHP开发环境的搭建——基于XAMPP和IntelliJ IDEA
简单记录一下在MacOS下,搭建PHP的开发环境吧.其实,从本质上来说,Mac对于PHP的支持还是很好的,默认带了PHP和Apache,但是由于前期对系统本身不熟悉,所以还是略微走了一些弯路--也就是 ...
- Noip前紧急抢救
管他会不会,知道结论就好了 紧急抢救知识 斯特林数 第一类斯特林数 递推公式 \[ S[n][k]=(n-1)\times S[n-1][k]+S[n-1][k-1] \] 处理的问题是将n个数划分为 ...
- tomcat开启https服务
一.创建证书 证书是单点登录认证系统中很重要的一把钥匙,客户端于服务器的交互安全靠的就是证书:本教程由于是演示所以就自己用JDK自带的keytool工具生成证书:如果以后真正在产品环境中使用肯定要去证 ...
- Core篇——初探Core的Http请求管道&&Middleware
目录: 1.Core 处理HTTP请求流程 2.中间件(Middleware)&&处理流程 3.创建自定义中间件&&模拟Core的请求管道 Core 处理HTTP请求流 ...