
(21)Oracle表查询进阶
转到基本查询
一、多表查询
笛卡尔积:每张表的列数相加,行数相乘。
连接条件:得出笛卡尔积后需要用where条件筛选出正确的数据。连接条件至少需要n张表减1个
1.等值连接
连接条件为等号
select t1.a,t1.b,t1.c,t2.d from table t1,t2 where t1.c=t2.c
2.不等值连接
select t1.a,t1.b,t1.c,t2.d from table t1,t2 where t1.c between t2.e and t2.f --between and 小值在前,大值在后
3.外连接(把对于连接条件不成立的数据包含在最近的结果中)
SELECT 语句必须拥有相同数量的列,相似的数据类型,和相同的顺序。这种条件下能合并表
SELECT column_name(s) FROM table_name1

UNION

SELECT column_name(s) FROM table_name2
union 去重,union all不去重
inner join(join)内连接
左外连接:当连接条件不成立时,等号左边的表依然被包含在结果中
left join
右外连接:当连接条件不成立时,等号右边的表依然被包含在结果中
right join
full join
4.自连接
一张表起两个别名,当做两张表来用。
自接连不适合查询大表
5.层次查询
对于树型结构的单表查询
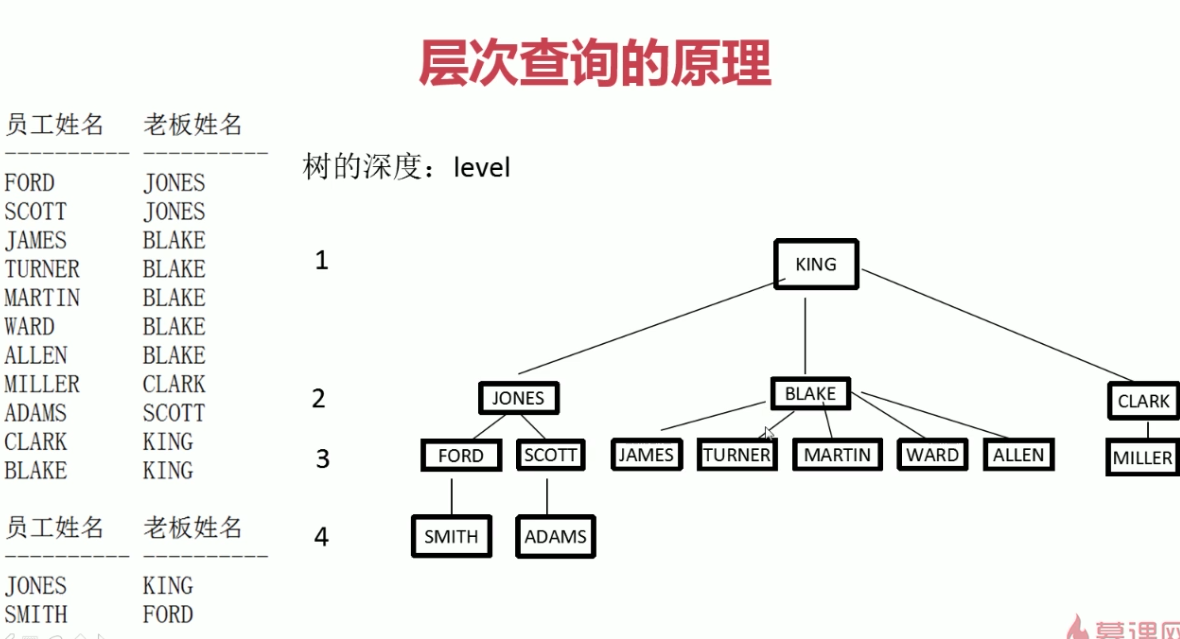
select * from table connect by 上一层字段=本层字段 start with 分支的定点字段=xxx;
如果从根节点开始查询还可以写成 : start with 上层字段 is null
select * from table connect by 上一层字段=本层字段 start with 上层字段 is null;
注意 :上层字段和本层字段是不同的两个列
二、行转列
先建表,插入数据
create table fruits(id int,name varchar(20),place varchar(20),amount int);  ---- 创建表

/

insert into fruits values(1, '苹果','河北', 1000);

/

insert into fruits values(2, '苹果','浙江', 1000);

/

insert into fruits values(3, '苹果','河北', 1000);

/

insert into fruits values(4, '橘子','浙江', 1000);

/

insert into fruits values(5, '橘子','河北', 1000);

/

insert into fruits values(6, '葡萄','浙江', 1000);

/

insert into fruits values(7, '芒果','浙江', 1000);

/

insert into fruits values(8, '芒果','浙江', 1000);

/
行转列sql
select * from (select PLACE,NAME,AMOUNT from FRUITS) pivot (sum(AMOUNT) for NAME in('苹果','橘子' as 橙子,'葡萄' 葡萄))
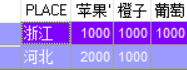
pivot(聚合函数 for 列名 in(类型)
等同于
WITH t AS (SELECT PLACE, NAME, AMOUNT FROM FRUITS)

SELECT *

  FROM t PIVOT (SUM (AMOUNT)

         FOR NAME

         IN ('苹果', '橘子' AS 橙子, '葡萄' 葡萄))
使用 with as 的原因:1优化速度 2方便阅读
三、条件控制
 SELECT name,

         score,

         CASE     --如果

            WHEN score >= 90 THEN '优'   --当...那么...

            WHEN (80 <= score AND score < 90) THEN '良'

            WHEN (60 <= score AND score < 80) THEN '中'

            ELSE '差'

         END      --结束

            AS 评价

    FROM student

   WHERE 1 = 1

ORDER BY score DESC
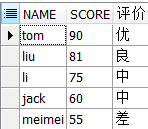
四、分组查询
分组函数
1.avg()平均(avg函数会过滤掉空值), sum()求和
select avg(字段名) ,sum(字段名) from table
2.min()最小值,max()最大值
select min(字段名), max(字段名) from table
3.count()统计个数
select count(*) from table

select count(字段名) from table
select count( distinct 字段名) from table --去掉某字段重复数据后,再统计行数
4.nvl() 为空时替换
select count(nvl(字段名,0)) from table --当字段名有数据为空时,会把他替换成第二个参数
5.gourp by
select 需要分组的字段, 分组函数(需要统计的字段) from table group by 需要分组的字段

select a,b,c, max(x) from table group by a,b,c --所有未包含在分组函数的列,都必须在 group by 中表示出来
当执行多个列分组时,先执行 a分组,分组后b如果有重复再执行b分组。
6. having
where 和 having 都是筛选条件,区别是 where 子句中不能使用分组函数
select a,avg(b) from table group by a having avg(b) ;
其他条件下通用
select a,avg(b) from table group a by having a=10;

select a,avg(b) from table where=10 group by a;
在sql的优化角度考虑尽量使用where
7.分组查询的中order by
可以按照: 列,别名,表达式,序号排列
select a,avg(b) from table group by a order by avg(b) ; --按b升序排列

select a,avg(b)  as 平均工资 from table group by a order by 平均工资 ;--按别名

select a,avg(b)  as  from table group by a order by 2; --按序号
8.分组嵌套
平均工资的最大值
select max(avg(b)) from table group by b;
9.group by 增强语句
group by rollup(a,b)
五、子查询
select * from t1 where t1.a>(select t2.b from t2 where ...);
注意问题
.可以写子查询的位置: where ,select ,having,from
.不可以使用子查询的位置 group by
六、排重
select PROD_NORM_CODE,REMARK from T_MD_PROD_NORM GROUP BY PROD_NORM_CODE,REMARK having count(PROD_NORM_CODE)>1
正则表达式 查询所有是数字的
REGEXP_LIKE(列名,'(^[+-]?\d{0,}\.?\d{0,}$)');
剔除改字段下非数字数据,然后转成数字,四舍五入保留三位小数
select round (to_number(列名),3) as 列名 from table1 where REGEXP_LIKE(列名,'(^[+-]?\d{0,}\.?\d{0,}$)');
(21)Oracle表查询进阶的更多相关文章
- oracle 表查询(2)
使用逻辑操作符号 问题:查询工资高于500 或者是岗位为MANAGER 的雇员,同时还要满足他们的姓名首字母为大写的J? or job = 'MANAGER') and ename LIKE 'J%' ...
- oracle 表查询(1)
oracle 表基本查询 介绍在我们讲解的过程中我们利用scott 用户存在的几张表(emp,dept)为大家演示如何使用select语句,select 语句在软件编程中非常有用,希望大家好好的掌握. ...
- (六)Oracle 的 oracle表查询关键字
参考:http://www.hechaku.com/Oracle/oracle_tables2.html 1.使用逻辑操作符号问题:查询工资高于500或者是岗位为manager的雇员,同时还要满足他们 ...
- 第五章、Django之多表查询进阶与事务
目录 第五章.Django之多表查询 一.聚合查询 二.分组查询 三.F与Q查询 四.查询优化 五.Django开启事务 六.自定义char字段 七.ORM常用字段 第五章.Django之多表查询 一 ...
- oracle表查询
使用scott用户中存在的emp.dept表等做演示 一.单表查询 查看表结构:desc dept; 查看所有列:select * from dept: 查询指定列:select ename,sal, ...
- oracle 表查询二
1.使用逻辑操作符号问题:查询工资高于500或者是岗位为manager的雇员,同时还要满足他们的姓名首字母为大写的J?select * from emp where (sal > 500 or ...
- 七、oracle 表查询二
1.使用逻辑操作符号问题:查询工资高于500或者是岗位为manager的雇员,同时还要满足他们的姓名首字母为大写的J?select * from emp where (sal > 500 or ...
- oracle 表查询(二)
1.使用逻辑操作符号问题:查询工资高于500或者是岗位为manager的雇员,同时还要满足他们的姓名首字母为大写的J?select * from emp where (sal > 500 or ...
- 七 oracle 表查询二
1.使用逻辑操作符号问题:查询工资高于500或者是岗位为manager的雇员,同时还要满足他们的姓名首字母为大写的J?select * from emp where (sal > 500 or ...
随机推荐
- HDU:1358-Period
Period Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others) Problem Desc ...
- 产生指定时间区间序列、按指定单位变化时间 python实现
示例1:给定起始日期和结束日期,如何得到中间的时间序列 import datetime def dateRange(beginDate, endDate): dates = [] dt = datet ...
- mysql练习题练习
1.数据库是按照原文制作的,表格结构一样具体存储的数据有些差异 原文地址:MySQL练习题 原答案地址:MySQL练习题参考答案 2.查询“生物”课程比“物理”课程成绩高的所有学生的学号: selec ...
- 【POI 2010】反对称 Antisymmetry
题目: 对于一个 $0/1$ 字符串,如果将这个字符串 $0$ 和 $1$ 取反后,再将整个串反过来和原串一样,就称作「反对称」字符串.比如 $00001111$ 和 $010101$ 就是反对称的, ...
- Selenium Java 自动化 介绍及开发工具的使用(一)
前言 目前selenium版本已经升级到3.0了,网上的大部分教程是基于2.0写的,所以在学习前先要弄清楚版本号,这点非常重要.本系列依然以selenium2为基础,目前selenium3本人没做过研 ...
- Leetcode 623.在二叉树中增加一行
在二叉树中增加一行 给定一个二叉树,根节点为第1层,深度为 1.在其第 d 层追加一行值为 v 的节点. 添加规则:给定一个深度值 d (正整数),针对深度为 d-1 层的每一非空节点 N,为 N 创 ...
- 如何利用c++编写不能被继承、但可以在类外定义对象的类
#include <iostream> #include<string> #include<map> #include<vector> #include ...
- redis.clients.jedis.exceptions.JedisDataException: MISCONF Redis is configured to save RDB snapshots
最近在学习Redis ,在写test测试的时候碰到这个报错: redis.clients.jedis.exceptions.JedisDataException: MISCONF Redis is c ...
- Puppet单机实战之Nginx代理Tomcat
author:JevonWei 版权声明:原创作品 blog:http://119.23.52.191/ --- 构建实战之Nginx代理Tomcat [root@node1 modules]# mk ...
- 【bzoj3930】[CQOI2015]选数 莫比乌斯反演+杜教筛
题目描述 我们知道,从区间[L,H](L和H为整数)中选取N个整数,总共有(H-L+1)^N种方案.小z很好奇这样选出的数的最大公约数的规律,他决定对每种方案选出的N个整数都求一次最大公约数,以便进一 ...