
解开Batch Normalization的神秘面纱
停更博客好长一段时间了,其实并不是没写了,而是转而做笔记了,但是发现做笔记其实印象无法更深刻,因此决定继续以写博客来记录或者复习巩固所学的知识,与此同时跟大家分享下自己对深度学习或者机器学习相关的知识点,当然浅薄之见如有说错表达错误的,欢迎大家指出来。废话不多说,进入今天的主题:Batch Normalization。
Batch Normalization(BN)是由Sergey Ioffe和Christian Szegedy在2015年的时候提出的,后者同时是Inception的提出者(深度学习领域的大牛),截止至动手写这篇博客的时候Batch Normalization的论文被引用了12304次,这也足以说明BN被使用地有多广泛。在正式介绍BN之前,有必要了解下feature scaling(特征归一化),这是不论做传统机器学习也好或者现在深度学习也好,预处理阶段可以说是必不可少的一步也是确保模型能够正常学习非常重要的一步。
1、为什么需要使用feature scaling?
Feature scaling指的是对输入的数据特征进行归一化操作(一般有min-max normalization或者min-max standardization两种)以确保所有特征的值处于同一维度。假设现在有x1和x2是两个特征,从公式a = Sigmoid(WTX + b)计算loss可以知道,如果x1和x2的特征值差别很大的话但是假设他们对结果的影响力一致的话(如下图所示),那么意味着w1的数值维度会比较大, w2的数值维度则会比较小,而如果要使w1和w2有一个同等的变化(如果这样子需要设置不同的learning rate进行更新,针对w2的步长要设置编辑哦大而w1比较小来更新,以此来使模型的loss达到收敛,参照图2来理解,这里要稍微想象一下,我最开始也比较困惑为什么使如此),那么意味着x1w1的结果就比较小,而x2w2的结果会比较大(根据个人建模的经验来说,如果特征数值维度差别很大的话,一般模型很难训练,直白点说就是loss几乎不收敛,可能刚开始收敛,后面就乱串了,有其他经历的朋友可以留言告知下)。由此可以影响训练速度和精度,因为针对不同的特征,需要不同的学习率来调整,由此拖慢了训练速度。
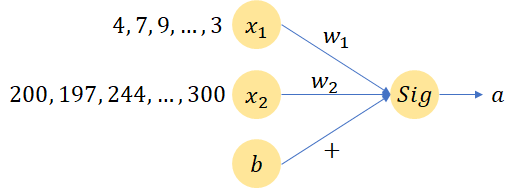
图1 简单的神经元计算流程
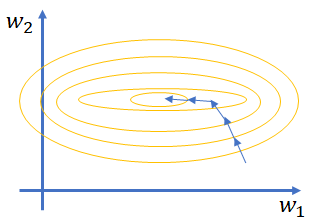
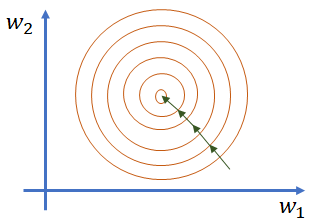
图2 特征值差异较大时的训练过程(左)和特征值大小处于同一维度的训练过程(右)
一般的feature scaling是如何做呢?计算每个dimension的mean和每个dimension的std(feature scaling之后的每一维的值的均值为0,方差为1),做feature scaling之后梯度下降收敛会快点。当对输入的特征做完feature scaling之后,不免会引起一定困惑,那就是在神经网络中由于网络结构含有多层隐藏层,每一层隐藏层的输入时下一层的输入,那么这些隐藏层的输入(下面统一用这种说辞,避免混淆)是否需要也进行feature scaling呢?经过Sergey Ioffe和Christian Szegedy的验证答案是肯定的。
2、神经网络中隐藏层为什么要做feature scaling?
2.1 Internal Covariate Shift
在正式进入正题之前,同样十分有必要解释下Internal Covariate shift(ICS)是什么以及对深度学习训练模型的影响?在此之前,又得再先确认一个概念,那就是:深度学习和机器学习在进行模型训练的时候都是基于数据IID(Independently identically distribution,独立同分布)的情况。那什么是独立同分布呢?独立(两个事件没有关联)意味着数据之间(一般指训练数据和测试数据,测试数据一般又指未见过的数据)是相互独立的,同分布则指明数据具有相同分布形状并且具有相同分布的参数(这里可以想象下为为什么针对采样自统一分布的数据进行模型训练和学习,例如想象下参数的变化,数据集拆分符合分布规律等等,也就能明白IID是如何影响深度学习模型和机器学习模型的),更直观点说就是选取用于训练的数据要具有全局代表性,以便可以对未知的数据进行预测。
那什么又是ICS呢?在神经网络的设计往往都是含有多个隐藏层,而像之前说的当前隐藏层的输出是下一个隐藏层的输入,把这个输入当作一个分布来看的话,而由于为了使训练收敛参数不断处于更新之中,当前隐藏层的参数更新之后会影响下一个隐藏层的输入,也就是说由于参数的改变,输入改变了(也就是分布改变了),这个跟基于IID的假设是相违背的,出现这种现象则称之为ICS(可通过设置小一点的学习率可以改善,但是小的学习率影响训练速度因为步长变短了)。
2.2 Batch Normalization
为了降低ICS所带来的影响,BN就被提出来了。这里我们来看下通常神经网络结构是如何设计的: x with feature scaling -> layer1 -> a1(feature scaling?) -> layer2 -> a2(feature scaling?) 。那既然是叫Batch Normalization,那么就意味着这个normalization是针对一个Batch一个batch的。这里再复习下Batch训练的一些基本原理,batch的意思是训练网络的时候一次性拿几个样本并行的做计算,比如batch=4,那么就是四个样本作为输入一起乘上同一个参数(如下图3所示)。
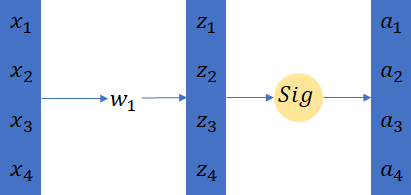
图3 Batch Training
实际运算中,batch=4的四个样本会被拼成一整个matrix,这里从编程的角度想想会更好理解,例如要对1万张图片进行训练,选取batch=4,假设每个图片的高和宽为224和224,通道数为3,那么他们的shape就是(4,224,224,3),这个用numpy或者PyTorch或者TensorFlow来在电脑上展示出来都是一个矩阵。Batch normalization是如何作用在batch上的呢?一般是先BN后activation,如果先做activation再做BN的话,input就有可能落在saturation值域上(tanh和sigmoid都容易存在这个问题),那么就会产生gradient vanishing(梯度消失)的问题。接下来看看Batch Normalization的计算,一般是基于batch计算μ和σ的(均值和标准差),由于整个数据集量很大,如果是针对整个数据集计算μ和σ的话,那么计算开销很大,所以BN是作用在batch上的数据,这也由此引申出一个问题,那就是在使用BN的时候,batch应该尽量设置比较大(batch < n where n is the number of samples),BN的计算演示图如下图所示:

图4 引入BN的神经网络结构图
那么使用BN的话怎么进行训练呢?使用BN的时候,在做BP的时候也同样需要去更新计算出来的batch的μ和σ,因为μ和σ也会影像training loss。在经过BN之后,数据的值的分布是服从mean为0,方差为1的。但是有时候并不是服从这样子的分布才是网络更robust,所以此时希望对做了BN之后的数值做一个scale和偏移。这也就是论文中的β和γ存在的因素。但是仔细的人应该可以看出来,最后一个公式是计算μ和σ的来normalize输入的逆过程,如果当μ、σ(calculated from batch)和γ、β一样的话,就等于BN没有任何作用。但是此时需要注意的是,μ和σ是受到每一层的输入的影响的,但是γ和β是独立的,不受输入的影响,并且γ和β是整个网络的参数。通过上面的讲述,可以清楚看到BN在训练神经网络模型的过程中引入了四个新的需要被训练的参数:μ、σ、γ和β。下图是来自论文的上述参数的每个计算公示:
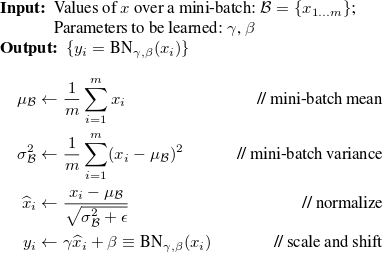
图5 原论文中的计算公式
使用BN在测试阶段同样会遇到一个问题,因为我们知道在training的时候是一个Batch一个Batch进行训练的,但是测试的时候(做预测时)是没有所谓的batch之说的。这个时候一个比较实用的操作就是计算在训练过程μ和σ的moving average,并且让在靠近训练结束的位置占比较大的权重,而刚开始训练的时候占比较小的权重。
最后,来看看使用BN所带来的好处都有哪些:
- 减少训练时间,这是因为ICS所带来的的影响减小了,由此可以使用较大的学习率;
- 避免梯度爆炸或者梯度消失(尤其在使用sigmoid和tanh这类激活函数的时候);
- 学习率受参数初始化的影响减小;
- 让训练的模型不那么容易过拟合(overfitting);
- 减少对正则化的依赖(如减少使用dropout);
解开Batch Normalization的神秘面纱的更多相关文章
- 解开SQL注入的神秘面纱-来自于宋沄剑的分享
解开SQL注入的神秘面纱-来自于宋沄剑的分享 https://files.cnblogs.com/files/wxlevel/揭开SQL注入的神秘面纱.pdf
- 解开Service Mesh的神秘面纱
一.什么是Service Mesh? 下面是 Willian Morgan 对 Service Mesh 的解释: A Service Mesh is a dedicated infrastructu ...
- 解开lambda最强作用的神秘面纱
我们期待了很久lambda为java带来闭包的概念,但是如果我们不在集合中使用它的话,就损失了很大价值.现有接口迁移成为lambda风格的问题已经通过default methods解决了,在这篇文章将 ...
- 解开Future的神秘面纱之任务执行
此文承接之前的博文 解开Future的神秘面纱之取消任务 补充一些任务执行的一些细节,并从全局介绍程序的运行情况. 任务提交到执行的流程 前文我们已经了解到一些Future的实现细节,这里我们来梳理一 ...
- JavaScript基本知识点——带你逐步解开JS的神秘面纱
JavaScript基本知识点--带你逐步解开JS的神秘面纱 在我们前面的文章中已经深入学了HTML和CSS,在网页设计中我们已经有能力完成一个美观的网页框架 但仅仅是网页框架不足以展现出网页的魅力, ...
- 揭开Docker的神秘面纱
Docker 相信在飞速发展的今天已经越来越火,它已成为如今各大企业都争相使用的技术.那么Docker 是什么呢?为什么这么多人开始使用Docker? 本节课我们将一起解开Docker的神秘面纱. 本 ...
- 揭开Redis的神秘面纱
本篇博文将为你解开Redis的神秘面纱,通过阅读本篇博文你将了解到以下内容: 什么是Redis? 为什么选择 Redis? 什么场景下用Redis? Redis 支持哪些语言? Redis下载 Red ...
- 揭开Future的神秘面纱——任务执行
前言 此文承接之前的博文 解开Future的神秘面纱之取消任务 补充一些任务执行的一些细节,并从全局介绍程序的运行情况. 系列目录 揭开Future的神秘面纱——任务取消 揭开Future的神秘面纱— ...
- [C2W3] Improving Deep Neural Networks : Hyperparameter tuning, Batch Normalization and Programming Frameworks
第三周:Hyperparameter tuning, Batch Normalization and Programming Frameworks 调试处理(Tuning process) 目前为止, ...
随机推荐
- Usaco Training [1.3] wormhole
传送门 解题要素:代码能力 解题步骤:理解题意 - >搜索枚举所有可能的配对情况 - >判断冲突并求解 - >调试 一. 理解题意 这里讲几个不容易理解的点: 1. +x方向 即向右 ...
- Hadoop 系列(八)—— 基于 ZooKeeper 搭建 Hadoop 高可用集群
一.高可用简介 Hadoop 高可用 (High Availability) 分为 HDFS 高可用和 YARN 高可用,两者的实现基本类似,但 HDFS NameNode 对数据存储及其一致性的要求 ...
- 初识代理——Proxy
无处不在的模式——Proxy 最近在看<设计模式之禅>,看到代理模式这一章的时候,发现自己在写spring项目的时候其实很多时候都用到了代理,无论是依赖注入.AOP还是其他,可以说是无处不 ...
- 全球十大OTA 谁能有一席之地?
全球十大OTA 谁能有一席之地? http://www.traveldaily.cn/article/78381/1 2014-03-05 来源:i黑马 随着旅游行业日新月异的发展,在线旅游网站的出现 ...
- 轻量级移动端类库,大小20多k,支持多指触摸。
/* * 移动端 公共类库 * 作者:hqs */ (function(global, factory) { // cmd commonjs if (typeof module === "o ...
- Appium+python自动化(三十一)- 元芳,你怎么看? - 日志收集-logging(超详解)
简介 生活中的日志是记录你生活的点点滴滴,让它把你内心的世界表露出来,更好的诠释自己的内心世界,而电脑里的日志是有价值的信息宝库. 日志文件是专门用于记录系统操作事件的记录文件或文件集合,操作系统有操 ...
- (一)c#Winform自定义控件-基类控件
前提 入行已经7,8年了,一直想做一套漂亮点的自定义控件,于是就有了本系列文章. 开源地址:https://gitee.com/kwwwvagaa/net_winform_custom_control ...
- 学习Vuex 个人的一些拙见。
首先说下什么是vuex?这个是对vue的状态的管理,这样说可能有点大,其实就是vue 里面 data 的管理,或者说是多个vue 组件共有的data 的一种管理, 在任何一个组件里面,都可以修改,访 ...
- 基于Spring Boot自建分布式基础应用
目前刚入职了一家公司,要求替换当前系统(单体应用)以满足每日十万单量和一定系统用户负载以及保证开发质量和效率.由我来设计一套基础架构和建设基础开发测试运维环境,github地址. 出于本公司开发现状及 ...
- restapi(5)- rest-mongo 应用实例:分布式图片管理系统之一,rest 服务
最近有同事提起想把网页上的图片存在MongoDB里,我十分赞同.比起把图片以文件形式存放在硬盘子目录的方式,MongoDB有太多的优势.首先,MongoDB是分布式数据库,图片可以跨服务器存储.在一个 ...