
8.15 day33 进程池与线程池_协程_IO模型(了解)
进程池和线程池
开进程开线程都需要消耗资源,只不过两者比较的情况线程消耗的资源比较少
在计算机能够承受范围之内最大限度的利用计算机
什么是池?
在保证计算机硬件安全的情况下最大限度地利用计算机
池其实是降低了程序的运行效率 但是保证了计算机硬件的安全
(硬件的发展跟不上软件的速度)
线程池进程池
括号内可以传参数指定线程池内的线程个数
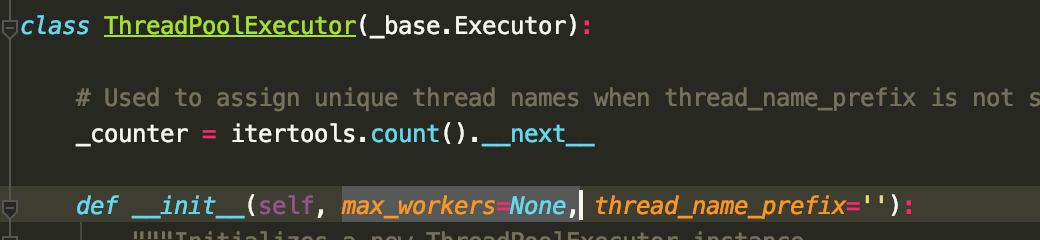
也可以不传 不传默认是当前cpu核数*5
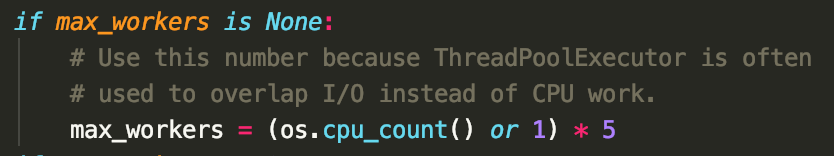
提交任务的方式:
同步:提交任务之后,原地等待任务的结果,期间不做任何事
异步:提交任务后,不等待任务的返回结果(异步的结果怎么拿?),直接执行下一行代码
进程池/线程池的创建和提交回调
from concurrent.futures import ThreadPoolExecutor,ProcessPoolExecutor

import time

import os

# pool = ThreadPoolExecutor(5)  # 线程 # 括号内可以传参数指定线程池内的线程个数

# # 也可以不传  不传默认是当前所在计算机的cpu个数乘5

pool = ProcessPoolExecutor()  # 进程 # 默认是当前计算机cpu的个数

"""

池子中创建的进程/线程创建一次就不会再创建了

至始至终用的都是最初的那几个

这样的话节省了反复开辟进程/线程的资源

"""

def task(n):

    print(n,os.getpid())  # 查看当前进程号

    time.sleep(2)

    return n**2

def call_back(n):

    print('拿到了异步提交任务的返回结果:',n.result())

"""

提交任务的方式

    同步:提交任务之后 原地等待任务的返回结果 期间不做任何事

    异步:提交任务之后 不等待任务的返回结果(异步的结果怎么拿???) 直接执行下一行代码

"""

# pool.submit(task,1)  # 朝线程池中提交任务   异步提交

# print('主')

"""

异步回调机制:当异步提交的任务有返回结果之后,会自动触发回调函数的执行

"""

if __name__ == '__main__':

    t_list = []

    for i in range(20):

        res = pool.submit(task,i).add_done_callback(call_back)  # 提交任务的时候 绑定一个回调函数 一旦该任务有结果 立刻执行对于的回调函数

        # print(res.result())  # 原地等待任务的返回结果

        t_list.append(res)

    # pool.shutdown()  # 关闭池子 等待池子中所有的任务执行完毕之后 才会往下运行代码

    # for p in t_list:

    #     print('>>>:',p.result())

验证复用池子里的线程或进程
池子中创建的进程或线程创建一次就不会再创建了,至始至终用的都是最初的那几个,这样的话就可以节省反复开辟进程或线程的资源了

不是动态创建动态销毁的(如果是好几百个,可想而知)
import random

import time

import os

from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

from threading import current_thread

def task(i):

    time.sleep(random.random())

    # print(f"{os.getpid()} {i} is over...")

    print(f"{os.getpid()} {current_thread().name} {i} is over...")

    return f"{i}² = {i * i}"

if __name__ == '__main__':  # 进程池的时候一定要放在这里面

    # pool = ProcessPoolExecutor(3)

    pool = ThreadPoolExecutor(3, 'MyThreading')

    future_list = []

    for i in range(5):

        future = pool.submit(task, i)

        future_list.append(future)

    pool.shutdown()  # 关闭池子且等待池子中所有的任务运行完毕

    for future in future_list:

        print(f">>:{future.result()}")  # 依次等每个 future的结果,所以是绝对有序的

    print("主")

# 11000 0 is over...  # 复用了进程号(即没有去开辟新的内存空间)

# 8024 2 is over...

# 10100 1 is over...

# 11000 3 is over...

# 8024 4 is over...

# >>:0² = 0

# >>:1² = 1

# >>:2² = 4

# >>:3² = 9

# >>:4² = 16

# 主

# 使用线程池的打印结果

# 13024 MyThreading_1 1 is over...  # 1.复用了线程

# 13024 MyThreading_1 3 is over...  # 2.复用了线程

# 13024 MyThreading_2 2 is over...

# 13024 MyThreading_0 0 is over...

# 13024 MyThreading_1 4 is over...

# >>:0² = 0

# >>:1² = 1

# >>:2² = 4

# >>:3² = 9

# >>:4² = 16

# 主
异步回调机制
这(
.add_done_callback())其实是.submit() 返回结果对象的方法
异步回调机制:当异步提交的任务有返回结果之后,会自动触发回调函数的执行
import random

import time

import os

from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

from threading import current_thread

def callback(future):

    print(f"我拿到了回调结果:{future.result()}")

def task(i):

    time.sleep(random.random())

    # print(f"{os.getpid()} {i} is over...")

    print(f"{os.getpid()} {current_thread().name} {i} is over...")

    return f"{i}² = {i * i}"

if __name__ == '__main__':  # 进程池的时候一定要放在这里面

    # pool = ProcessPoolExecutor(3)

    pool = ThreadPoolExecutor(3, 'MyThreading')

    future_list = []

    for i in range(5):

        # -----------------------------------------------------

        # .submit().add_done_callback() 自动调用回调函数

        #   会自动将 .submit()的返回结果作为参数传给.add_done_callback() 中传入的函数去调用执行

        #       .add_done_callback() 其实是 .submit()返回对象自身的方法

        # -----------------------------------------------------

        future = pool.submit(task, i).add_done_callback(callback)

        future_list.append(future)

    pool.shutdown()  # 关闭池子且等待池子中所有的任务运行完毕

    print("主")

# 11348 MyThreading_0 0 is over...

# 我拿到了回调结果:0² = 0

# 11348 MyThreading_2 2 is over...

# 我拿到了回调结果:2² = 4

# 11348 MyThreading_0 3 is over...

# 我拿到了回调结果:3² = 9

# 11348 MyThreading_1 1 is over...

# 我拿到了回调结果:1² = 1

# 11348 MyThreading_2 4 is over...

# 我拿到了回调结果:4² = 16

# 主
通过闭包给回调函数添加额外参数
# 省略导模块等

# 线程池/进程池对象.submit() 会返回一个 future对象,该对象有.add_done_callback()方法(是一个对象绑定函数),参数是一个函数名(除了对象自身默认传入,无法为该函数传参)

# 这里利用闭包函数返回内部函数名的特点 直接调用这个闭包函数,达到传参的效果,可为回调函数添加更多的扩展性

def outter(*args, **kwargs):

    def callback(res):

        # 可以拿到 *args, **kwargs 参数做一些事情

        print(res.result())

    return callback

pool_list = []

for i in range(15):

    pool_list.append(pool.submit(task, i).add_done_callback(outter(1, 2, 3, a=1, c=3)))  # 朝线程池中提交任务(异步)
协程
进程:资源单位 线程:执行单位 协程:单线程下实现并发
并发 切换+保存状态 ps:看起来像同时执行的 就可以称之为并发
协程:完全是程序员自己意淫出来的名词 单线程下实现并发
并发的条件? 多道技术 空间上的复用 时间上的复用 切换+保存状态
程序员自己通过代码自己检测程序中的IO 一旦遇到IO自己通过代码切换 给操作系统的感觉是你这个线程没有任何的IO ps:欺骗操作系统 让它误认为你这个程序一直没有IO 从而保证程序在运行态和就绪态来回切换 提升代码的运行效率
切换+保存状态就一定能够提升效率吗??? 当你的任务是iO密集型的情况下 提升效率 如果你的任务是计算密集型的 降低效率
yield 保存上一次的结果
多进程下开多线程 多线程下再开协程
gevent模块实现
下载安装

gevent基本介绍
from gevent import spawn, monkey

monkey.patch_all()  # 一般这个要写在很前面(例如导socket模块之前)

# 两行亦可写成一行 from gevent import monkey;monkey.patch_all()

g1 = spawn(eat, 1, 2, 3, x=4, y=5)

# 创建一个协程对象g1,spawn括号内第一个参数是函数名,如eat,后面是该函数(eat)所需要的参数

g2 = spawn(func2)

g1.join()  # 等待协程g1结束

g2.join()  # 等待协程g2结束

# 上述两步亦可合作一步:joinall([g1,g2])

g1.value  # 拿到func1的返回值
通过gevent实现遇到 IO自动切换状态(单线程下并发)
import time

from gevent import spawn

# gevent 本身识别不了time.sleep() 等不属于该模块内的I/O操作

# 使用下面的操作来支持

from gevent import monkey

monkey.patch_all()  # 监测代码中所有 I/O 行为

def heng(name):

    print(f"{name} 哼")

    time.sleep(2)

    print(f"{name} 哼 ...")

def ha(name):

    print(f"{name} 哈")

    time.sleep(3)

    print(f"{name} 哈 ...")

# start_time = time.time()

# heng('egon')

# ha('jason')

# print(f"主 {time.time() - start_time}")

# # 主 5.005069732666016

start_time = time.time()

s1 = spawn(heng, 'egon')

s2 = spawn(ha, 'jason')

s1.join()

s2.join()

print(f"主 {time.time() - start_time}")

# 主 3.0046989917755127
在计算密集型任务中使用
from gevent import spawn, monkey

monkey.patch_all()

import time

def func1():

    for i in range(10000000):

        i + 1

def func2():

    for i in range(10000000):

        i + 1

start = time.time()

g = spawn(func1)

g2 = spawn(func2)

g.join()

g2.join()

stop = time.time()

print(stop - start)

# 1.1324069499969482

# 与前面普通的串行执行时间 1.2481744289398193 相近

# spawn 可以让操作系统察觉不到这个程序有IO操作
利用gevent在单线程下实现并发
服务端
import socket

from gevent import spawn

from gevent import monkey  # 让 gevent 能够识别python的 IO

monkey.patch_all()

server = socket.socket()

server.bind(('127.0.0.1', 8080))

server.listen(5)

def talk(conn):

    while True:

        try:

            data = conn.recv(1024)

            if len(data) == 0: break

            print(data.decode('utf-8'))

            conn.send(data.upper())

        except ConnectionResetError as e:

            print(e)

            break

    conn.close()

def wait_client_connect():

    while True:

        conn, addr = server.accept()

        spawn(talk, conn)

if __name__ == '__main__':

    g1 = spawn(wait_client_connect)

    g1.join()  # 别忘了加上
客户端
import socket

from threading import Thread, current_thread

def create_client():

    client = socket.socket()

    client.connect(('127.0.0.1', 8080))

    n = 0

    while True:

        data = '%s %s' % (current_thread().name, n)

        client.send(data.encode('utf-8'))

        res = client.recv(1024)

        print(res.decode('utf-8'))

        n += 1

for i in range(400):  # 手动开400个线程连接客户端(测试的是服务端单线程实现并发)

    t = Thread(target=create_client)

    t.start()
最大程度下提高代码的执行效率(实现高并发)

多进程下使用多线程

多线程下使用多协程
**大前提**

IO密集型任务
IO模型
(了解)
阻塞IO模型
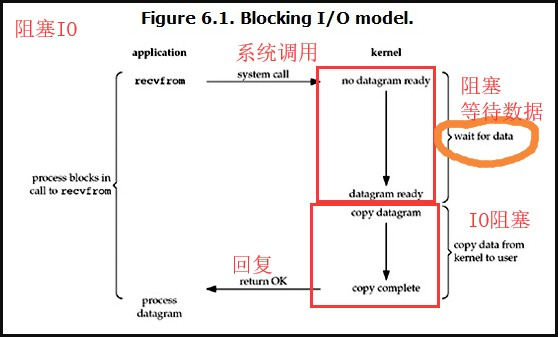
非阻塞IO模型
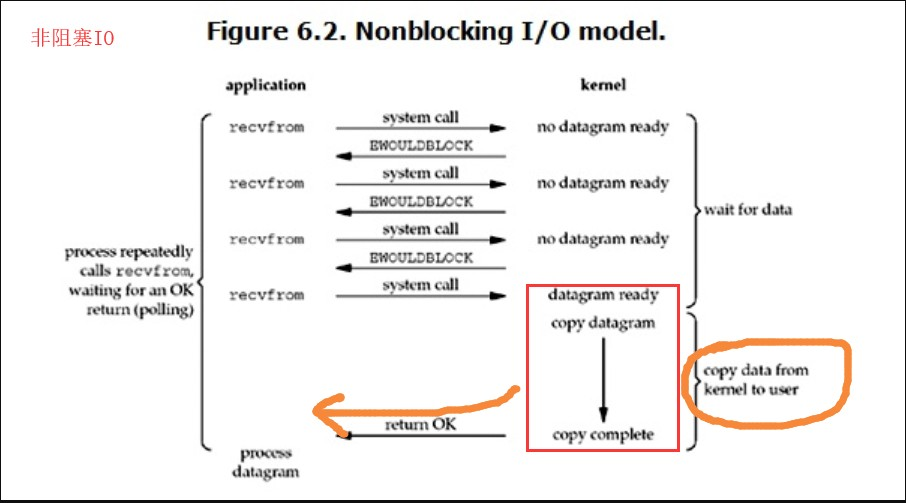
IO多路复用

让select帮你去要数据,你做自己的事,有数据了给你
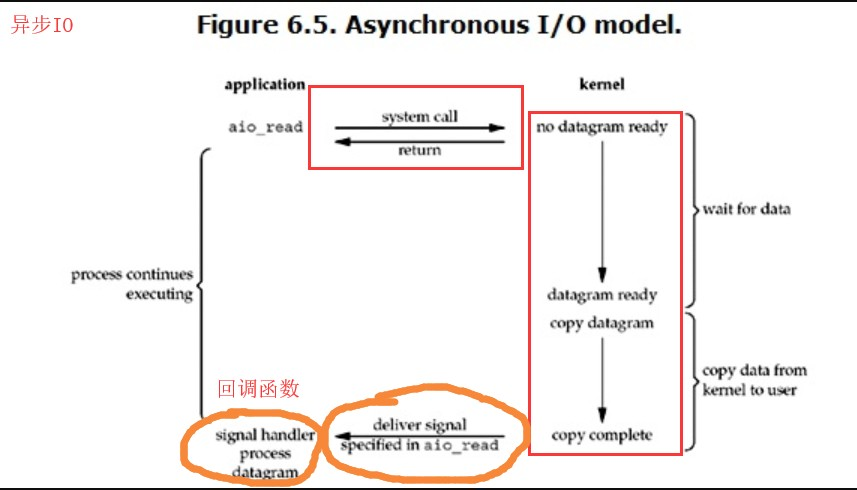
异步IO模型
8.15 day33 进程池与线程池_协程_IO模型(了解)的更多相关文章
- 05网络并发 ( GIL+进程池与线程池+协程+IO模型 )
目录 05 网络并发 05 网络并发
- python之进程池与线程池
一.进程池与线程池介绍 池子使用来限制并发的任务数目,限制我们的计算机在一个自己可承受的范围内去并发地执行任务 当并发的任务数远远超过了计算机的承受能力时,即无法一次性开启过多的进程数或线程数时就应该 ...
- Python中的进程池与线程池(包含代码)
Python中的进程池与线程池 引入进程池与线程池 使用ProcessPoolExecutor进程池,使用ThreadPoolExecutor 使用shutdown 使用submit同步调用 使用su ...
- 4月27日 python学习总结 GIL、进程池、线程池、同步、异步、阻塞、非阻塞
一.GIL:全局解释器锁 1 .GIL:全局解释器锁 GIL本质就是一把互斥锁,是夹在解释器身上的, 同一个进程内的所有线程都需要先抢到GIL锁,才能执行解释器代码 2.GIL的优缺点: 优点: 保 ...
- python系列之 - 并发编程(进程池,线程池,协程)
需要注意一下不能无限的开进程,不能无限的开线程最常用的就是开进程池,开线程池.其中回调函数非常重要回调函数其实可以作为一种编程思想,谁好了谁就去掉 只要你用并发,就会有锁的问题,但是你不能一直去自己加 ...
- 线程池、进程池(concurrent.futures模块)和协程
一.线程池 1.concurrent.futures模块 介绍 concurrent.futures模块提供了高度封装的异步调用接口 ThreadPoolExecutor:线程池,提供异步调用 Pro ...
- 第三十八天 GIL 进程池与线程池
今日内容: 1.GIL 全局解释器锁 2.Cpython解释器并发效率验证 3.线程互斥锁和GIL对比 4.进程池与线程池 一.全局解释器锁 1.GIL:全局解释器锁 GIL本质就是一把互斥锁,是夹在 ...
- python并发编程之进程池,线程池,协程
需要注意一下不能无限的开进程,不能无限的开线程最常用的就是开进程池,开线程池.其中回调函数非常重要回调函数其实可以作为一种编程思想,谁好了谁就去掉 只要你用并发,就会有锁的问题,但是你不能一直去自己加 ...
- 基于concurrent.futures的进程池 和线程池
concurrent.futures:是关于进程池 和 线程池 的 官方文档 https://docs.python.org/dev/library/concurrent.futures.html 现 ...
随机推荐
- ZIP:ZipEntry
ZipEntry: /* 此类用于表示 ZIP 文件条目. */ ZipEntry(String name) :使用指定名称创建新的 ZIP 条目. ZipEntry(ZipEntry e) :使用从 ...
- 消息中间件及IBM MQ
MQ 消息中间件: 中间件是一种独立的系统软件或服务程序,分布式应用软件借助这种软件在不同的技术之间共享资源. 中间件位于客户机/ 服务器的操作系统之上,管理计算机资源和网络通讯.是连接两个独立应用程 ...
- Unity 3d 脚本常用事件
1.学习笔记,每天晚上看看unity 3d 的教程 学点东西,先上一张图 这是 系统中脚本执行的顺序图 Awake()在MonoBehavior创建后就立刻调用,在脚本实例的整个生命周期中,Awake ...
- 从0系统学Android--1.3创建你的第一个 Android 项目
1.3 创建你的第一个 Android 项目 环境搭建完成后,我们就可以写下我们的第一个项目了. 1.3.1 创建 HelloWorld 项目 在 Android Studio 的欢迎页面点击 Sta ...
- 论样式表css的重要性
如下图所示两个网页代码基本相同,但左边网页加入样式表后就形成了右边的视觉效果,由此可见 在网页中html用于标记,css用于显示,而JavaScript则用于增强与用户的交互性. 加入的代码是 < ...
- ASP.NET Core[源码分析篇] - Startup
应用启动的重要类 - Startup 在ASP.NET Core - 从Program和Startup开始这篇文章里面,我们知道了Startup这个类的重要性,它主要负责了: 配置应用需要的服务(服务 ...
- Envoy 源码分析--LDS
Envoy 源码分析--LDS LDS 是 Envoy 用来自动获取 listener 的 API. Envoy 通过 API 可以增加.修改或删除 listener. 先来总结下 listener ...
- jmeter Linux环境执行总报错 cannot allocate memory
1.windows环境写好的测试用例,执行没有问题,在Linux环境跑总是报错,提示如下 cannot allocate memory 2.一开始以为是哪块设置有问题,因为脚本里边有设置邮件自动发送, ...
- 1.Java概述、安装及环境搭建
1. 前言 1.1 学习方法 1. 学会学习的方法 2. 学会独立解决问题 3. 主动的学习而不是被动的接受 4. 知识的大家的,能力才是自己的 1.2 推荐博客 当代程序员都应该养成写博客.看博客的 ...
- 关于JS、JQ首行首列固定展示
当时遇见这个问题 是医院手麻系统大批量数据展示,由于是旧项目系统没有使用到前端的架构 只能使用JQ,JS, css完成 也谢谢给予我支持的同行们 固定首行数据: 采用函数的方式进行 JQ /** * ...