
Python爬虫(requests模块)
Requests是唯一的一个非转基因的Python HTTP库,人类可以安全享用。
Requests基础学习
使用方法:
1.导入Requests模块:
import requests
2.尝试用get获取某个页面,以百度为例子
url = 'http://www.baidu.com'

r = requests.get(url)
r是一个response对象。可以从这个对象中获取所有想要的信息。
发送简单get的请求:
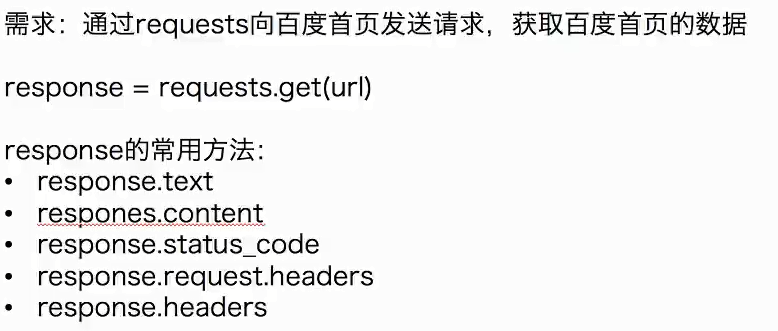
response.text和response.content的区别:
response.text
- 返回类型:str
- 解码类型:根据HTTP头部对响应的编码作出有根据的推测的文本编码
- 如何修改编码方式:response.encoding = 'gbk'
response.content
- 返回类型:bytes
- 解码类型:没有指定
- 如何修改编码方式:response.content.decode('ut8-f')
实例:获取百度图片
import requests

url = 'https://www.baidu.com/img/bd_logo1.png'

response = requests.get(url)

with open('baidu.png','wb') as p:

    p.write(response.content)
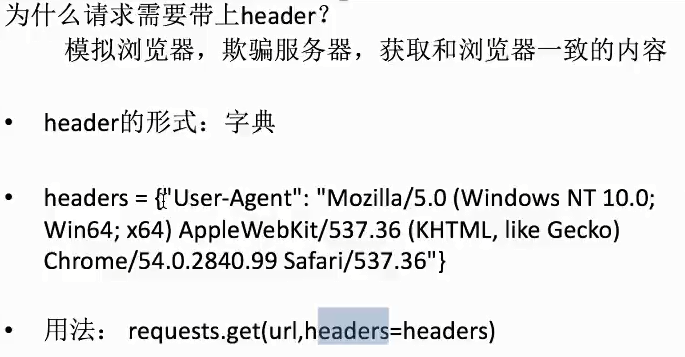
发送带header的get请求:
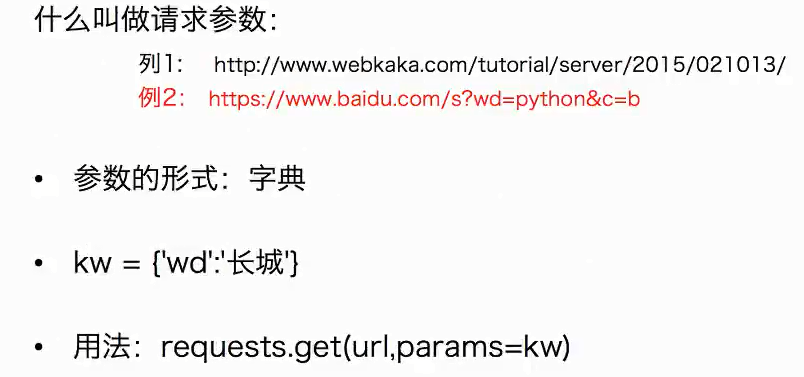
发送带参数的get请求:
实战(贴吧爬虫):
import requests

class TiebaSpider:

    #构造函数,传入想要查询的贴吧名字和查询前num页,定义后面方法需要用的属性

    def __init__(self,tieba_name,tieba_num):

        self.tieba_num = tieba_num

        self.tieba_name = tieba_name

        #下面为url访问的格式,kw为贴吧名,pn为代表页数,贴吧可查首页pn=0,第一页50,第二页100,以此类推

        self.url_temp = "https://tieba.baidu.com/f?kw=" + tieba_name + "&ie=utf-8&pn={}"

        #模仿网页访问贴吧

        self.headers = {"User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 "

                        "(KHTML, like Gecko) Chrome/77.0.3865.120 Safari/537.36"}

    #获取url列表

    def get_urlList(self):

        url_list = []

        for i in range(self.tieba_num):

            url_list.append(self.url_temp.format(i * 50))

        return url_list

    #访问网页,解析网页,返回

    def parse_url(self,url):

        response = requests.get(url,headers=self.headers)

        return response.text #或者response.content.decode('utf-8')

    #保存网页

    def save_html(self,html_str,page_num):

        file_path = "{}-第{}页.html".format(self.tieba_name,page_num)

        with open(file_path,'w',encoding='utf-8') as f:

            f.write(html_str)

    def run(self):

        url_list = self.get_urlList()

        for url in url_list:

            html_str = self.parse_url(url)  #保存的内容

            page_num = url_list.index(url) + 1  #文件的页码

            self.save_html(html_str,page_num)

def main():

    tieba_name = input('请输入想查询的贴吧名:')

    tieba_num = int(input('请输入想要查询前几页:'))

    tieba = TiebaSpider(tieba_name, tieba_num)

    tieba.run()

if __name__ == '__main__':

    main()
Requests深入学习
发送post请求
哪些地方我们会用到POST请求:
- 登录注册(POST比GET更安全)
- 需要传输大文本内容的时候(POST请求对数据长度没有要求)
- 所以同样的,我们的爬虫也需要在这两个地方回去模拟浏览器发送post请求
使用代理
为什么爬虫需要使用代理
- 让服务器以为不是同一个客户端在请求
- 防止我们的真实地址被泄漏,防止被追究
用法:request.get('http://www.baidu.com',proxies = proxies)
proxies的形式:字典
proxies = {
"http" : "http://12.34.56.79:9527",
"https" : "http://12.34.56.79:9527",
}
步骤:
- 准备一堆IP地址,组成ip池,随机选择一个ip来使用
- 随机选择代理ip,让使用次数较少的ip地址有更大的可能性被用到
- {"ip" : ip,"time",0}
- [{},{},{},{},]对这个ip列表进行排序,按照使用次数进行排序
- 选择使用次数较少的10个ip,从中随机选择一个
- 检查ip的可以性
- 可以使用requests添加超时参数,判断ip地址的质量
- 在线代理ip质量检测的网站
爬虫处理cookie和session
带上cookie,session的好处:
能够请求到登录之后的页面
带上cookie,session的弊端:
一套cookie和session往往和一个用户对应,请求太快或者太多,容易被服务器识别为爬虫
不需要cookie的时候尽量不去使用cookie
处理cookies,session请求
requests提供了一个叫session类,来实现客户端和服务端的会话保持
使用方法:
1.实例化一个session对象
2.让session发送get或者post请求
session = requests.session()
cookies = {cookies字典}
response = session.get(url,headers=headers,cookies=cookies)
Python爬虫(requests模块)的更多相关文章
- python 爬虫 requests模块 目录
requests模块(response常用属性) 基于requests模块的get请求 基于requests模块发起ajax的get请求 基于requests模块发起ajax的post请求
- python爬虫requests模块
requests库的七个主要方法 1. requests.requests(method, url, **kwargs) 构造一个请求,支撑以下各方法的基础方法 method:请求方式,对应get/p ...
- python 爬虫 requests模块(response常用属性)
response常用属性 content获取的response对象中的二进制(byte)类型的页面数据response.content 返回响应状态码response.status_code 200 ...
- Python爬虫之使用Fiddler+Postman+Python的requests模块爬取各国国旗
介绍 本篇博客将会介绍一个Python爬虫,用来爬取各个国家的国旗,主要的目标是为了展示如何在Python的requests模块中使用POST方法来爬取网页内容. 为了知道POST方法所需要传 ...
- Python爬虫—requests库get和post方法使用
目录 Python爬虫-requests库get和post方法使用 1. 安装requests库 2.requests.get()方法使用 3.requests.post()方法使用-构造formda ...
- python爬虫 urllib模块url编码处理
案例:爬取使用搜狗根据指定词条搜索到的页面数据(例如爬取词条为‘周杰伦'的页面数据) import urllib.request # 1.指定url url = 'https://www.sogou. ...
- python 爬虫 urllib模块 目录
python 爬虫 urllib模块介绍 python 爬虫 urllib模块 url编码处理 python 爬虫 urllib模块 反爬虫机制UA python 爬虫 urllib模块 发起post ...
- Python之requests模块-hook
requests提供了hook机制,让我们能够在请求得到响应之后去做一些自定义的操作,比如打印某些信息.修改响应内容等.具体用法见下面的例子: import requests # 钩子函数1 def ...
- Python之requests模块-cookie
cookie并不陌生,与session一样,能够让http请求前后保持状态.与session不同之处,在于cookie数据仅保存于客户端.requests也提供了相应到方法去处理cookie. 在py ...
- Python之requests模块-session
http协议本身是无状态的,为了让请求之间保持状态,有了session和cookie机制.requests也提供了相应的方法去操纵它们. requests中的session对象能够让我们跨http请求 ...
随机推荐
- 痞子衡嵌入式:高性能MCU之人工智能物联网应用开发那些事 - 索引
大家好,我是痞子衡,是正经搞技术的痞子.本系列痞子衡给大家介绍的是高性能MCU之人工智能物联网应用开发相关知识. 恩智浦半导体2017年开始推出的i.MX RT系列跨界处理器,这种高性能MCU给嵌入式 ...
- Centos7通过yum跟源码编译安装Nginx
源码编译安装 http://nginx.org/en/download.html 到官网下载,然后用XFTP上传到root目录 把文件解压出来 tar -zxvf nginx-1.16.0.tar.g ...
- VS 2017 代码报错编译正常
今天遇到一个奇葩的错误,代码报红波浪线错误,但编译正常,程序能正常运行; 解决方法 在项目引用中把报错的代码所在项目先移除,再重新引用,然后编译一下就好了
- JavaWeb入门——在Linux环境下安装Tomcat服务器
JavaWeb入门——在Linux环境下安装Tomcat服务器 摘要:本文主要学习了如何在Linux环境下安装Tomcat服务器. 准备工作 检查Java环境变量 检查系统是否配置了Java的环境变量 ...
- Spring Bean Expression Language(EL)
1, Add dependency. <dependency> <groupId>org.springframework</groupId> <artifac ...
- 入职小白随笔之Android四大组件——广播详解(broadcast)
Broadcast 广播机制简介 Android中的广播主要可以分为两种类型:标准广播和有序广播. 标准广播:是一种完全异步执行的广播,在广播发出之后,所有的广播接收器几乎都会在同一时刻接收到这条广播 ...
- SpringBoot项目里,让TKmybatis支持可以手写sql的Mapper.xml文件
SpringBoot项目通常配合TKMybatis或MyBatis-Plus来做数据的持久化. 对于单表的增删改查,TKMybatis优雅简洁,无需像传统mybatis那样在mapper.xml文件里 ...
- json属性里面出现特殊字符怎么获取属性
直接上代码. 这样的 获取这个object后需要获取里面的书属性,但是正常情况下是XX.属性名.但是属性名有特殊符号.这时候我们可以这样. XX['属性名']['属性名']....可以一直这样写 XX ...
- 12c新特性 在线操作数据文件
我们都知道,oracle pre-12c之前,若是想要把一个数据文件改名或者迁移, 必须在归档模式下先把这个数据文件offline之后, 然后进行OS上的copy或者rename 操作, 最后在sql ...
- LeetCode刷题--整数反转(简单)
题目描述 给出一个 32 位的有符号整数,你需要将这个整数中每位上的数字进行反转. 示例 1: 输入: 123 输出: 321 示例 2: 输入: -123 输出: -321 示例 3: 输入: 12 ...