
hadoop yarn日志分离
根据hdfs的auditlog以及fsimage分析,yarn的日志文件占用了10%-20%的rpc请求以及文件量,这对namenode的性能有比较大的影响,特别是当集群规模越来越大,会影响生产业务。故下面的方案对yarn日志进行拆分,将日志写入一个独立的hdfs集群
运行yarn的集群(pascdev),日志写入集群(pasc)
一、 配置
hdfs-site.xml
//添加日志写入集群的nameservice
<property>
<name>dfs.nameservices</name>
<value>pascdev,pasc</value>
</property>
//添加日志写入集群的rpc端口
<property>
<name>dfs.ha.namenodes.pasc</name>
<value>CDM01,CDM02</value>
</property>
<property>
<name>dfs.namenode.rpc-address.pasc.CDM01</name>
<value>CDM01.qa.pab.com.cn:8020</value>
</property>
<property>
<name>dfs.namenode.servicerpc-address.pasc.CDM01</name>
<value>CDM01.qa.pab.com.cn:8021</value>
</property>
<property>
<name>dfs.namenode.rpc-address.pasc.CDM02</name>
<value>CDM02.qa.pab.com.cn:8020</value>
</property>
<property>
<name>dfs.namenode.servicerpc-address.pasc.CDM02</name>
<value>CDM02.qa.pab.com.cn:8021</value>
</property>
//添加日志集群的client.failover.proxy
<property>
<name>dfs.client.failover.proxy.provider.pasc</name>
<value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
</property>
//为防止datanode向日志集群的namenode执行块汇报,添加以下配置
<property>
<name>dfs.internal.nameservices</name>
<value>pascdev</value>
</property>
yarn-site.xml
//修改Yarn日志路径
<property>
<name>yarn.nodemanager.remote-app-log-dir</name>
<value>hdfs://pasc/metadata/logs/remoteyarn</value>
</property>
二、 部署相关Patch
(1)修改以上配置,重启hadoop服务后,报以下错误

原因是现有的版本不支持跨ns的日志聚合操作,部署Patch Yarn-3269
(2)解决跨ns问题后,再次重启服务,报以下错误,提示rpc认证错误
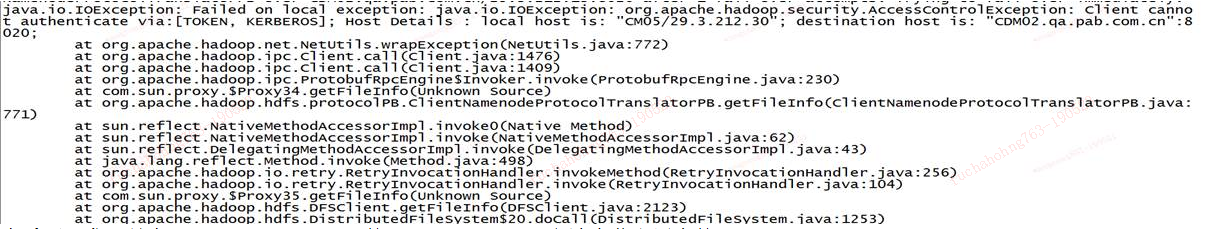
查看源码发现是在logaggragationservice的initappaggregator方法中获取用户的credential
通过打印日志,获取了Nodemananger在进行日志聚合操作时所持有的tokens,发现并没有集群pasc的HDFS_DELEGATION_TOKEN

通过添加代码修改这个问题:
credentials = new Credentials();
FileSystem remoteFs = getFileSystem(getconfig());
remoteFs.addDelegationTokens(UserGroupInformation.getLoginUser().getshortname(),credentials)
可以看到已经获取集群pasc的HDFS_DELEGATION_TOKEN

三、测试
可以看到pasc集群上已经有该app执行的日志

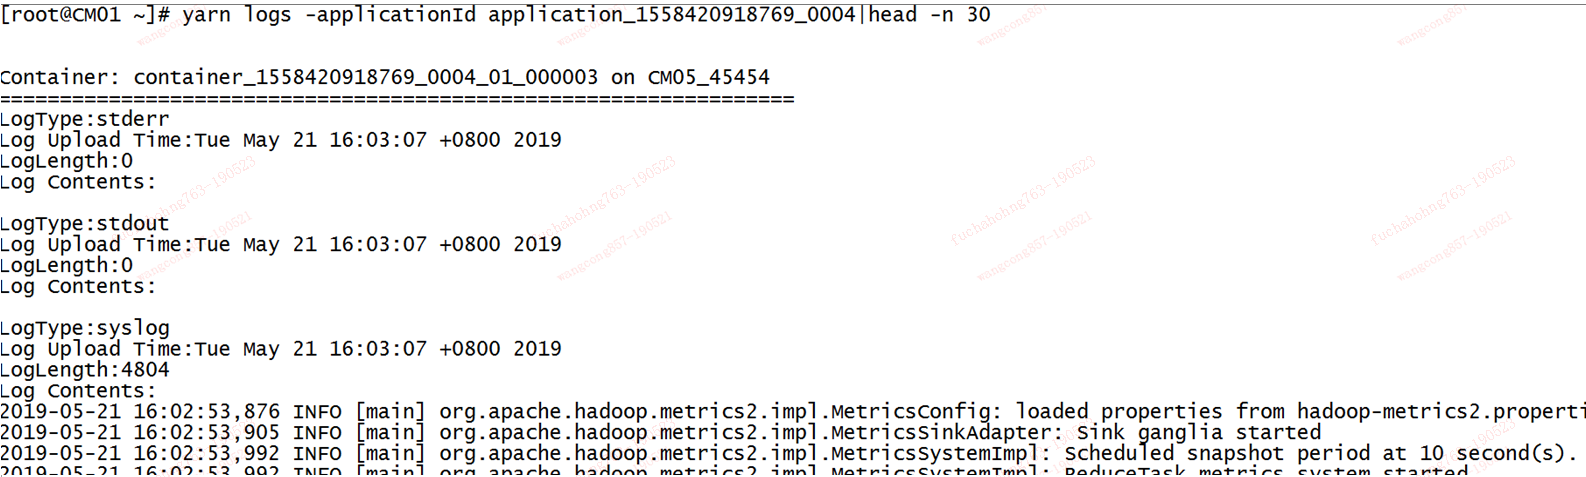
同时可以在pascdev集群上通过yarn logs命令查看日志
hadoop yarn日志分离的更多相关文章
- Hadoop基础-完全分布式模式部署yarn日志聚集功能
Hadoop基础-完全分布式模式部署yarn日志聚集功能 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 其实我们不用配置也可以在服务器后台通过命令行的形式查看相应的日志,但为了更方 ...
- hadoop yarn
简介: 本文介绍了 Hadoop 自 0.23.0 版本后新的 map-reduce 框架(Yarn) 原理,优势,运作机制和配置方法等:着重介绍新的 yarn 框架相对于原框架的差异及改进:并通过 ...
- Hadoop - YARN 概述
一 概述 Apache Hadoop YARN (Yet Another Resource Negotiator,还有一种资源协调者)是一种新的 Hadoop 资源管理器,它是一个通用资源 ...
- Hive分析hadoop进程日志
想把hadoop的进程日志导入hive表进行分析,遂做了以下的尝试. 关于hadoop进程日志的解析 使用正则表达式获取四个字段,一个是日期时间,一个是日志级别,一个是类,最后一个是详细信息, 然后在 ...
- Hadoop YARN配置参数剖析—RM与NM相关参数
注意,配置这些参数前,应充分理解这几个参数的含义,以防止误配给集群带来的隐患.另外,这些参数均需要在yarn-site.xml中配置. 1. ResourceManager相关配置参数 (1) ...
- Hadoop yarn配置参数
参照site:http://hadoop.apache.org/docs/r2.6.0/hadoop-yarn/hadoop-yarn-common/yarn-default.xml 我们在配置yar ...
- Hadoop YARN ERROR 1/1 local-dirs are bad *, 1/1 log-dirs are bad *
转 http://blog.csdn.net/u012303571/article/details/46913471 查看 nodemanager 日志发下 如下信息 2015-07-16 1 ...
- Hadoop Yarn 安装
环境:Linux, 8G 内存.60G 硬盘 , Hadoop 2.2.0 为了构建基于Yarn体系的Spark集群.先要安装Hadoop集群,为了以后查阅方便记录了我本次安装的详细步骤. 事前准备 ...
- [BigData - Hadoop - YARN] YARN:下一代 Hadoop 计算平台
Apache Hadoop 是最流行的大数据处理工具之一.它多年来被许多公司成功部署在生产中.尽管 Hadoop 被视为可靠的.可扩展的.富有成本效益的解决方案,但大型开发人员社区仍在不断改进它.最终 ...
随机推荐
- 创建json对象
jQuery创建json对象 方法二: <!DOCTYPE html> <html> <head> <meta charset="utf-8&quo ...
- Excel中把图片合并进图表的方法介绍
方法一: 使用“图案”对话框 双击某个数据系列,选择“图案”标签,单击“填充效果”按钮,在“填充效果”对话框中选择“图片”标签,单击“选择图片”按钮,选择一个要使用的图形文件即可. 方法二: 使用剪贴 ...
- Docker镜像构建文件Dockerfile及相关命令介绍
使用docker build命令或使用Docker Hub的自动构建功能构建Docker镜像时,都需要一个Dockerfile文件.Dockerfile文件是一个由一系列构建指令组成的文本文件,doc ...
- vue +echarts树状图
<template> <div :class="className" :id="id" :style="{height:height ...
- MySQL数据库笔记四:MySQL的约束
<1>概念 是一种限制,它是对表的行和列的数据做出约束,确保表中的数据的完整性和唯一性. <2>使用场景 创建表的时候,添加约束 <3>分类 1. default: ...
- 4、nfs(存储服务器)
1.NFS基本概述 NFS是Network File System的缩写及网络文件系统.NFS的主要功能是通过局域网络让不同的主机系统之间可以共享文件或目录. 通常中小企业首选NFS作为集群架构的存储 ...
- 轻松阅读linux内核源码
神器:基于linux4.4版本,含函数和功能注释树 http://www.bricktou.com/ https://lwn.net/ 从0开始写linux,这个无敌牛逼,简单阅读了Introduct ...
- PXE+Kickstart实现批量化无人值守安装
centos7下进行kickstart配置 配置kickstart时需要pxe芯片,为获取ip地址 1.先安装dhcpd服务器 yum install -y dhcpd 1-1.配置dhcp的配置文件 ...
- manjaro开机出现grub 解决办法
# 第一步:输入ls出现(hd0,msods1),(hd0,msdos5),(hd0,msods7)# 不同的电脑不一样,这是我电脑中的磁盘分区,和系统中的表示方法不一样,# linux中一般是/de ...
- 第11章 Spring Boot使用Actuator
在生产环境中,需要实时或定期监控服务的可用性,spring-Boot的Actuator 功能提供了很多监控所需的接口. Actuator是Spring Boot提供的对应用系统的自省和监控的集成功能, ...