
Hadoop 部署之环境准备(一)
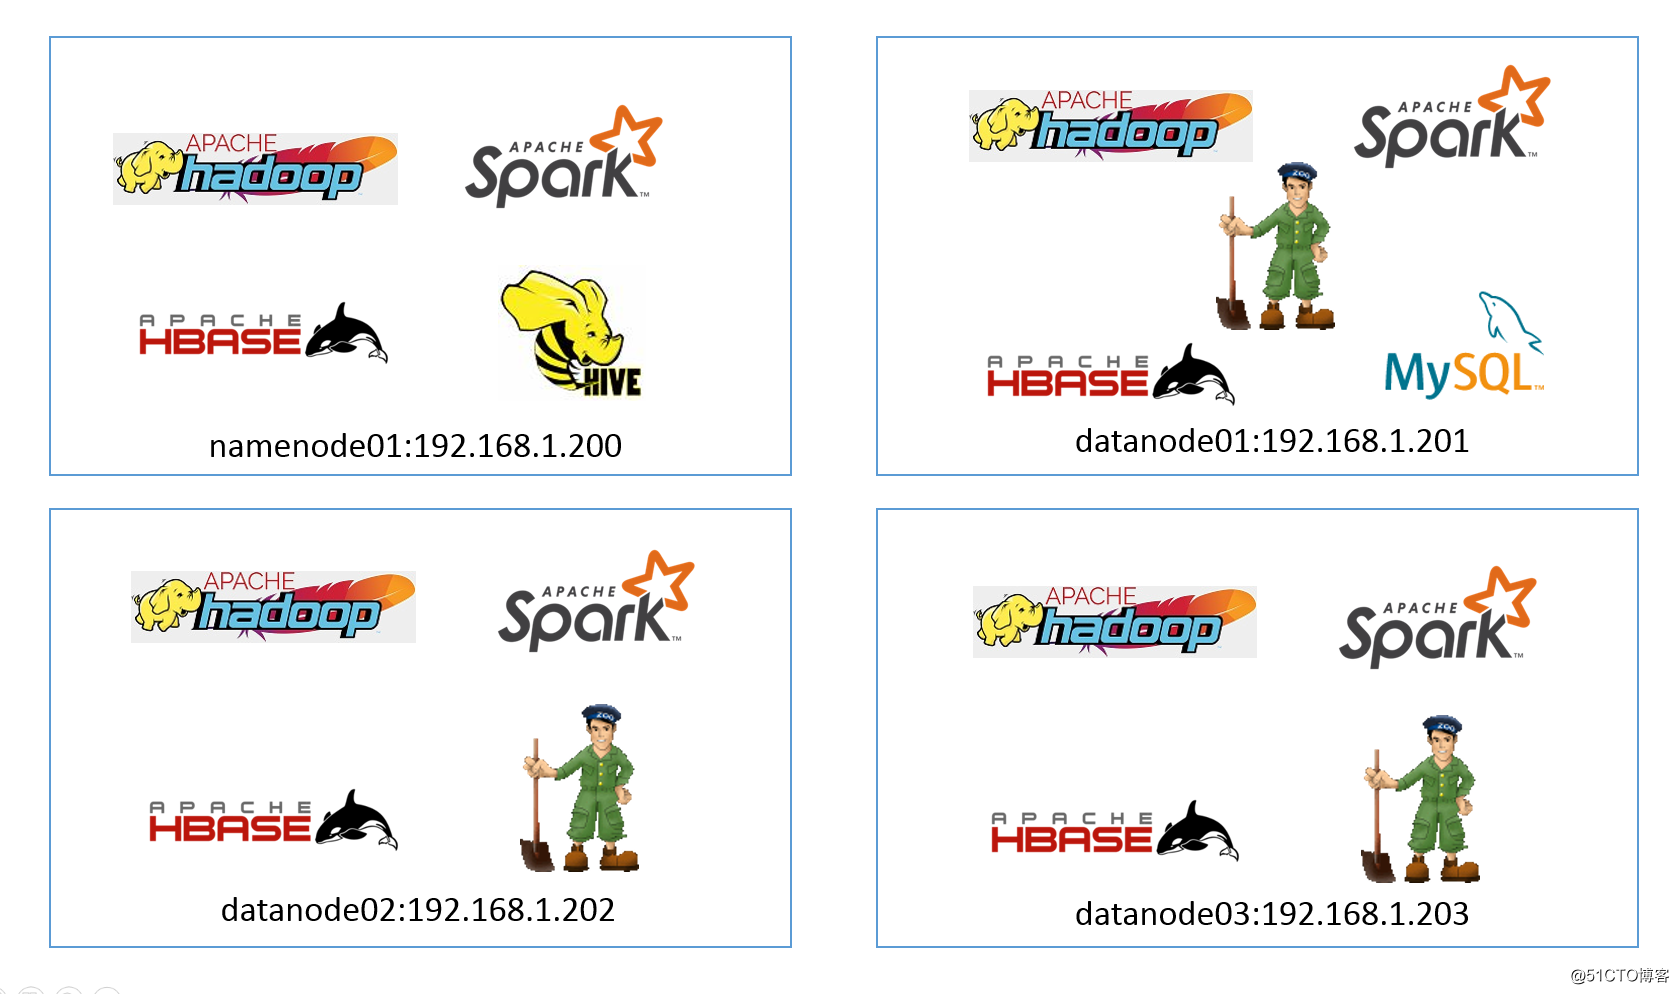
一、软硬件规划
| ID | 主机类型 | 主机名 | IP | 应用软件 | 操作系统 | 硬件配置 |
|---|---|---|---|---|---|---|
| 1 | 物理机 | namenode01 | 192.168.1.200 | jdk1.8.0_171、hadoop-2.7.3、hive-2.3.3、hbase-1.2.6、zookeeper-3.4.10、spark-2.3.1 | CentOS7.4 | 6核CPU、8G内存、250存储 |
| 2 | 物理机 | datanode01 | 192.168.1.201 | jdk1.8.0_171、hadoop-2.7.3、hive-2.3.3、hbase-1.2.6、zookeeper-3.4.10、spark-2.3.1 | CentOS7.4 | 6核CPU、8G内存、250存储 |
| 3 | 物理机 | datanode02 | 192.168.1.202 | jdk1.8.0_171、hadoop-2.7.3、hive-2.3.3、hbase-1.2.6、zookeeper-3.4.10、spark-2.3.1 | CentOS7.4 | 6核CPU、8G内存、250存储 |
| 4 | 物理机 | datanode03 | 192.168.1.203 | jdk1.8.0_171、hadoop-2.7.3、hive-2.3.3、hbase-1.2.6、zookeeper-3.4.10、spark-2.3.1 | CentOS7.4 | 6核CPU、8G内存、250存储 |
我这里规划的角色不是太好,如果是四台机器,建议大家按照我们下面的分配
- ZooKeeper
ZooKeeper Server:namenode01 - HDFS
NameNode:namenode01
SecondaryNameNode:namenode01
DataNode:datanode[01-03] - YARN
ResourceManager:namenode01
NodeManager:datanode[01-03] - HBase
Master:namenode01
RegionServer:datanode[01-03] - Hive
HiveServer2:namenode01
Hive Metastore Server:namenode01 - Spark
Master:namenode01
Worker:datanode[01-03]
二、主机名解析
修改四台服务器的主机名。
192.168.1.200 namenode01 hbase01 spark01 hive01 cluster1

192.168.1.201 datanode01 hbase02 spark02 zk01 mysql01

192.168.1.202 datanode02 hbase03 spark03 zk02

192.168.1.203 datanode03 hbase04 spark04 zk03
三、配置 SSH 互信
在namenode01节点上面进行操作。
ssh-keygen -t rsa

ssh-copy-id namenode01

ssh-copy-id datanode01

ssh-copy-id datanode02

ssh-copy-id datanode03
四、创建用户
创建用户(4台机器相同操作)
useradd hadoop && echo '123456' |passwd --stdin hadoop
使用命令visudo设置用户权限(4台机器相同操作),添加如下内容:
hadoop ALL=(ALL) ALL
五、JDK 的安装
下载JDK1.8,可以选择下载rpm包,直接安装即可使用。
https://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html
Hadoop 部署之环境准备(一)的更多相关文章
- hadoop集群环境搭建之zookeeper集群的安装部署
关于hadoop集群搭建有一些准备工作要做,具体请参照hadoop集群环境搭建准备工作 (我成功的按照这个步骤部署成功了,经实际验证,该方法可行) 一.安装zookeeper 1 将zookeeper ...
- Hadoop生态圈-HUE环境部署
Hadoop生态圈-HUE环境部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HUE简介 1>.HUE的由来 HUE全称是HadoopUser Experienc ...
- hadoop进阶----hadoop经验(一)-----生产环境hadoop部署在超大内存服务器的虚拟机集群上vs几个内存较小的物理机
生产环境 hadoop部署在超大内存服务器的虚拟机集群上 好 还是 几个内存较小的物理机上好? 虚拟机集群优点 虚拟化会带来一些其他方面的功能. 资源隔离.有些集群是专用的,比如给你三台设备只跑一个 ...
- 批量部署Hadoop集群环境(1)
批量部署Hadoop集群环境(1) 1. 项目简介: 前言:云火的一塌糊涂,加上自大二就跟随一位教授做大数据项目,所以很早就产生了兴趣,随着知识的积累,虚拟机已经不能满足了,这次在服务器上以生产环境来 ...
- hadoop集群环境搭建之安装配置hadoop集群
在安装hadoop集群之前,需要先进行zookeeper的安装,请参照hadoop集群环境搭建之zookeeper集群的安装部署 1 将hadoop安装包解压到 /itcast/ (如果没有这个目录 ...
- hadoop集群环境搭建准备工作
一定要注意hadoop和linux系统的位数一定要相同,就是说如果hadoop是32位的,linux系统也一定要安装32位的. 准备工作: 1 首先在VMware中建立6台虚拟机(配置默认即可).这是 ...
- hadoop集群环境的搭建
hadoop集群环境的搭建 今天终于把hadoop集群环境给搭建起来了,能够运行单词统计的示例程序了. 集群信息如下: 主机名 Hadoop角色 Hadoop jps命令结果 Hadoop用户 Had ...
- 基于Centos搭建 Hadoop 伪分布式环境
软硬件环境: CentOS 7.2 64 位, OpenJDK- 1.8,Hadoop- 2.7 关于本教程的说明 云实验室云主机自动使用 root 账户登录系统,因此本教程中所有的操作都是以 roo ...
- Hadoop 部署文档
Hadoop 部署文档 1 先决条件 2 下载二进制文件 3 修改配置文件 3.1 core-site.xml 3.2 hdfs-site.xml 3.3 mapred-site.xml 3.4 ya ...
随机推荐
- evpp http put问题
https://blog.csdn.net/yuzuyi2006/article/details/82112664 最近做了一个项目需要实现web服务,使用了evpp.但是在用的过程中碰到了http ...
- python 打印 str 字符串的实际内容 repr(str)
python 打印 str 字符串的实际内容 repr(str) s = 'aa' print(repr(s))
- Linux下恢复误删除的文件
原文地址:http://www.libenfu.com/vim-分区下误删的文件,恢复文件全记录-转 当时我的工作目录是/source/needrecovered. $ pwd /source/nee ...
- c语言1博客作业09
一.本周作业头 这个作业属于那个课程 C语言程序设计II 这个作业要求在哪里 https://edu.cnblogs.com/campus/zswxy/SE2019-3/homework/10033 ...
- Spring框架集成FreeMarker
一.Spring in Action (转自:http://blog.163.com/zhang-_-jie/blog/static/16178437820105821120822/ ) FreeMa ...
- [2019牛客多校第三场][G. Removing Stones]
题目链接:https://ac.nowcoder.com/acm/contest/883/G 题目大意:有\(n\)堆石头,每堆有\(a_i\)个,每次可以选其中两堆非零的石堆,各取走一个石子,当所有 ...
- 解压 .tar.xz 格式的压缩文件
第一种方法: xz -d mysql-8.0.16-linux-glibc2.12-x86_64.tar.xz tar -xvf mysql-8.0.16-linux-glibc2.12-x86_64 ...
- 用pyinstaller打包python程序、打包pyqt程序
将.py脚本拷贝到一个文件夹中: 然后shift+右键,打开Powershell窗口: -F:设置打包为一个.exe文件.(缺点打开速度慢,不加-F则不打包为一个.exe,优点简洁方便) -w:设置不 ...
- P1169 [ZJOI2007]棋盘制作 悬线法or单调栈
思路:悬线法\(or\)单调栈 提交:2次 错因:正方形面积取错了\(QwQ\) 题解: 悬线法 讲解:王知昆\(dalao\)的\(PPT\) 详见代码: #include<cstdio> ...
- deferred.pipe([doneFilter],[failFilter],[progressFilter])
deferred.pipe([doneFilter],[failFilter],[progressFilter]) 概述 筛选器和/或链Deferreds的实用程序方法. deferred.pipe( ...