
SpringBoot轻松整合ElasticSearch
完整项目代码地址(https://github.com/fonxian/spring-elasticsearch-example/tree/master/spring-elasticsearch-example)
一、整合过程
引入依赖
	<parent>

        <groupId>org.springframework.boot</groupId>

        <artifactId>spring-boot-starter-parent</artifactId>

        <version>2.0.1.RELEASE</version>

        <relativePath/> <!-- lookup parent from repository -->

    </parent>

    <dependencies>

        <dependency>

            <groupId>org.springframework.data</groupId>

            <artifactId>spring-data-elasticsearch</artifactId>

        </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-web</artifactId>

        </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-test</artifactId>

            <scope>test</scope>

        </dependency>

    </dependencies>
添加配置
server.port=8085

spring.data.elasticsearch.cluster-nodes = bei1:9300

elasticsearch.cluster.name=coffe-elasticsearch
创建实体类和数据访问类
实体类
@Document(indexName = "book",type = "book")

public class Book {

    @Id

    private String id;

    private String name;

    private Long price;

    @Version

    private Long version;

    public Map<Integer, Collection<String>> getBuckets() {

        return buckets;

    }

    public void setBuckets(Map<Integer, Collection<String>> buckets) {

        this.buckets = buckets;

    }

    @Field(type = FieldType.Nested)

    private Map<Integer, Collection<String>> buckets = new HashMap();

    public Book(){}

    public Book(String id, String name,Long version) {

        this.id = id;

        this.name = name;

        this.version = version;

    }

    public String getId() {

        return id;

    }

    public void setId(String id) {

        this.id = id;

    }

    public String getName() {

        return name;

    }

    public void setName(String name) {

        this.name = name;

    }

    public Long getPrice() {

        return price;

    }

    public void setPrice(Long price) {

        this.price = price;

    }

    public long getVersion() {

        return version;

    }

    public void setVersion(long version) {

        this.version = version;

    }

}
数据访问类
@Component

public interface BookRepository extends ElasticsearchRepository<Book,String> {

    Page<Book> findByNameAndPrice(String name, Long price, Pageable pageable);

    Page<Book> findByNameOrPrice(String name, Long price, Pageable pageable);

    Page<Book> findByName(String name, Pageable pageable);

}
二、单元测试、测试整合结果
使用单元测试测试使用结果
创建测试类
@SpringBootTest

@RunWith(SpringRunner.class)

public class BookRepositoryTest {

    @Autowired

    private BookRepository repository;

    @Autowired

    private ElasticsearchTemplate esTemplate;

}
(1)添加文档
    /**

     * 插入文档

     */

    @Test

    public void indexBook() {

        Book book = new Book();

        book.setId("123456");

        book.setName("瓦尔登湖");

        book.setPrice(20L);

        book.setVersion(1L);

        repository.save(book);

        Book book2 = new Book();

        book2.setId("234567");

        book2.setName("Java编程思想");

        book2.setPrice(88L);

        book2.setVersion(1L);

        repository.save(book2);

        Book book3 = new Book();

        book3.setId("8910");

        book3.setName("程序员的自我修养");

        book3.setPrice(56L);

        book3.setVersion(1L);

        repository.save(book3);

    }
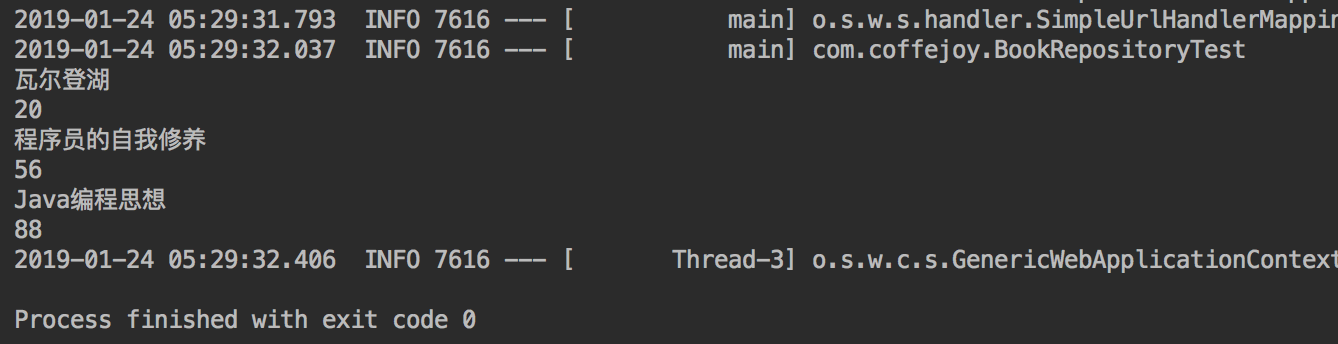
(2)查询所有文档
    /**

     * 获取所有文档

     */

    @Test

    public void getAll() {

        repository.findAll().forEach(book -> {

            System.out.println(book.getName());

            System.out.println(book.getPrice());

        });

    }
(3)使用查询条件
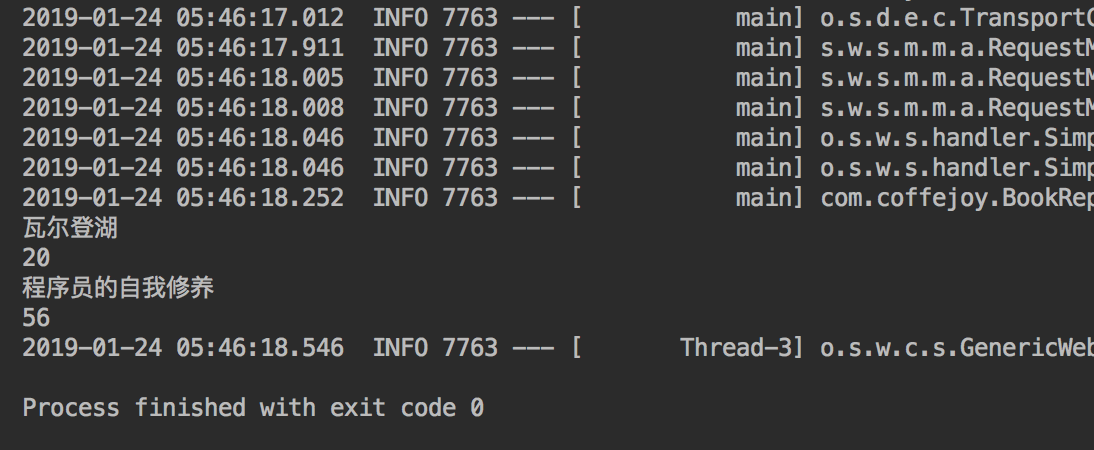
	/**

     * 使用查询条件

     */

    @Test

    public void queryByNameOrPrice() {

        Page<Book> books = repository.findByNameOrPrice("瓦尔登湖", 56L, Pageable.unpaged());

        books.forEach(book -> {

            System.out.println(book.getName());

            System.out.println(book.getPrice());

        });

    }
(4)使用原生方式查询
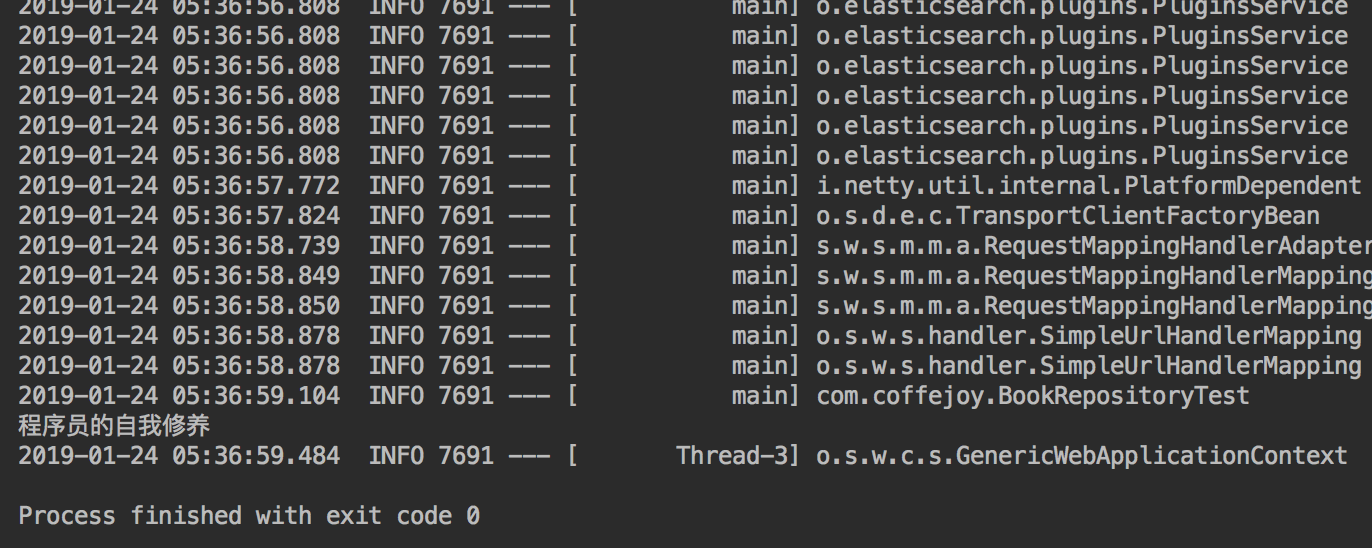
    /**

     * 原生方式查询字段

     */

    @Test

    public void queryByName() {

        QueryBuilder queryBuilder = new QueryStringQueryBuilder("修养").field("name");

        SearchQuery searchQuery = new NativeSearchQueryBuilder()

                .withQuery(queryBuilder)

                .build();

        Page<Book> bookPage = esTemplate.queryForPage(searchQuery, Book.class);

        bookPage.getContent().forEach(book -> {

            System.out.println(book.getName());

        });

    }
参考文档
SpringBoot轻松整合ElasticSearch的更多相关文章
- SpringBoot进阶教程(七十三)整合elasticsearch
Elasticsearch 是一个分布式.高扩展.高实时的搜索与数据分析引擎.它能很方便的使大量数据具有搜索.分析和探索的能力.充分利用Elasticsearch的水平伸缩性,能使数据在生产环境变得更 ...
- SpringBoot整合ElasticSearch实现多版本的兼容
前言 在上一篇学习SpringBoot中,整合了Mybatis.Druid和PageHelper并实现了多数据源的操作.本篇主要是介绍和使用目前最火的搜索引擎ElastiSearch,并和Spring ...
- ElasticSearch(2)---SpringBoot整合ElasticSearch
SpringBoot整合ElasticSearch 一.基于spring-boot-starter-data-elasticsearch整合 开发环境:springboot版本:2.0.1,elast ...
- SpringBoot整合elasticsearch
在这一篇文章开始之前,你需要先安装一个ElasticSearch,如果你是mac或者linux可以参考https://www.jianshu.com/p/e47b451375ea,如果是windows ...
- java框架之SpringBoot(13)-检索及整合Elasticsearch
ElasticSearch介绍 简介 我们的应用经常需要使用检索功能,开源的 Elasticsearch 是目前全文搜索引擎的首选.它可以快速的存储.搜索和分析海量数据.SpringBoot 通过整合 ...
- SpringBoot 2.x 整合ElasticSearch的demo
SpringBoot 2.x 整合ElasticSearch的demo 1.配置文件application.yml信息 # Tomcat server: tomcat: uri-encoding: U ...
- springboot整合elasticsearch入门例子
springboot整合elasticsearch入门例子 https://blog.csdn.net/tianyaleixiaowu/article/details/72833940 Elastic ...
- SpringBoot 2.x (12):整合Elasticsearch
Elasticsearch:一个优秀的搜索引擎框架 搜索方面最基本的是SQL的like语句 进一步的有Lucene框架 后来有企业级的Solr框架 而Elasticsearch框架尤其适合于数据量特别 ...
- Springboot整合elasticsearch以及接口开发
Springboot整合elasticsearch以及接口开发 搭建elasticsearch集群 搭建过程略(我这里用的是elasticsearch5.5.2版本) 写入测试数据 新建索引book( ...
随机推荐
- jenkins+ant+jmeter测试环境部署
1.安装java 2.安装jenkins 3.下载apache-jmeter-4.0,解压后放在 /home/用户名/ 下 4.下载apache-ant-1.10.3,解压后放在 /home/用户名/ ...
- 【STM32H7教程】第11章 STM32H7移植SEGGER的硬件异常分析
完整教程下载地址:http://forum.armfly.com/forum.php?mod=viewthread&tid=86980 第11章 STM32H7移植SEGGER的硬 ...
- Mybatis:缓存,动态SQL,注解SQL以及动态标签使用
1 转义字符 字符 转义 描述 < < 小于 <= <= 小于等于 > > 大于 >= >= 大于等于 <> <> 不等于 &a ...
- API做翻页的两种思路
在开发API的时候,有时候数据太多了,就需要分页读取. 基于偏移量的分页(Offset-based) 这种方式就是会提供一个每页笔数(page size)来定义返回条目的最大数,提供一个页数(page ...
- Python-爬取校花网视频(单线程和多线程版本)
一.参考文章 python爬虫爬取校花网视频,单线程爬取 爬虫----爬取校花网视频,包含多线程版本 上述两篇文章都是对校花网视频的爬取,由于时间相隔很久了,校花网上的一些视频已经不存在了,因此上述文 ...
- HTTP/2 简介
支撑现有 Web 服务的 HTTP 协议距离其发布时的 1997 年已经有些年月了,随后的 HTTP/1.1 版本发布自 1999 年.随着技术的进步和需求的进化,对于数据快速高效地传输,HTTP/1 ...
- laravel中如何利用反射实现依赖注入
依赖注入 在一个类中经常会依赖于其他的对象,先看一下经典的写法 class Foo { public $bar; public function __construct() { $this->b ...
- Android studio无法创建类和接口问题解决办法。提示 Unable to parse template "Class"
重新配置了studio 的工作环境, 没问题,后来加需求要新增java类和接口,这就出现问题了,新建的时候,就会报错: Unable to parse template "Interface ...
- 2017-10-31 中文代码示例教程之Vuejs入门&后续计划
"中文编程"知乎专栏原链 为了检验中文命名在主流框架中的支持程度, 这里把vuejs官方入门教程第一部分的示例代码中尽量使用了中文命名. 过程中有一些发现, 初步看来Vuejs对中 ...
- pyspider 文档介绍
一 代码区结构 def on_start(self)是脚本的入口点.单击run仪表板上的按钮时将调用它. self.crawl(url, callback=self.index_page)*是这里最重 ...