
(转发)storm 入门原理介绍
1.hadoop有master与slave,Storm与之对应的节点是什么?
2.Storm控制节点上面运行一个后台程序被称之为什么?
3.Supervisor的作用是什么?
4.Topology与Worker之间的关系是什么?
5.Nimbus和Supervisor之间的所有协调工作有master来完成,还是Zookeeper集群完成?
6.storm稳定的原因是什么?
7.如何运行Topology?
strom jar all-your-code.jar backtype.storm.MyTopology arg1 arg2
8.spout是什么?
9.bolt是什么?
10.Topology由两部分组成?
11.stream grouping有几种?
Storm对于实时计算的的意义相当于Hadoop对于批处理的意义。Hadoop为我们提供了Map和Reduce原语,使我们对数据进行批处理变的非常的简单和优美。同样,Storm也对数据的实时计算提供了简单Spout和Bolt原语。
Storm适用的场景:
1、流数据处理:Storm可以用来用来处理源源不断的消息,并将处理之后的结果保存到持久化介质中。
2、分布式RPC:由于Storm的处理组件都是分布式的,而且处理延迟都极低,所以可以Storm可以做为一个通用的分布式RPC框架来使用。
1、准备工作
2、一个Storm集群的基本组件
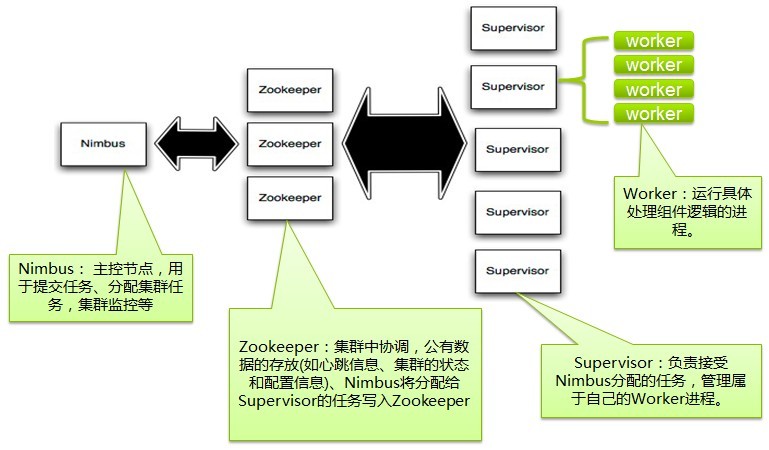
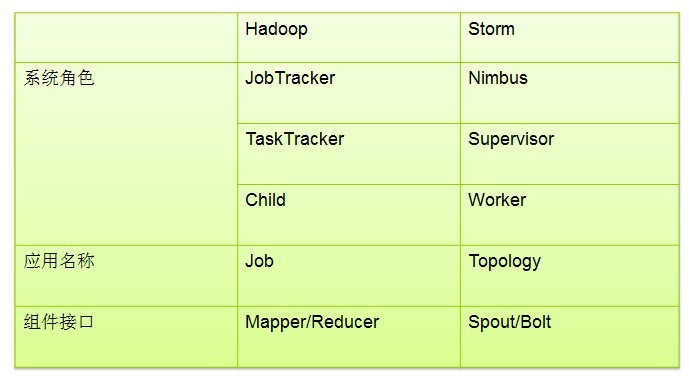
3、Topologies
- strom jar all-your-code.jar backtype.storm.MyTopology arg1 arg2
复制代码
-based语言提交的最简单的方法, 看一下文章: 在生产集群上运行topology去看看怎么启动以及停止topologies。
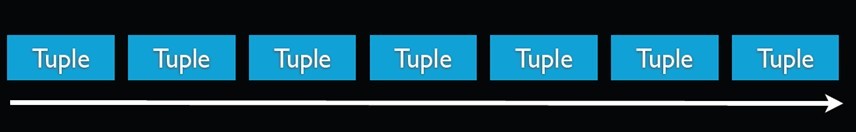
4、Stream
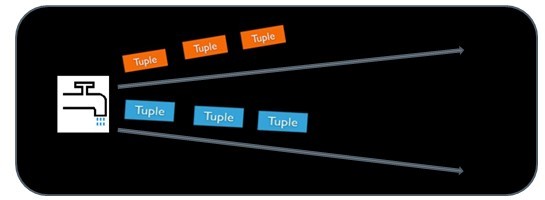
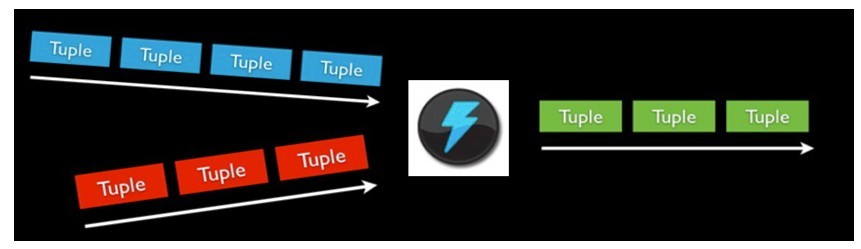
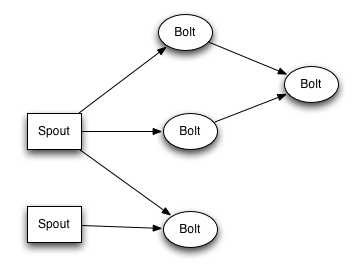
5、数据模型(Data Model)

|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
|
publicclassDoubleAndTripleBoltimplementsIRichBolt { privateOutputCollectorBase _collector; @Override publicvoidprepare(Map conf, TopologyContext context, OutputCollectorBase collector) { _collector = collector; } @Override publicvoidexecute(Tuple input) { intval = input.getInteger(0); _collector.emit(input,newValues(val*2, val*3)); _collector.ack(input); } @Override publicvoidcleanup() { } @Override publicvoiddeclareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(newFields("double","triple")); }} |
|
1
2
3
4
5
6
|
TopologyBuilder builder =newTopologyBuilder();builder.setSpout(1,newTestWordSpout(),10);builder.setBolt(2,newExclamationBolt(),3) .shuffleGrouping(1);builder.setBolt(3,newExclamationBolt(),2) .shuffleGrouping(2); |
|
1
2
3
|
builder.setBolt(3,newExclamationBolt(),5) .shuffleGrouping(1) .shuffleGrouping(2); |
让我们深入地看一下这个topology里面的spout和bolt是怎么实现的。Spout负责发射新的tuple到这个topology里面来。 TestWordSpout从["nathan", "mike", "jackson", "golda", "bertels"]里面随机选择一个单词发射出来。TestWordSpout里面的nextTuple()方法是这样定义的:
|
1
2
3
4
5
6
7
8
|
publicvoidnextTuple() { Utils.sleep(100); finalString[] words =newString[] {"nathan","mike", "jackson","golda","bertels"}; finalRandom rand =newRandom(); finalString word = words[rand.nextInt(words.length)]; _collector.emit(newValues(word));} |
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
publicstaticclassExclamationBoltimplementsIRichBolt { OutputCollector _collector; publicvoidprepare(Map conf, TopologyContext context, OutputCollector collector) { _collector = collector; } publicvoidexecute(Tuple tuple) { _collector.emit(tuple,newValues(tuple.getString(0) +"!!!")); _collector.ack(tuple); } publicvoidcleanup() { } publicvoiddeclareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(newFields("word")); }} |
让我们看看怎么以local mode运行ExclamationToplogy。
|
1
2
3
4
5
6
7
8
9
|
Config conf =newConfig();conf.setDebug(true);conf.setNumWorkers(2);LocalCluster cluster =newLocalCluster();cluster.submitTopology("test", conf, builder.createTopology());Utils.sleep(10000);cluster.killTopology("test");cluster.shutdown(); |
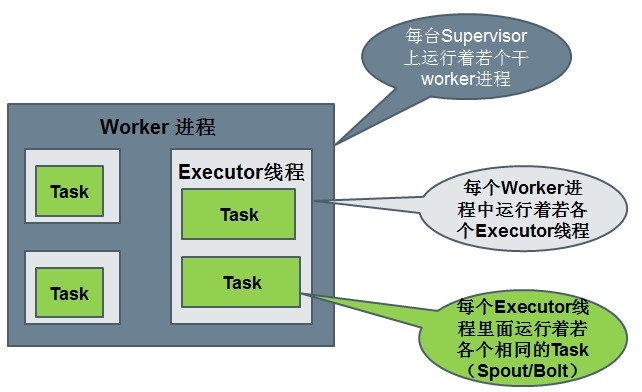
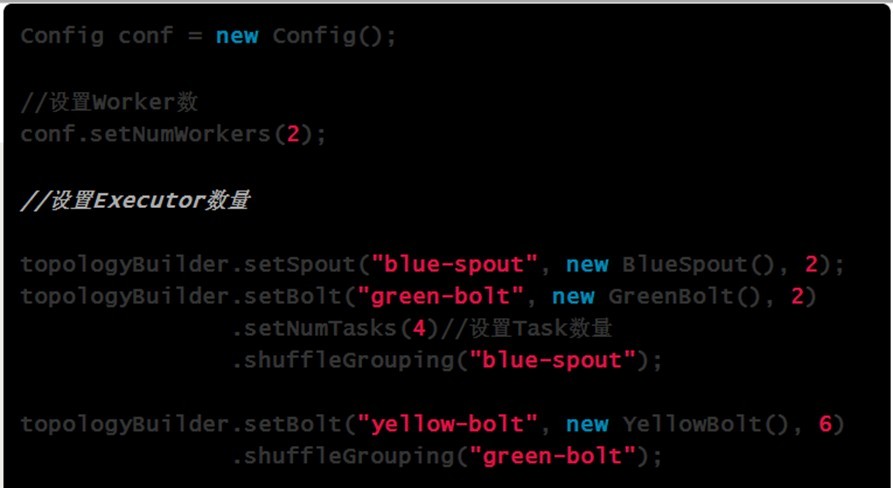
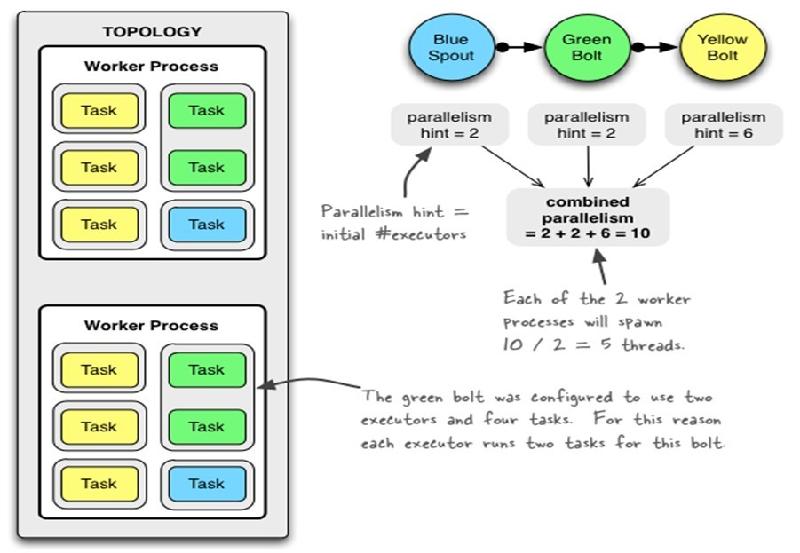
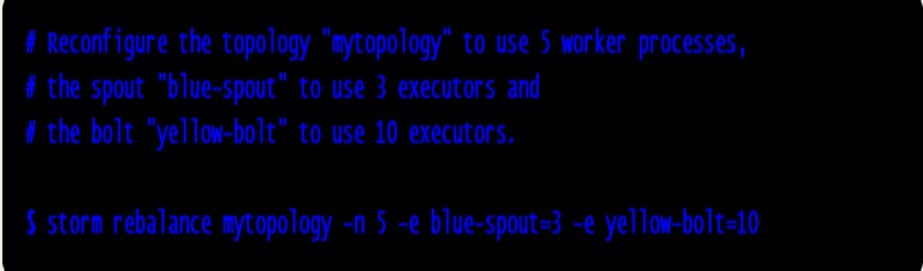
- TOPOLOGY_WORKERS(setNumWorkers) 定义你希望集群分配多少个工作进程给你来执行这个topology. topology里面的每个组件会被需要线程来执行。每个组件到底用多少个线程是通过setBolt和setSpout来指定的。这些线程都运行在工作进 程里面. 每一个工作进程包含一些节点的一些工作线程。比如, 如果你指定300个线程,60个进程, 那么每个工作进程里面要执行6个线程, 而这6个线程可能属于不同的组件(Spout, Bolt)。你可以通过调整每个组件的并行度以及这些线程所在的进程数量来调整topology的性能。
- TOPOLOGY_DEBUG(setDebug), 当它被设置成true的话, storm会记录下每个组件所发射的每条消息。这在本地环境调试topology很有用, 但是在线上这么做的话会影响性能的。
Worker processes(进程)
Executors (threads)(线程)
Tasks
7、流分组策略(Stream grouping)
|
1
2
3
4
5
6
7
|
TopologyBuilder builder =newTopologyBuilder();builder.setSpout(1,newRandomSentenceSpout(),5);builder.setBolt(2,newSplitSentence(),8) .shuffleGrouping(1);builder.setBolt(3,newWordCount(),12) .fieldsGrouping(2,newFields("word")); |
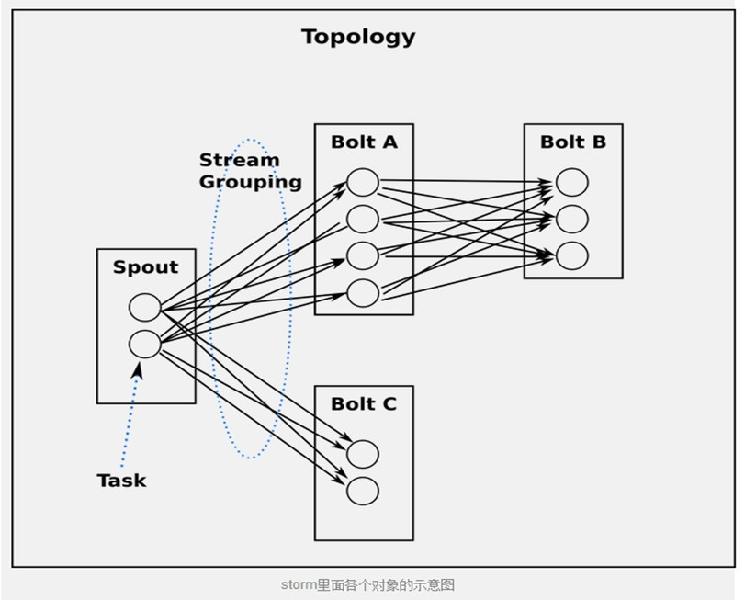
- 最简单的grouping是shuffle grouping, 它随机发给任何一个task。上面例子里面RandomSentenceSpout和SplitSentence之间用的就是shuffle grouping, shuffle grouping对各个task的tuple分配的比较均匀。
- 一种更有趣的grouping是fields grouping, SplitSentence和WordCount之间使用的就是fields grouping, 这种grouping机制保证相同field值的tuple会去同一个task, 这对于WordCount来说非常关键,如果同一个单词不去同一个task, 那么统计出来的单词次数就不对了。
l ShuffleGrouping:随机选择一个Task来发送。
l FiledGrouping:根据Tuple中Fields来做一致性hash,相同hash值的Tuple被发送到相同的Task。
l AllGrouping:广播发送,将每一个Tuple发送到所有的Task。
l GlobalGrouping:所有的Tuple会被发送到某个Bolt中的id最小的那个Task。
l NoneGrouping:不关心Tuple发送给哪个Task来处理,等价于ShuffleGrouping。
l DirectGrouping:直接将Tuple发送到指定的Task来处理。
8、使用别的语言来定义Bolt
|
1
2
3
4
5
6
7
8
9
|
publicstaticclassSplitSentenceextendsShellBoltimplementsIRichBolt { publicSplitSentence() { super("python","splitsentence.py"); } publicvoiddeclareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(newFields("word")); }} |
SplitSentence继承自ShellBolt并且声明这个Bolt用python来运行,并且参数是: splitsentence.py。下面是splitsentence.py的定义:
|
1
2
3
4
5
6
7
8
9
|
importstormclassSplitSentenceBolt(storm.BasicBolt): defprocess(self, tup): words=tup.values[0].split(" ") forwordinwords: storm.emit([word])SplitSentenceBolt().run() |
9、可靠的消息处理
原文地址:http://www.aboutyun.com/thread-7394-1-1.html
(转发)storm 入门原理介绍的更多相关文章
- storm 入门原理介绍
1.hadoop有master与slave,Storm与之对应的节点是什么? 2.Storm控制节点上面运行一个后台程序被称之为什么? 3.Supervisor的作用是什么? 4.Topology与W ...
- storm 入门原理介绍_AboutYUN
转自:http://www.aboutyun.com/thread-7394-1-1.html 了解Storm:http://www.aboutyun.com/thread-9547-1-2.html ...
- storm入门原理介绍
转自:http://www.cnblogs.com/wuxiang/p/5629138.html 1.hadoop有master与slave,Storm与之对应的节点是什么?2.Storm控制节点上面 ...
- storm原理介绍
目录 storm原理介绍 一.原理介绍 二.配置 三.并行度 (一)storm拓扑的并行度可以从以下4个维度进行设置: (二)并行度的设置方法 (三)示例 四.分组 五.可靠性 (一)spout (二 ...
- 《Storm入门》中文版
本文翻译自<Getting Started With Storm>译者:吴京润 编辑:郭蕾 方腾飞 本书的译文仅限于学习和研究之用,没有原作者和译者的授权不能用于商业用途. 译者序 ...
- Traceroute原理介绍
一.路由追踪 路由跟踪,就是获取从主机A到达目标主机B这个过程中所有需要经过的路由设备的转发接口IP. 二.ICMP协议 Internet控制报文协议(internet control message ...
- 高性能消息队列 CKafka 核心原理介绍(上)
欢迎大家前往腾讯云技术社区,获取更多腾讯海量技术实践干货哦~ 作者:闫燕飞 1.背景 Ckafka是基础架构部开发的高性能.高可用消息中间件,其主要用于消息传输.网站活动追踪.运营监控.日志聚合.流式 ...
- Kylin系列之二:原理介绍
Kylin系列之二:原理介绍 2018年4月15日 15:52 因何而生 Kylin和hive的区别 1. hive主要是离线分析平台,适用于已经有成熟的报表体系,每天只要定时运行即可. 2. Kyl ...
- Apache Storm内部原理分析
转自:http://shiyanjun.cn/archives/1472.html 本文算是个人对Storm应用和学习的一个总结,由于不太懂Clojure语言,所以无法更多地从源码分析,但是参考了官网 ...
随机推荐
- 2018,ANG发展峰会惊喜来袭
区块链的分享——ANG发展峰会重大来袭!2018年10月28日 时至今日,区块链技术已经被越来越多的人所熟知.法国著名的高新公司——凡赛公司汇集世界区块链专家,斥巨资打造了行业领先的区块链技术团队,并 ...
- Android : 跟我学Binder --- (4) 驱动情景分析
目录: Android : 跟我学Binder --- (1) 什么是Binder IPC?为何要使用Binder机制? Android : 跟我学Binder --- (2) AIDL分析及手动实现 ...
- 唤醒实验(java
package sy;import java.util.Random; public class random { public static void main(String[] args) { / ...
- copy GC 和 mark & compaction GC的算法异同
先标记 然后 copy GC是,对所有child,判断, 如果child没有被访问过,那么拷贝到新地址,child的forwording指向新地址,child标记为已访问,把自己对child的引用改为 ...
- 如何ASP.NET Core Razor中处理Ajax请求[转载]
在ASP.NET Core Razor(以下简称Razor)刚出来的时候,看了一下官方的文档,一直没怎么用过. 今天闲来无事,准备用Rozor做个项目熟练下,结果写第一个页面就卡住了..折腾半天才搞好 ...
- msfvenom生成各类Payload命令
Often one of the most useful (and to the beginner underrated) abilities of Metasploit is the msfpayl ...
- 计时 timeit
python中的计时器:timeit timeit 通常在一段程序的前后都用上time.time(),然后进行相减就可以得到一段程序的运行时间,不过python提供了更强大的计时库:timeit #导 ...
- mongodb初步使用体验
前言 Mongodb是一个非常有名的缓存数据库,和它名气相当的还有redis和hbase.笔者之前使用过redis,memcache和elasticsearch,借着工作机会,正好可以好好学习一下mo ...
- vscode 插件推荐 - 献给所有前端工程师(更新与2018.8.1)
VScode现在已经越来越完善.性能远超Atom和webstorm,你有什么理由不用它?在这里,我会给你们推荐很多实用的插件,让你对 vscode 有更深刻的体会,渐渐地你就会知道它有多好用. 走马观 ...
- 本地maven库导入架包
mvn install:install-file -DgroupId=com.alipay -DartifactId=sdk-java -Dversion=20170725114550 -Dpacka ...