
Spark机器学习中ml和mllib中矩阵、向量
1:Spark ML与Spark MLLIB区别?
Spark MLlib是面向RDD数据抽象的编程工具类库,现在已经逐渐不再被Spark团队支持,逐渐转向Spark ML库,Spark ML是面向DataFrame编程的。
2:Spark ML与Spark MLLIB中矩阵、向量定义区别?
这两个类库中的矩阵与向量对比可以发现几乎都是一样的,就是为了以后维护Spark ML方便。
3:Spark ML中稀疏向量与稠密向量区别?
稠密向量存储:底层存储使用完成的Double Array存储。
稀疏矩阵:底层存储非0的元素值以及该值的index以及向量的size。(也就是三维信息,存储效率高)
4:稠密向量示例:
 import org.apache.spark.ml.linalg.{DenseVector => MLDenseVector}

  val mlDv = new MLDenseVector(Array[Double](1, 1, 1, 1, 1))

  println(mlDv.argmax)

  //压缩矩阵,底层根据0的个数进行判断是稀疏存储还是稠密存储。稀疏存储就是存储非0的元素值以及索引以及向量的大小(也就是三维)

  println(mlDv.compressed)

  val copy = mlDv.copy //深拷贝

  copy.foreachActive {

    (x, y) =>

      println("index = " + x + " ,  value = " + y)

  }

  //Number of active entries. An "active entry" is an element which is explicitly(明确地) stored,

  // regardless of its value. Note that inactive entries have value 0.

  println(copy.numActives)

  println(copy.numNonzeros)

  println(copy.size)

  println(copy.values)

  println(copy.toSparse)
5:稀疏矩阵
 import org.apache.spark.ml.linalg.{SparseVector => MLSparseVector}

  val mlDv = new MLDenseVector(Array[Double](1, 0, 0, 0, 0))

  println(mlDv.toSparse)  //(5,[0],[1.0])

  //SparseVector构造器:向量维度,非零索引,非零索引对应的值

  val mlSv = new MLSparseVector(5, Array[Int](0, 3), Array[Double](1, 2))

  println(mlSv) //(5,[0,3],[1.0,2.0])

  println(mlSv.toDense) //[1.0,0.0,0.0,2.0,0.0]

  println(mlSv.indices.toBuffer)//返回稀疏向量的索引
对于mllib下的向量可以使用asML直接转成ML中的向量
  //稀疏矩阵

  import org.apache.spark.mllib.linalg.{DenseVector => MLLIBDenseVector}

  val mlDv = new MLLIBDenseVector(Array[Double](1, 0, 0, 0, 0))

  mlDv.asML //直接转成spark ml的向量
6:ML中矩阵
import org.apache.spark.ml.linalg.{DenseMatrix => MLDenseMatrix}

  import org.apache.spark.ml.linalg.{SparseMatrix => MLSparseMatrix}

  // 默认以列为主的稠密矩阵。

  val notTranspose = new MLDenseMatrix(3, 2, Array[Double](1, 3, 5, 2, 4, 6))

  // 第三个参数为是否允许转至,默认不允许,如果允许则按行存储

  val mlDMtx = new MLDenseMatrix(3, 2, Array[Double](1, 2, 3, 4, 5, 6), true)

  println(notTranspose)

  println("-------------------------------------------------")

  println(notTranspose.isTransposed)

  println(notTranspose.transpose)

  println(mlDMtx.isTransposed)

  println("-------------------------------------------------")

  println(mlDMtx)

  println(mlDMtx.compressed)

  println("-------------------------------------------------")

  //转为按照列存储的稠密矩阵

  println(mlDMtx.toDenseColMajor)

  //转为按照行存储的稠密矩阵

  println(notTranspose.toDenseRowMajor)
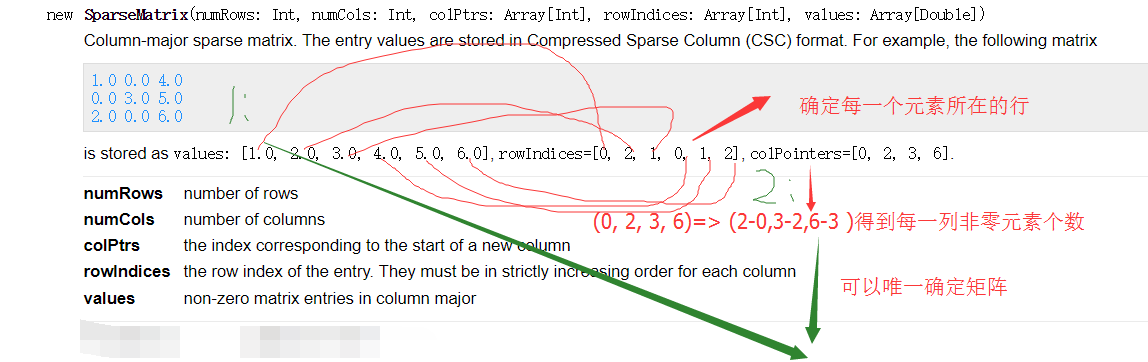
7稀疏矩阵:
  println("--------------------MLSparseMatrix-----------------------------")

  //  numRows - number of rows

  //  numCols - number of columns

  //  colPtrs - the index corresponding to the start of a new column

  //  rowIndices - the row index of the entry. They must be in strictly increasing order for each column

  //  values - non-zero matrix entries in column major

  //  (0, 2, 1, 0, 1, 2)

  //  (0, 2, 3, 6)=> (2-0,3-2,6-3 )得到每一列非零元素个数

  //  (1.0, 2.0, 3.0, 4.0, 5.0, 6.0)

  val mlSM = new MLSparseMatrix(3, 3, Array[Int](0, 2, 3, 6), Array[Int](0, 2, 1, 0, 1, 2), Array[Double](1.0, 2.0, 3.0, 4.0, 5.0, 6.0))

  println(mlSM.toDense)
Spark机器学习中ml和mllib中矩阵、向量的更多相关文章
- Spark中ml和mllib的区别
转载自:https://vimsky.com/article/3403.html Spark中ml和mllib的主要区别和联系如下: ml和mllib都是Spark中的机器学习库,目前常用的机器学习功 ...
- Spark机器学习(8):LDA主题模型算法
1. LDA基础知识 LDA(Latent Dirichlet Allocation)是一种主题模型.LDA一个三层贝叶斯概率模型,包含词.主题和文档三层结构. LDA是一个生成模型,可以用来生成一篇 ...
- 转载:Databricks孟祥瑞:ALS 在 Spark MLlib 中的实现
Databricks孟祥瑞:ALS 在 Spark MLlib 中的实现 发表于2015-05-07 21:58| 10255次阅读| 来源<程序员>电子刊| 9 条评论| 作者孟祥瑞 大 ...
- Spark MLlib中KMeans聚类算法的解析和应用
聚类算法是机器学习中的一种无监督学习算法,它在数据科学领域应用场景很广泛,比如基于用户购买行为.兴趣等来构建推荐系统. 核心思想可以理解为,在给定的数据集中(数据集中的每个元素有可被观察的n个属性), ...
- Spark机器学习MLlib系列1(for python)--数据类型,向量,分布式矩阵,API
Spark机器学习MLlib系列1(for python)--数据类型,向量,分布式矩阵,API 关键词:Local vector,Labeled point,Local matrix,Distrib ...
- Spark MLlib中的OneHot哑变量实践
在机器学习中,线性回归和逻辑回归算是最基础入门的算法,很多书籍都把他们作为第一个入门算法进行介绍.除了本身的公式之外,逻辑回归和线性回归还有一些必须要了解的内容.一个很常用的知识点就是虚拟变量(也叫做 ...
- Apache Spark源码走读之23 -- Spark MLLib中拟牛顿法L-BFGS的源码实现
欢迎转载,转载请注明出处,徽沪一郎. 概要 本文就拟牛顿法L-BFGS的由来做一个简要的回顾,然后就其在spark mllib中的实现进行源码走读. 拟牛顿法 数学原理 代码实现 L-BFGS算法中使 ...
- 机器学习中的数学-强大的矩阵奇异值分解(SVD)及其应用
版权声明: 本文由LeftNotEasy发布于http://leftnoteasy.cnblogs.com, 本文可以被全部的转载或者部分使用,但请注明出处,如果有问题,请联系wheeleast@gm ...
- MLlib 中的聚类和分类
聚类和分类是机器学习中两个常用的算法,聚类将数据分开为不同的集合,分类对新数据进行类别预测,下面将就两类算法进行介绍. 1. 聚类和分类(1)什么是聚类 聚类( Clustering)指将数据对象分组 ...
随机推荐
- Java Generator
以前我以为只有Python才会有generator,看来当时的我才年轻,后来认真研读<Thinking in Java>之后大有感悟,原来Java亦有generator,故做一次记录分享. ...
- VSCode git Warning LF will be replaced by CRLF
本文参考自:http://www.yulongjun.com/linux/20170518-08-lf-cr/ 我们打开Visual Studio Code编辑器,可以看到右下角有这个LF,这是VS ...
- quartz部署出现找不到表的情况,错误提示: Table 'heart_beat.QRTZ_LOCKS' doesn't exist
描述一下,本地可以,部署到Linux就不行,Linux上的数据库是本地直接拷贝上去的,项目环境是Spring Boot2.1.Shiro.MyBatis.Redis.swagger.Bootstrap ...
- Python十讲 - 第二讲:变量和基础数据类型
本讲主要内容 变量 字符串 数字和运算符 数据类型转换 2.1 变量 1. 变量是什么? 变量,是指把程序运行的中间结果临时的存在内存里,以便后续的代码调用,其值可以修改. 在python中,当变量被 ...
- sql server:alter database name
--step 1 : 修改数据库名称 USE master GO ALTER DATABASE GeovinDuCms SET SINGLE_USER WITH ROLLBACK IMMEDIATE ...
- Spark 跑 java 示例代码
一.下载示例代码: git clone https://github.com/melphi/spark-examples.git 从示例代码中可以看到 pox中引入了 Spark开发所需要的依赖. 二 ...
- 洛谷P3722 [AH2017/HNOI2017]影魔(线段树)
题意 题目链接 Sol 题解好神仙啊qwq. 一般看到这种考虑最大值的贡献的题目不难想到单调数据结构 对于本题而言,我们可以预处理出每个位置左边第一个比他大的位置\(l_i\)以及右边第一个比他大的位 ...
- Apex的对象共享
Apex的对象共享 在Apex中,每个对象都有一个"共享"对象,其中存储了该对象的共享设定. 这种共享对象以"share"结尾.比如Account的共享对象是A ...
- Runtime消息动态解析与转发流程
先上图: 下面根据具体代码看这张图. 一.创建一个Person类, Person.h #import <Foundation/Foundation.h> @interface Person ...
- 基于Jmeter和Testlink的自动化测试框架研究与实施
关于测试框架搭建的详细过程,会在另一篇文章中详细介绍:http://www.cnblogs.com/leeboke/p/6145977.html 摘 要 目前基于Jmeter的接口自动化测试框架,大多 ...