
sklearn LDA降维算法
sklearn LDA降维算法
LDA(Linear Discriminant Analysis)线性判断别分析,可以用于降维和分类。其基本思想是类内散度尽可能小,类间散度尽可能大,是一种经典的监督式降维/分类技术。
sklearn代码实现
#coding=utf-8

import pandas as pd

import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split

from sklearn import datasets

from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

import numpy as np

def main():

    iris = datasets.load_iris() #典型分类数据模型

    #这里我们数据统一用pandas处理

    data = pd.DataFrame(iris.data, columns=iris.feature_names)

    data['class'] = iris.target

    #这里只取两类

#     data = data[data['class']!=2]

    #为了可视化方便,这里取两个属性为例

    X = data[data.columns.drop('class')]

    Y = data['class']

    #划分数据集

    X_train, X_test, Y_train, Y_test =train_test_split(X, Y)

    lda = LinearDiscriminantAnalysis(n_components=2)

    lda.fit(X_train, Y_train)

    #显示训练结果

    print lda.means_ #中心点

    print lda.score(X_test, Y_test) #score是指分类的正确率

    print lda.scalings_ #score是指分类的正确率

    X_2d = lda.transform(X) #现在已经降到二维X_2d=np.dot(X-lda.xbar_,lda.scalings_)

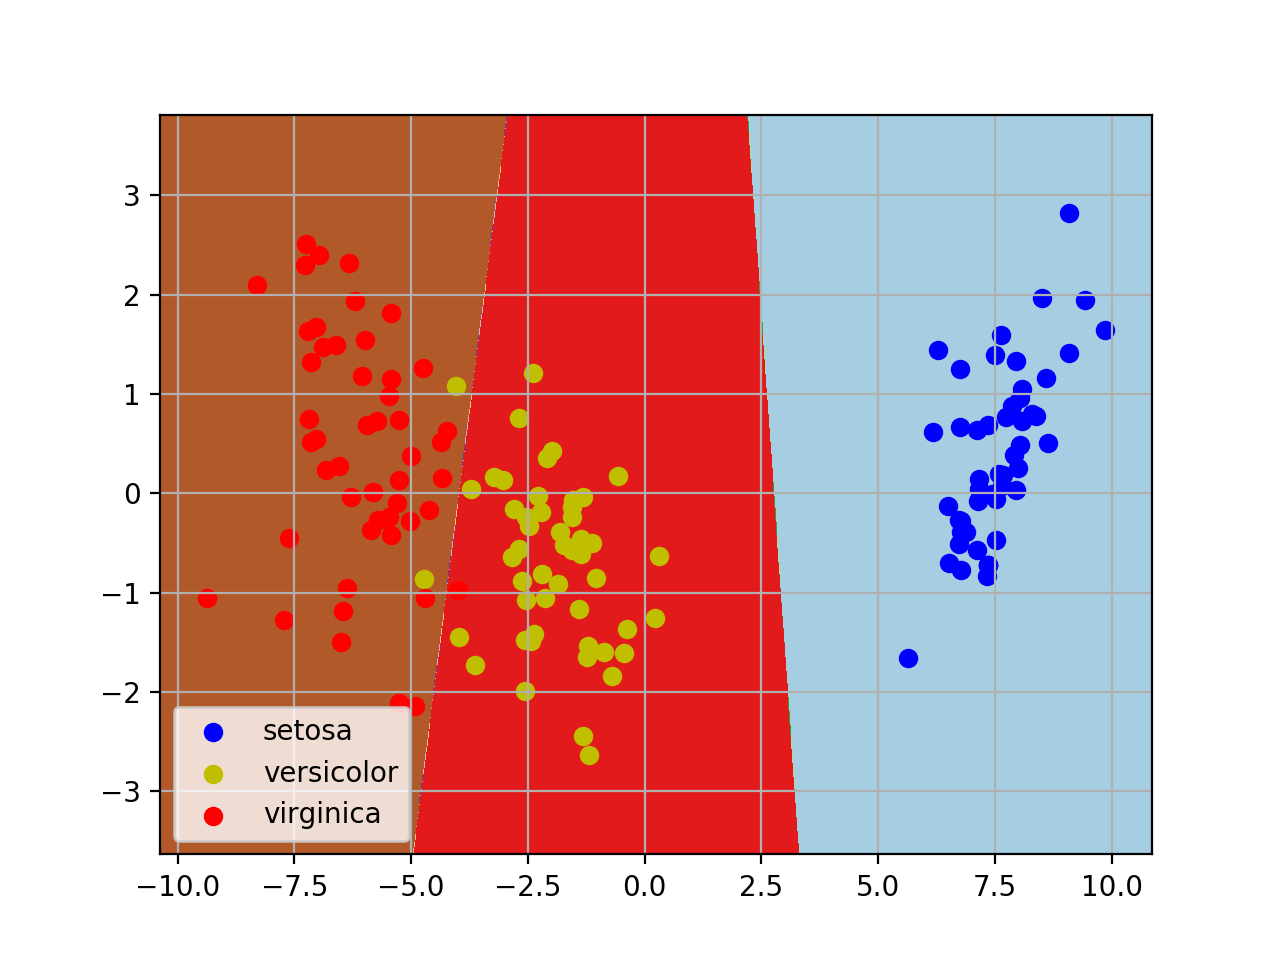
    #对于二维数据,我们做个可视化

    #区域划分

    lda.fit(X_2d,Y)

    h = 0.02

    x_min, x_max = X_2d[:, 0].min() - 1, X_2d[:, 0].max() + 1

    y_min, y_max = X_2d[:, 1].min() - 1, X_2d[:, 1].max() + 1

    xx, yy = np.meshgrid(np.arange(x_min, x_max, h),

                         np.arange(y_min, y_max, h))

    Z = lda.predict(np.c_[xx.ravel(), yy.ravel()])

    Z = Z.reshape(xx.shape)

    plt.contourf(xx, yy, Z, cmap=plt.cm.Paired)

    #做出原来的散点图

    class1_x = X_2d[Y==0,0]

    class1_y = X_2d[Y==0,1]

    l1 = plt.scatter(class1_x,class1_y,color='b',label=iris.target_names[0])

    class1_x = X_2d[Y==1,0]

    class1_y = X_2d[Y==1,1]

    l2 = plt.scatter(class1_x,class1_y,color='y',label=iris.target_names[1])

    class1_x = X_2d[Y==2,0]

    class1_y = X_2d[Y==2,1]

    l3 = plt.scatter(class1_x,class1_y,color='r',label=iris.target_names[2])

    plt.legend(handles = [l1, l2, l3], loc = 'best')

    plt.grid(True)

    plt.show()

if __name__ == '__main__':

    main()
测试结果
Means: #各类的中心点

[[ 5.00810811  3.41891892  1.44594595  0.23513514]

 [ 6.06410256  2.80769231  4.32564103  1.33589744]

 [ 6.61666667  2.97222222  5.63055556  2.02777778]]

Score: #对于测试集的正确率

0.973684210526

Scalings:

[[ 1.19870893  0.76465114]

 [ 1.20339741 -2.46937995]

 [-2.55937543  0.42562073]

 [-2.77824826 -2.4470865 ]]

Xbar:

[ 5.89285714  3.0625      3.79375     1.19464286]

#X'=np.dot(X-lda.xbar_,lda.scalings_)默认的线性变化方程
sklearn LDA降维算法的更多相关文章
- 机器学习实战基础(二十):sklearn中的降维算法PCA和SVD(一) 之 概述
概述 1 从什么叫“维度”说开来 我们不断提到一些语言,比如说:随机森林是通过随机抽取特征来建树,以避免高维计算:再比如说,sklearn中导入特征矩阵,必须是至少二维:上周我们讲解特征工程,还特地提 ...
- 降维算法整理--- PCA、KPCA、LDA、MDS、LLE 等
转自github: https://github.com/heucoder/dimensionality_reduction_alo_codes 网上关于各种降维算法的资料参差不齐,同时大部分不提供源 ...
- 参考:菜菜的sklearn教学之降维算法.pdf!!
PCA(主成分分析法) 1. PCA(最大化方差定义或者最小化投影误差定义)是一种无监督算法,也就是我们不需要标签也能对数据做降维,这就使得其应用范围更加广泛了.那么PCA的核心思想是什么呢? 例如D ...
- 四大机器学习降维算法:PCA、LDA、LLE、Laplacian Eigenmaps
四大机器学习降维算法:PCA.LDA.LLE.Laplacian Eigenmaps 机器学习领域中所谓的降维就是指采用某种映射方法,将原高维空间中的数据点映射到低维度的空间中.降维的本质是学习一个映 ...
- ML: 降维算法-LDA
判别分析(discriminant analysis)是一种分类技术.它通过一个已知类别的“训练样本”来建立判别准则,并通过预测变量来为未知类别的数据进行分类.判别分析的方法大体上有三类,即Fishe ...
- 【转】四大机器学习降维算法:PCA、LDA、LLE、Laplacian Eigenmaps
最近在找降维的解决方案中,发现了下面的思路,后面可以按照这思路进行尝试下: 链接:http://www.36dsj.com/archives/26723 引言 机器学习领域中所谓的降维就是指采用某种映 ...
- 机器学习实战基础(二十三):sklearn中的降维算法PCA和SVD(四) PCA与SVD 之 PCA中的SVD
PCA中的SVD 1 PCA中的SVD哪里来? 细心的小伙伴可能注意到了,svd_solver是奇异值分解器的意思,为什么PCA算法下面会有有关奇异值分解的参数?不是两种算法么?我们之前曾经提到过,P ...
- 机器学习实战基础(二十一):sklearn中的降维算法PCA和SVD(二) PCA与SVD 之 降维究竟是怎样实现
简述 在降维过程中,我们会减少特征的数量,这意味着删除数据,数据量变少则表示模型可以获取的信息会变少,模型的表现可能会因此受影响.同时,在高维数据中,必然有一些特征是不带有有效的信息的(比如噪音),或 ...
- 用scikit-learn进行LDA降维
在线性判别分析LDA原理总结中,我们对LDA降维的原理做了总结,这里我们就对scikit-learn中LDA的降维使用做一个总结. 1. 对scikit-learn中LDA类概述 在scikit-le ...
随机推荐
- DDD工作流持久化(十六)
找到对应的sql文件执行sql语句 产生如下的表: 添加引用: 添加命名空间: using System.Activities.DurableInstancing; using System.Runt ...
- SQL Server 常用函数使用方法
之前就想要把一些 SQL 的常用函数记录下来, 直到今天用到substring()这个函数,C# 里面这个方法起始值是 0,而 SQL 里面起始值是 1.傻傻分不清楚... 这篇博客作为记录 SQL ...
- Vuex详解笔记2
关于 state 每个vuex 应用只有一个 store 实例,所以使用起来不会太复杂,对于定位错误状态和操作会很方便. 简单用法:在vuex 的计算属性中返回vuex 的状态 最基本的使用方式,通过 ...
- Elasticsearch snapshot 备份的使用方法 【备忘】
常见的数据库都会提供备份的机制,以解决在数据库无法使用的情况下,可以开启新的实例,然后通过备份来恢复数据减少损失.虽然 Elasticsearch 有良好的容灾性,但由于以下原因,其依然需要备份机制. ...
- BZOJ5084[hashit]
题解: 后缀自动机 我们可以通过建立trie 把询问变成询问一些点的并 把trie建立成SAM和广义SAM基本相同,就是在父亲和儿子之间连边 然后就变成了询问树链的并 我们可以发现答案=sigma d ...
- net core体系-web应用程序-4net core2.0大白话带你入门-2asp.net core新建项目
新建asp.net core项目 开发环境:Windows Server R2 2008 开发工具:Microsoft Visual Studio 2017 新建asp.net core项目 创建 ...
- cactiEZ 配置
CactiEZ 中文版是简单有效的cacti中文解决方案,它基于centos6 整合了cacti的相关软件,重新编译的一个新的操作系统 它基于centos6,启动速度快,支持EXT4文件系统,全中文页 ...
- .net core跨平台的文件路径
windows下路径为:"xxxx\\yyyy" linux路径下为:"xxxx/yyyy" 用Path.Combine("xxxx",&q ...
- Floyd算法-傻子也能看懂的弗洛伊德算法(转)
暑假,小哼准备去一些城市旅游.有些城市之间有公路,有些城市之间则没有,如下图.为了节省经费以及方便计划旅程,小哼希望在出发之前知道任意两个城市之前的最短路程. ...
- 模运算(附加几种数据类型的数据范围判断)-hdu3123
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=3123 预备知识点: (a+b)%m=[(a%m)+(b%m)]%m(a*b)%m=[(a%m)*(b% ...