
Zeppelin使用spark解释器
Zeppelin为0.5.6
Zeppelin默认自带本地spark,可以不依赖任何集群,下载bin包,解压安装就可以使用。
使用其他的spark集群在yarn模式下。
配置:
vi zeppelin-env.sh

添加:
export SPARK_HOME=/usr/crh/current/spark-client

export SPARK_SUBMIT_OPTIONS="--driver-memory 512M --executor-memory 1G"

export HADOOP_CONF_DIR=/etc/hadoop/conf
Zeppelin Interpreter配置

注意:设置完重启解释器。
Properties的master属性如下:

新建Notebook
Tips:几个月前zeppelin还是0.5.6,现在最新0.6.2,zeppelin 0.5.6写notebook时前面必须加%spark,而0.6.2若什么也不加就默认是scala语言。
zeppelin 0.5.6不加就报如下错:
Connect to 'databank:4300' failed
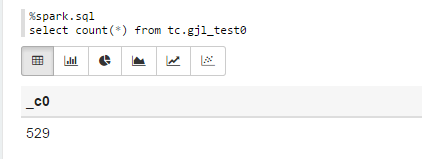
%spark.sql

select count(*) from tc.gjl_test0
报错:
com.fasterxml.jackson.databind.JsonMappingException: Could not find creator property with name 'id' (in class org.apache.spark.rdd.RDDOperationScope)

 at [Source: {"id":"2","name":"ConvertToSafe"}; line: 1, column: 1]

	at com.fasterxml.jackson.databind.JsonMappingException.from(JsonMappingException.java:148)

	at com.fasterxml.jackson.databind.DeserializationContext.mappingException(DeserializationContext.java:843)

	at com.fasterxml.jackson.databind.deser.BeanDeserializerFactory.addBeanProps(BeanDeserializerFactory.java:533)

	at com.fasterxml.jackson.databind.deser.BeanDeserializerFactory.buildBeanDeserializer(BeanDeserializerFactory.java:220)

	at com.fasterxml.jackson.databind.deser.BeanDeserializerFactory.createBeanDeserializer(BeanDeserializerFactory.java:143)

	at com.fasterxml.jackson.databind.deser.DeserializerCache._createDeserializer2(DeserializerCache.java:409)

	at com.fasterxml.jackson.databind.deser.DeserializerCache._createDeserializer(DeserializerCache.java:358)

	at com.fasterxml.jackson.databind.deser.DeserializerCache._createAndCache2(DeserializerCache.java:265)

	at com.fasterxml.jackson.databind.deser.DeserializerCache._createAndCacheValueDeserializer(DeserializerCache.java:245)

	at com.fasterxml.jackson.databind.deser.DeserializerCache.findValueDeserializer(DeserializerCache.java:143)

	at com.fasterxml.jackson.databind.DeserializationContext.findRootValueDeserializer(DeserializationContext.java:439)

	at com.fasterxml.jackson.databind.ObjectMapper._findRootDeserializer(ObjectMapper.java:3666)

	at com.fasterxml.jackson.databind.ObjectMapper._readMapAndClose(ObjectMapper.java:3558)

	at com.fasterxml.jackson.databind.ObjectMapper.readValue(ObjectMapper.java:2578)

	at org.apache.spark.rdd.RDDOperationScope$.fromJson(RDDOperationScope.scala:85)

	at org.apache.spark.rdd.RDDOperationScope$$anonfun$5.apply(RDDOperationScope.scala:136)

	at org.apache.spark.rdd.RDDOperationScope$$anonfun$5.apply(RDDOperationScope.scala:136)

	at scala.Option.map(Option.scala:145)

	at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:136)

	at org.apache.spark.sql.execution.SparkPlan.execute(SparkPlan.scala:130)

	at org.apache.spark.sql.execution.ConvertToSafe.doExecute(rowFormatConverters.scala:56)

	at org.apache.spark.sql.execution.SparkPlan$$anonfun$execute$5.apply(SparkPlan.scala:132)

	at org.apache.spark.sql.execution.SparkPlan$$anonfun$execute$5.apply(SparkPlan.scala:130)

	at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:150)

	at org.apache.spark.sql.execution.SparkPlan.execute(SparkPlan.scala:130)

	at org.apache.spark.sql.execution.SparkPlan.executeTake(SparkPlan.scala:187)

	at org.apache.spark.sql.execution.Limit.executeCollect(basicOperators.scala:165)

	at org.apache.spark.sql.execution.SparkPlan.executeCollectPublic(SparkPlan.scala:174)

	at org.apache.spark.sql.DataFrame$$anonfun$org$apache$spark$sql$DataFrame$$execute$1$1.apply(DataFrame.scala:1499)

	at org.apache.spark.sql.DataFrame$$anonfun$org$apache$spark$sql$DataFrame$$execute$1$1.apply(DataFrame.scala:1499)

	at org.apache.spark.sql.execution.SQLExecution$.withNewExecutionId(SQLExecution.scala:56)

	at org.apache.spark.sql.DataFrame.withNewExecutionId(DataFrame.scala:2086)

	at org.apache.spark.sql.DataFrame.org$apache$spark$sql$DataFrame$$execute$1(DataFrame.scala:1498)

	at org.apache.spark.sql.DataFrame.org$apache$spark$sql$DataFrame$$collect(DataFrame.scala:1505)

	at org.apache.spark.sql.DataFrame$$anonfun$head$1.apply(DataFrame.scala:1375)

	at org.apache.spark.sql.DataFrame$$anonfun$head$1.apply(DataFrame.scala:1374)

	at org.apache.spark.sql.DataFrame.withCallback(DataFrame.scala:2099)

	at org.apache.spark.sql.DataFrame.head(DataFrame.scala:1374)

	at org.apache.spark.sql.DataFrame.take(DataFrame.scala:1456)

	at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)

	at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:57)

	at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)

	at java.lang.reflect.Method.invoke(Method.java:606)

	at org.apache.zeppelin.spark.ZeppelinContext.showDF(ZeppelinContext.java:297)

	at org.apache.zeppelin.spark.SparkSqlInterpreter.interpret(SparkSqlInterpreter.java:144)

	at org.apache.zeppelin.interpreter.ClassloaderInterpreter.interpret(ClassloaderInterpreter.java:57)

	at org.apache.zeppelin.interpreter.LazyOpenInterpreter.interpret(LazyOpenInterpreter.java:93)

	at org.apache.zeppelin.interpreter.remote.RemoteInterpreterServer$InterpretJob.jobRun(RemoteInterpreterServer.java:300)

	at org.apache.zeppelin.scheduler.Job.run(Job.java:169)

	at org.apache.zeppelin.scheduler.FIFOScheduler$1.run(FIFOScheduler.java:134)

	at java.util.concurrent.Executors$RunnableAdapter.call(Executors.java:471)

	at java.util.concurrent.FutureTask.run(FutureTask.java:262)

	at java.util.concurrent.ScheduledThreadPoolExecutor$ScheduledFutureTask.access$201(ScheduledThreadPoolExecutor.java:178)

	at java.util.concurrent.ScheduledThreadPoolExecutor$ScheduledFutureTask.run(ScheduledThreadPoolExecutor.java:292)

	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1145)

	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:615)

	at java.lang.Thread.run(Thread.java:745)
原因:
进入/opt/zeppelin-0.5.6-incubating-bin-all目录下:
# ls lib |grep jackson

jackson-annotations-2.5.0.jar

jackson-core-2.5.3.jar

jackson-databind-2.5.3.jar
将里面的版本换成如下版本:
# ls lib |grep jackson

jackson-annotations-2.4.4.jar

jackson-core-2.4.4.jar

jackson-databind-2.4.4.jar
测试成功!
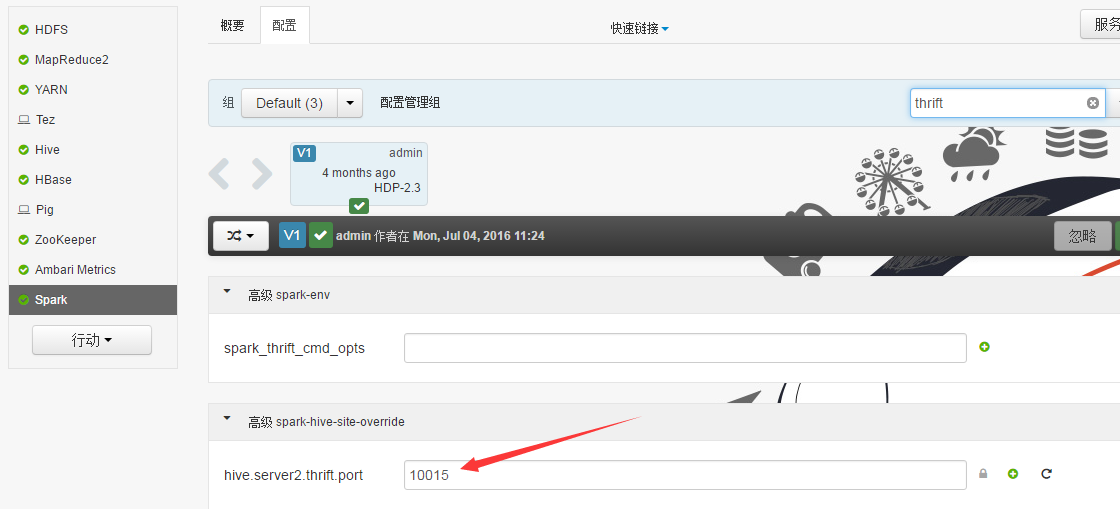
Sparksql也可直接通过hive jdbc连接,只需换端口,如下图:

Zeppelin使用spark解释器的更多相关文章
- Zeppelin使用Spark的yarn-client模式
Zeppelin版本0.6.2 1. Export SPARK_HOME In conf/zeppelin-env.sh, export SPARK_HOME environment variable ...
- Zeppelin0.5.6使用spark解释器
Zeppelin为0.5.6 Zeppelin默认自带本地spark,可以不依赖任何集群,下载bin包,解压安装就可以使用. 使用其他的spark集群在yarn模式下. 配置: vi zeppelin ...
- Zeppelin添加mysql解释器
安装Apache zeppelin 1 wget http://apache.fayea.com/zeppelin/zeppelin-0.6.2/zeppelin-0.6.2-bin-all.tgz ...
- Zeppelin使用phoenix解释器
Interpreters设置
- Zeppelin 0.6.2使用Spark的yarn-client模式
Zeppelin版本0.6.2 1. Export SPARK_HOME In conf/zeppelin-env.sh, export SPARK_HOME environment variable ...
- Spark实战2:Zeppelin的安装和SparkSQL使用总结
zeppelin是spark的web版本notebook编辑器,相当于ipython的notebook编辑器. 一Zeppelin安装 (前提是spark已经安装好) 1 下载https://zepp ...
- Ubuntu下基于Saprk安装Zeppelin
前言 Apache Zeppelin是一款基于web的notebook(类似于ipython的notebook),支持交互式地数据分析,即一个Web笔记形式的交互式数据查询分析工具,可以在线用scal ...
- Zeppelin原理简介
Zeppelin是一个基于Web的notebook,提供交互数据分析和可视化.后台支持接入多种数据处理引擎,如spark,hive等.支持多种语言: Scala(Apache Spark).Pytho ...
- Spark in meituan http://tech.meituan.com/spark-in-meituan.html
Spark在美团的实践 忽略元数据末尾 回到原数据开始处 引言:Spark美团系列终于凑成三部曲了,Spark很强大应用很广泛, 文中Spark交互式开发平台和作业ETL模板的设计都很有启发借鉴意义. ...
随机推荐
- Django回忆录
Django使用回忆: 1.安装django: pip install django==1.9 2.创建项目及应用: django-admin startproject web django-admi ...
- [转]numpy线性代数基础 - Python和MATLAB矩阵处理的不同
转自:http://blog.csdn.net/pipisorry/article/details/45563695 http://blog.csdn.net/pipisorry/article/de ...
- 命令行启动Hololens Emulator,可解决内存不足的问题
有时候在虚拟机测试时常会出现 内存不足 的情况,导致应用卡顿,调整 /memsize 参数大小: start "HoloLens" "C:\Program Files ( ...
- 使用pycharm+pyqt5 调取界面程序
一.使用QtDesigner制作界面 1)打开的界面设计工具QtDesigner,如图: 2)新建窗体,选择Main Window: 3)分别在窗口添加如下控件,Calendar.3个pushButt ...
- (转载)ANDROID STRINGS.XML 中的特殊字符转义
今天项目碰到个转义特殊字符的问题,网上搜索看到,故转载,已标明出处: 项目中要在string.xml 中显示特殊符号.如@号冒号等.直接写肯定不行啦 只能考虑使用ASCII码进行显示.在XML中空格符 ...
- uoj 55 紫荆花之恋 动态点分治+替罪羊式重构+treap
每插入一个点,直接把它当做重心插入原树,当做是动态点分树一样维护 但这样深度会越来越大,所以我们用类似替罪羊的方法 当树失去平衡时,对子树进行一次点分,保证复杂度 #include <cstdi ...
- 《Intel汇编第5版》 汇编调用子过程
一.Call和Ret指令 二.在子过程中需要自己保存可能会修改掉的寄存器值,这里可以使用USES伪指令来生成 三.一个数组求和的汇编例子 TITLE Call a Proc Demo INCLUDE ...
- Visual Studio下使用jQuery的10个技巧
广泛流行的jQuery是一个开源的,跨浏览器和兼容CSS 3的JavaScript库,你可以用它简化你的JavaScript编码任务和操作(添加,编辑和删除)HTML内容中的DOM元素,本文介绍10个 ...
- underScore学习1:匿名函数中call(this)的作用
匿名函数中(function(){}).call(this) 中的.call(this) 有什么用? 我们都知道,.call()可以改变函数执行时的context,即this的指向,源码中的.call ...
- Eclipse主题设置
1. 内部编辑区域主题 Eclipse黑色主题包 下载主题包解压到Eclipse安装目录下的dropins目录,重启Eclipse,Windows—>Preferences—>Genera ...