
[Spark SQL_3] Spark SQL 高级操作
0. 说明
DataSet 介绍 && Spark SQL 访问 JSON 文件 && Spark SQL 访问 Parquet 文件 && Spark SQL 访问 JDBC 数据库 && Spark SQL 作为分布式查询引擎
1. DataSet 介绍
强类型集合,可以转换成并行计算。
Dataset 上可以执行的操作分为 Transfermation 和 Action ,类似于 RDD。
Transfermation 生成新的 DataSet,Action 执行计算并返回结果。
DataSet 是延迟计算,只有当调用 Action 时才会触发执行。内部表现为逻辑计划。
Action 调用时,Spark 的查询优化器对逻辑计划进行优化,生成物理计划,用于分布式行为下高效的执行。
具体的执行计划可以通过 explain函数 来查看,方式如下:
scala> spark.sql("explain select name,class,score from tb_student").show(,false)
结果如图所示,show(1000 , false) 表示显式 1000行数据,结果不截断显式。

2. Spark SQL 访问 JSON 文件
【保存 JSON 文件】
# 创建 DataFrame

scala> val df = spark.sql("select * from orders")

# 输出 JSON 文件

scala> df.write.json("file:///home/centos/json")
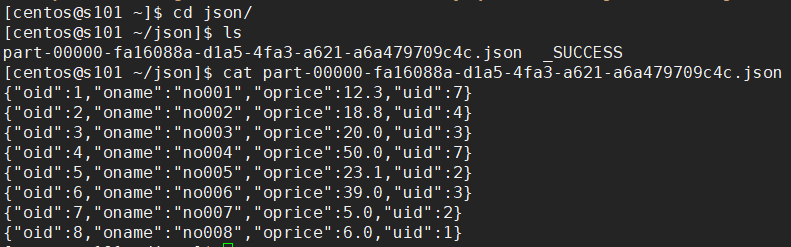
【读取 JSON 文件】
scala> val df = spark.read.json("file:///home/centos/json")

scala> df.show
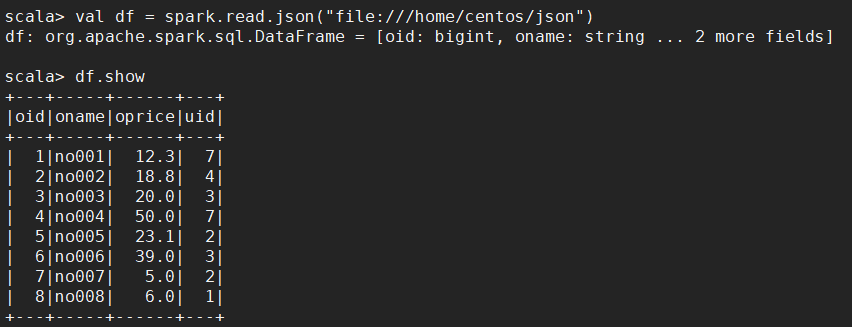
3. Spark SQL 访问 Parquet 文件
【保存】
# 创建 DataFrame

scala> val df = spark.sql("select * from orders")

# 保存成 parquet 文件

scala> df.write.parquet("file:///home/centos/par")
【读取】
# 创建 DataFrame

scala> val df = spark.read.parquet("file:///home/centos/par")

# 读取 Parquet 文件

scala> df.show

4. Spark SQL 访问 JDBC 数据库
【4.1 处理第三方 jar】
spark SQL 是分布式数据库访问,需要将驱动程序分发到所有 worker 节点或者通过 --jars 命令指定附件
分发 jar 到所有节点 ,third.jar 为第三方 jar 包
xsync /soft/spark/jars/third.jar
通过--jars 命令指定
spark-shell --master spark://s101:7077 --jars /soft/spark/jars/third.jar
【4.2 读取 MySQL 数据】
val prop = new java.util.Properties()

prop.put("driver" , "com.mysql.jdbc.Driver")

prop.put("user" , "root")

prop.put("password" , "root")

# 读取

val df = spark.read.jdbc("jdbc:mysql://192.168.23.101:3306/big12" , "music" ,prop) ;

# 显示

df.show
【4.3 保存数据到 MySQL 表(表不能存在)】
val prop = new java.util.Properties()

prop.put("driver" , "com.mysql.jdbc.Driver")

prop.put("user" , "root")

prop.put("password" , "root")

# 保存

dataframe.write.jdbc("jdbc:mysql://192.168.231.1:3306/mydb" , "emp" ,prop ) ;
5. Spark SQL 作为分布式查询引擎
【5.1 说明】
终端用户或应用程序可以直接同 Spark SQL 交互,而不需要写其他代码。

【5.2 启动 Spark的 thrift-server 进程】
在 spark/sbin 目录下执行以下操作
[centos@s101 /soft/spark/sbin]$ start-thriftserver.sh --master spark://s101:7077
【5.3 验证】
查看 Spark WebUI,访问 http://s101:8080
端口检查,检查10000端口是否启动
netstat -anop | grep
【5.4 使用 Spark 的 beeline 程序测试】
在 spark/bin 目录下执行以下操作
# 进入 Spark 的 beeline

[centos@s101 /soft/spark/bin]$ ./beeline

# 连接 Hive

!connect jdbc:hive2://localhost:10000/big12;auth=noSasl

# 查看表

: jdbc:hive2://localhost:10000/big12> show tables;
【5.5 编写客户端 Java 程序与 Spark 分布式查询引擎交互】
[添加依赖]
        <dependency>

            <groupId>org.apache.hive</groupId>

            <artifactId>hive-exec</artifactId>

            <version>2.1.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hive</groupId>

            <artifactId>hive-jdbc</artifactId>

            <version>2.1.0</version>

        </dependency>
[代码编写]
package com.share.sparksql;

import java.sql.Connection;

import java.sql.DriverManager;

import java.sql.ResultSet;

/**

 * 使用 Spark SQL 分布式查询引擎

 */

public class ThriftServerDemo {

    public static void main(String[] args) {

        try {

            Class.forName("org.apache.hive.jdbc.HiveDriver");

            Connection connection = DriverManager.getConnection("jdbc:hive2://s101:10000/big12;auth=noSasl");

            ResultSet rs = connection.createStatement().executeQuery("select * from orders");

            while (rs.next()) {

                System.out.printf("%d / %s\r\n", rs.getInt(1), rs.getString(2));

            }

            rs.close();

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

}
[特别说明]
以上黄色部分为 HiveServer2 的验证模式,如果未添加以上黄色部分则会报错,报错如下:

[Spark SQL_3] Spark SQL 高级操作的更多相关文章
- 大数据学习day25------spark08-----1. 读取数据库的形式创建DataFrame 2. Parquet格式的数据源 3. Orc格式的数据源 4.spark_sql整合hive 5.在IDEA中编写spark程序(用来操作hive) 6. SQL风格和DSL风格以及RDD的形式计算连续登陆三天的用户
1. 读取数据库的形式创建DataFrame DataFrameFromJDBC object DataFrameFromJDBC { def main(args: Array[String]): U ...
- 【转】【技术博客】Spark性能优化指南——高级篇
http://mp.weixin.qq.com/s?__biz=MjM5NjQ5MTI5OA==&mid=2651745207&idx=1&sn=3d70d59cede236e ...
- Spark性能优化指南——高级篇
本文转载自:https://tech.meituan.com/spark-tuning-pro.html 美团技术点评团队) Spark性能优化指南——高级篇 李雪蕤 ·2016-05-12 14:4 ...
- 大数据技术之_27_电商平台数据分析项目_02_预备知识 + Scala + Spark Core + Spark SQL + Spark Streaming + Java 对象池
第0章 预备知识0.1 Scala0.1.1 Scala 操作符0.1.2 拉链操作0.2 Spark Core0.2.1 Spark RDD 持久化0.2.2 Spark 共享变量0.3 Spark ...
- 小记---------spark组件与其他组件的比较 spark/mapreduce ;spark sql/hive ; spark streaming/storm
Spark与Hadoop的对比 Scala是Spark的主要编程语言,但Spark还支持Java.Python.R作为编程语言 Hadoop的编程语言是Java
- [Spark] 05 - Spark SQL
关于Spark SQL,首先会想到一个问题:Apache Hive vs Apache Spark SQL – 13 Amazing Differences Hive has been known t ...
- Hive on Spark和Spark sql on Hive,你能分的清楚么
摘要:结构上Hive On Spark和SparkSQL都是一个翻译层,把一个SQL翻译成分布式可执行的Spark程序. 本文分享自华为云社区<Hive on Spark和Spark sql o ...
- Spark 键值对RDD操作
键值对的RDD操作与基本RDD操作一样,只是操作的元素由基本类型改为二元组. 概述 键值对RDD是Spark操作中最常用的RDD,它是很多程序的构成要素,因为他们提供了并行操作各个键或跨界点重新进行数 ...
- spark中RDD的转化操作和行动操作
本文主要是讲解spark里RDD的基础操作.RDD是spark特有的数据模型,谈到RDD就会提到什么弹性分布式数据集,什么有向无环图,本文暂时不去展开这些高深概念,在阅读本文时候,大家可以就把RDD当 ...
随机推荐
- DOS在这里
转自: http://blog.csdn.net/rheostat/article/details/8043835 在右键菜单中添加Dos快捷通道-dos在这里 在右键菜单中添加 Dos 窗体 不用每 ...
- tcp/ip通信中ip头部结构iph->check校验计算
通过raw socket修改通信数据后,可通过该函数重新校验计算iph->check值 在http://www.cnblogs.com/dpf-10/p/7899237.html查看实际调用 s ...
- 【angular5项目积累总结】结合adal4实现http拦截器(token)
import { Injectable } from '@angular/core'; import { HttpEvent, HttpInterceptor, HttpHandler, HttpRe ...
- 以ORM的思路来从Excel文件中读取JSON数据列表
1.一个常见的问题就是如何读取excel. 这里面有几个分支的问题,一个是如何使用poi读取excel,网上例子很多,但是这只解决了第一步.如何将excel读取入一定的数据结构这是第二个问题,还有就是 ...
- EF只更新变化的字段
摘要 在使用EF的时候,由于表字段较多,所以在更新的时候,想要只更新变化的字段,有没有办法呢? 解决办法 代码片段 public async Task<int> UpdateAsync(T ...
- JVM 内存初学 (堆(heap)、栈(stack)和方法区(method) )(转载)
想想面试的时候很多会问jvm这方面的问题虽然还是菜鸟不太能用到现在但是还是了解一下, 找资料的时候看见个大佬写的很好转载到这方便以后自己复习和给大佬做宣传 以下为大佬的博客原文: 这两天看了一下深入浅 ...
- 【Java深入研究】3、HashMap源码解析(jdk 1.7)
1. HashMap的数据结构 数据结构中有数组和链表来实现对数据的存储,但这两者基本上是两个极端. 数组 数组存储区间是连续的,占用内存严重,故空间复杂的很大.但数组的二分查找时间复杂度小,为O(1 ...
- 撩课-Web大前端每天5道面试题-Day27
1.浏览器缓存? 浏览器缓存分为强缓存和协商缓存.当客户端请求某个资源时,获取缓存的流程如下: 先根据这个资源的一些 http header 判断它是否命中强缓存, 如果命中,则直接从本地获取缓存资源 ...
- 小希的迷宫(hdu1272)并查集(有点坑)
纪念我死去的脑细胞们 ..... 小希的迷宫 Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java ...
- Three.js开发指南---学习使用几何体(第五章)
一 基础几何体 1 二维图形:二维图形都是基于x和y轴构建的,即展示的形式就是他们都是“直立”的,如果希望这些二维图形躺下,则需要将几何体沿着x轴向后旋转1/4圈 mesh.rotation.x=-M ...