
python爬取千库网
url:https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/
有水印
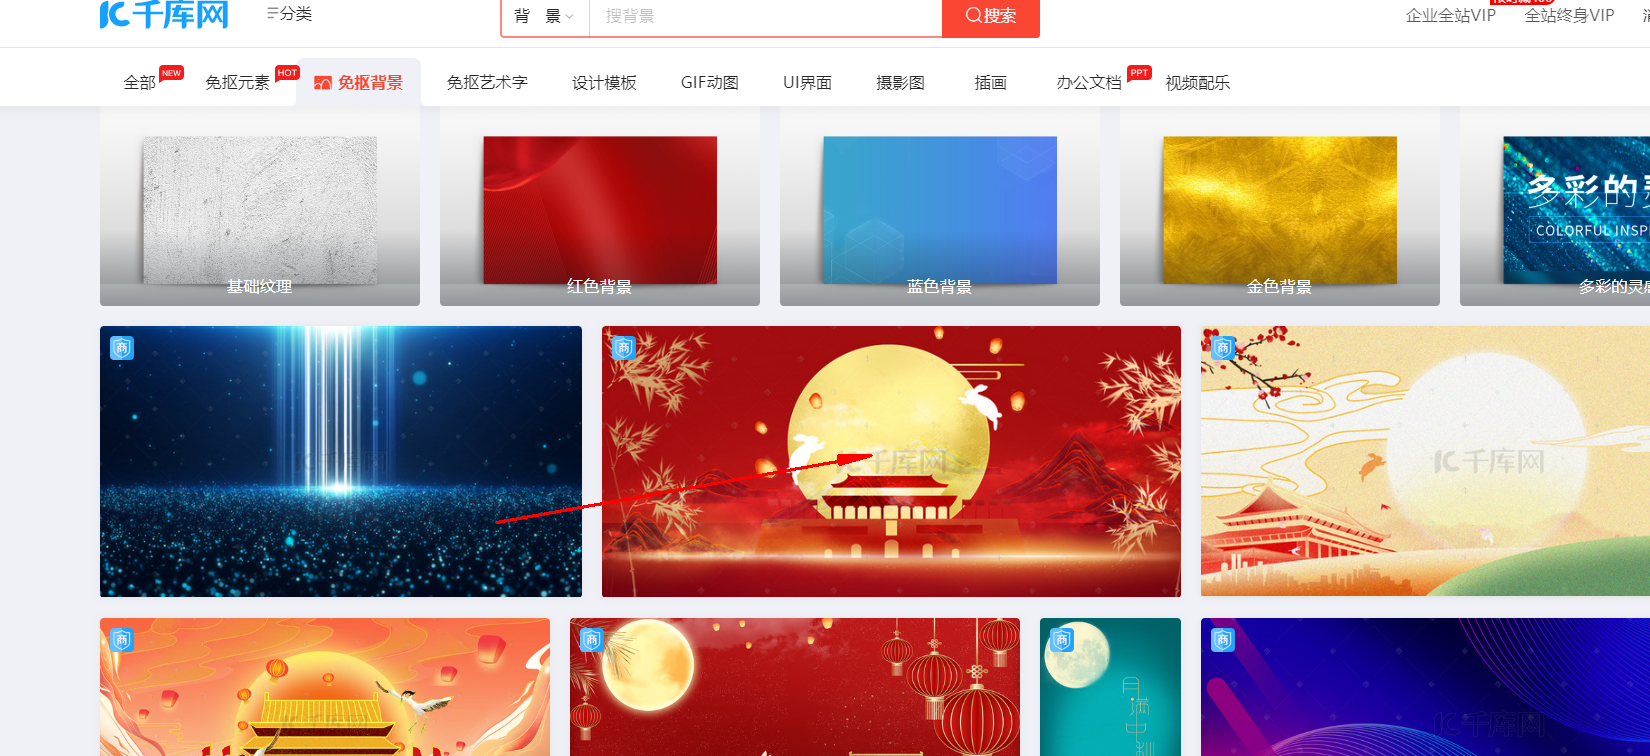
但是点进去就没了
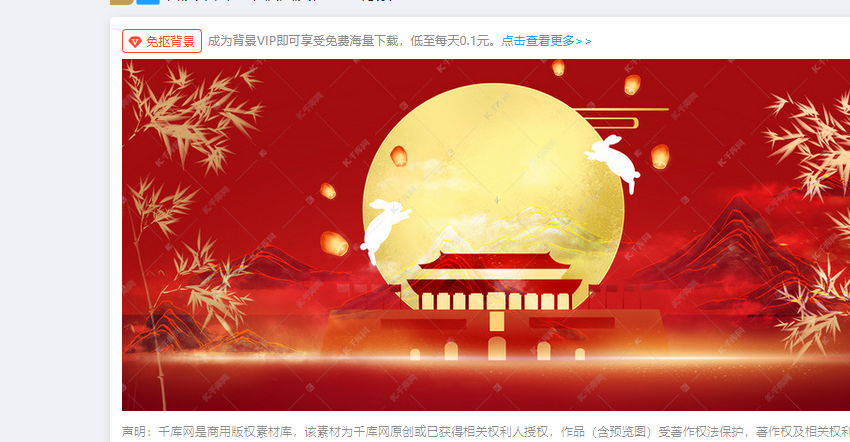
这里先来测试是否有反爬虫
import requests

from bs4 import BeautifulSoup

import os

html = requests.get('https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/')

print(html.text)
输出是404,添加个ua头就可以了
可以看到每个图片都在一个div class里面,比如fl marony-item bglist_5993476,是3个class但是最后一个编号不同就不取
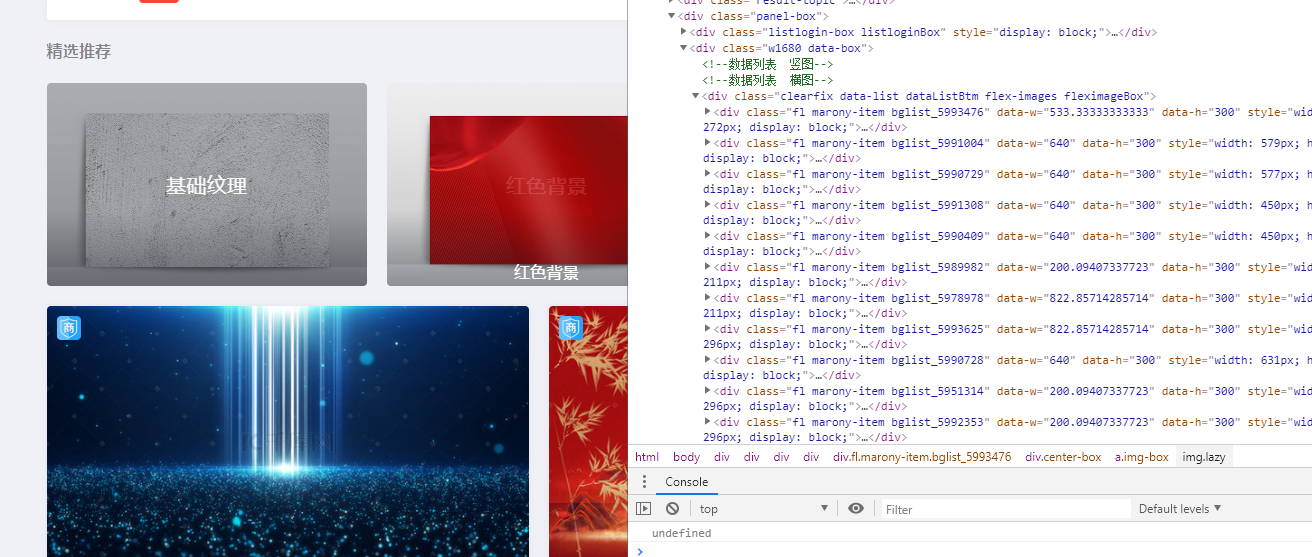
我们就可以获取里面的url
import requests

from bs4 import BeautifulSoup

import os

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

html = requests.get('https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/',headers=headers)

soup = BeautifulSoup(html.text,'lxml')

Urlimags = soup.select('div.fl.marony-item div a')

for Urlimag in Urlimags:

    print(Urlimag['href'])
输出结果为
//i588ku.com/ycbeijing/5993476.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5991004.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5990729.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5991308.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5990409.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5989982.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5978978.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5993625.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5990728.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5951314.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5992353.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5993626.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5992302.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5820069.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5804406.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5960482.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5881533.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5986104.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5956726.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5986063.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5978787.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5954475.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5959200.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5973667.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5850381.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5898111.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5924657.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5975496.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5928655.html

//i588ku.com/comnew/vip/

//i588ku.com/ycbeijing/5963925.html

//i588ku.com/comnew/vip/
这个/vip是广告,过滤一下
for Urlimag in Urlimags:

    if 'vip' in Urlimag['href']:

        continue

    print('http:'+Urlimag['href'])
然后用os写入本地
import requests

from bs4 import BeautifulSoup

import os

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

html = requests.get('https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/',headers=headers)

soup = BeautifulSoup(html.text,'lxml')

Urlimags = soup.select('div.fl.marony-item div a')

for Urlimag in Urlimags:

    if 'vip' in Urlimag['href']:

        continue

    # print('http:'+Urlimag['href'])

    imgurl = requests.get('http:'+Urlimag['href'],headers=headers)

    imgsoup = BeautifulSoup(imgurl.text,'lxml')

    imgdatas = imgsoup.select_one('.img-box img')

    title = imgdatas['alt']

    print('无水印:','https:'+imgdatas['src'])

    if not os.path.exists('千图网图片'):

        os.mkdir('千图网图片')

    with open('千图网图片/{}.jpg'.format(title),'wb')as f:

        f.write(requests.get('https:'+imgdatas['src'],headers=headers).content)
然后我们要下载多页,先看看url规则
第一页:https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/
第二页:https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-2/
import requests

from bs4 import BeautifulSoup

import os

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

}

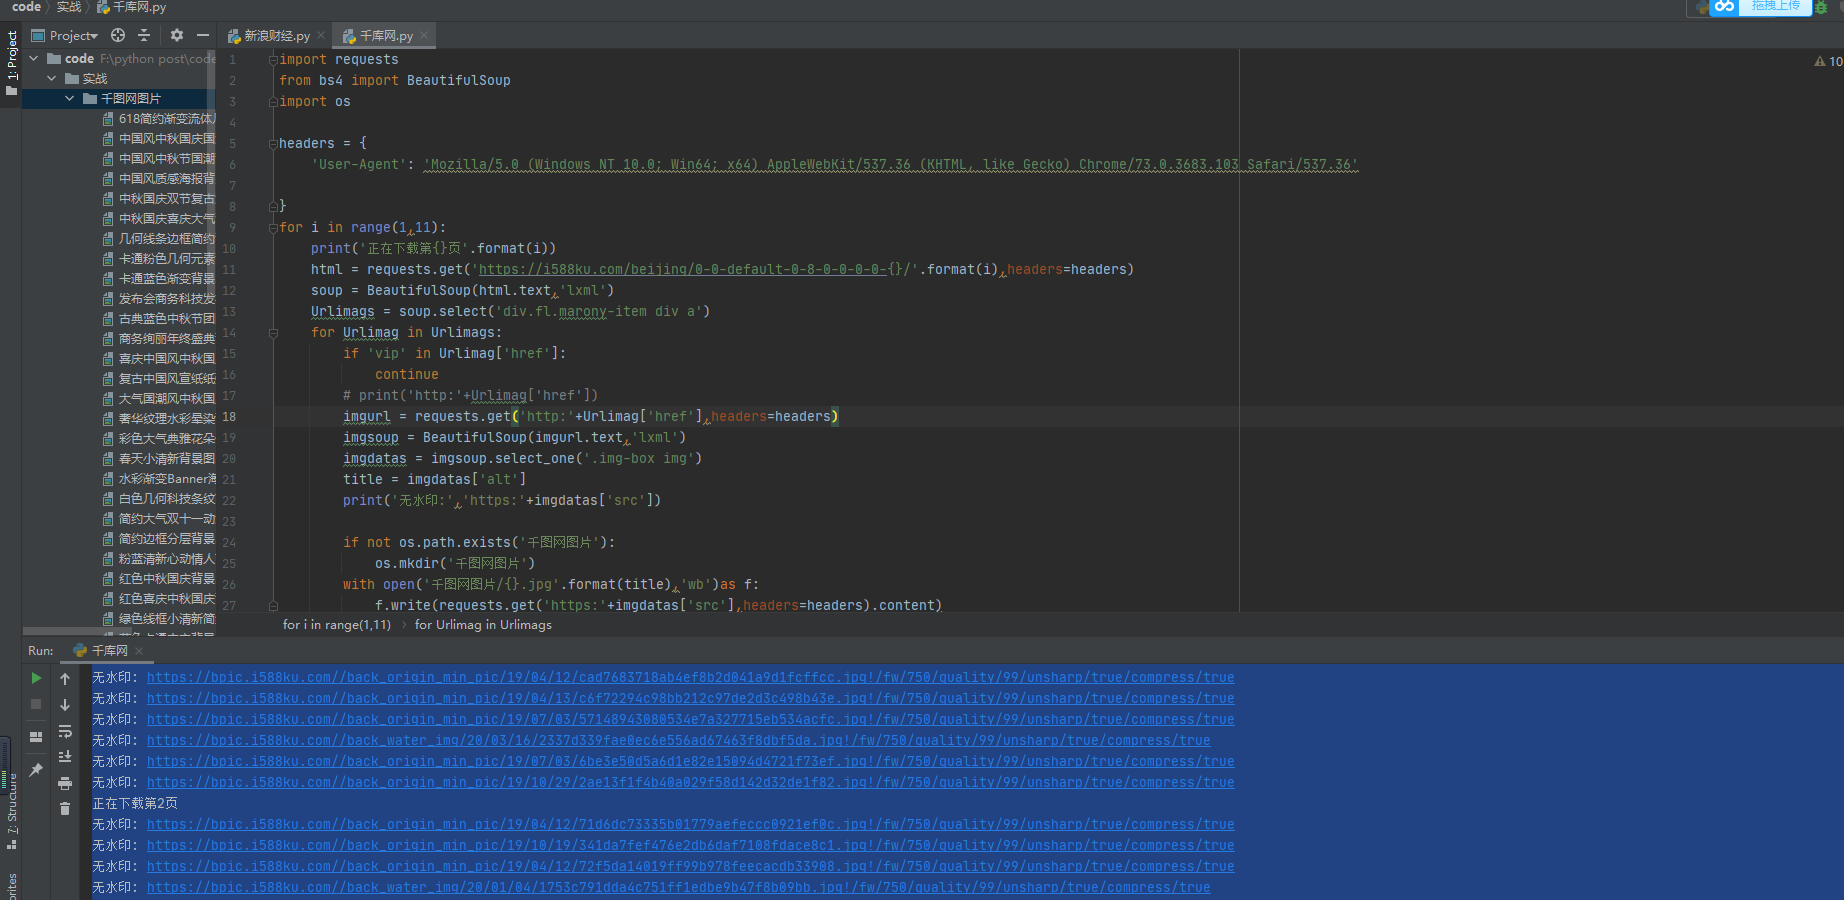
for i in range(1,11):

    print('正在下载第{}页'.format(i))

    html = requests.get('https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-{}/'.format(i),headers=headers)

    soup = BeautifulSoup(html.text,'lxml')

    Urlimags = soup.select('div.fl.marony-item div a')

    for Urlimag in Urlimags:

        if 'vip' in Urlimag['href']:

            continue

        # print('http:'+Urlimag['href'])

        imgurl = requests.get('http:'+Urlimag['href'],headers=headers)

        imgsoup = BeautifulSoup(imgurl.text,'lxml')

        imgdatas = imgsoup.select_one('.img-box img')

        title = imgdatas['alt']

        print('无水印:','https:'+imgdatas['src'])

        if not os.path.exists('千图网图片'):

            os.mkdir('千图网图片')

        with open('千图网图片/{}.jpg'.format(title),'wb')as f:

            f.write(requests.get('https:'+imgdatas['src'],headers=headers).content)
python爬取千库网的更多相关文章
- Python爬取中国天气网
Python爬取中国天气网 基于requests库制作的爬虫. 使用方法:打开终端输入 “python3 weather.py 北京(或你所在的城市)" 程序正常运行需要在同文件夹下加入一个 ...
- python爬取天气后报网
前言 大二下学期的大数据技术导论课上由于需要获取数据进行分析,我决定学习python爬虫来获取数据.由于对于数据需求量相对较大,我最终选择爬取 天气后报网,该网站可以查询到全国各地多年的数据,而且相对 ...
- (python爬取小故事网并写入mysql)
前言: 这是一篇来自整理EVERNOTE的笔记所产生的小博客,实现功能主要为用广度优先算法爬取小故事网,爬满100个链接并写入mysql,虽然CS作为双学位已经修习了三年多了,但不仅理论知识一般,动手 ...
- Python爬取中国票房网所有电影片名和演员名字,爬取齐鲁网大陆所有电视剧名称
爬取CBO中国票房网所有电影片名和演员名字 # -*- coding: utf-8 -*- # 爬取CBO中国票房网所有电影片名 import json import requests import ...
- python爬取斗图网中的 “最新套图”和“最新表情”
1.分析斗图网 斗图网地址:http://www.doutula.com 网站的顶部有这两个部分: 先分析“最新套图” 发现地址栏变成了这个链接,我们在点击第二页 可见,每一页的地址栏只有后面的pag ...
- 适合初学者的Python爬取链家网教程
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: TinaLY PS:如有需要Python学习资料的小伙伴可以加点击下 ...
- Python 爬取煎蛋网妹子图片
#!/usr/bin/env python # -*- coding: utf-8 -*- # @Date : 2017-08-24 10:17:28 # @Author : EnderZhou (z ...
- python爬取中国知网部分论文信息
爬取指定主题的论文,并以相关度排序. #!/usr/bin/python3 # -*- coding: utf-8 -*- import requests import linecache impor ...
- Python爬取17吉他网吉他谱
最近学习吉他,一张一张保存吉他谱太麻烦,写个小程序下载吉他谱. 安装 BeautifulSoup,BeautifulSoup是一个解析HTML的库.pip install BeautifulSoup4 ...
随机推荐
- Asp.net Core 3.1 引用ORM工具包 yrjw.ORM.Chimp(EF + dapper + Autofac)使用教程
yrjw.ORM.Chimp 介绍 It is not the encapsulation of ORM,a based on EF + dapper + Autofac, is repository ...
- JavaScript学习系列博客_34_JavaScript RegExp对象
RegExp 对象 RegExp 对象表示正则表达式,它是对字符串执行模式匹配的强大工具. 创建 RegExp 对象的语法(构造函数方式): pattern:正则表达式,attributes:匹配模式 ...
- Kafka Producer源码解析一:整体架构
一.Producer整体架构 Kafka Producer端的架构整体也是一个生产者-消费者模式 Producer线程调用send时,只是将数据序列化后放入对应TopicPartition的Deque ...
- sql 游标(理论)
游标是处理结果集的一种机制 --声明游标 --ISO 语法 DECLARE cursor_name [ INSENSITIVE ] [ SCROLL ] CURSOR FOR select_state ...
- jmeter参数化之 【CSV Data Set Config/CSV数据配置文件】
这里以登录功能为例: 1.新建.txt文件,将参数值写入到txt文件中(多个参数值如:用户名,密码 之间以逗号隔开),将文件放置在想要放置的目录下 2.添加csv数据文件设置 右键线程组->添加 ...
- 【转】Echarts 数据绑定
Echarts 数据绑定 简单的统计表已经可以生成,不过之前图标数据都是直接写在参数里面的,而实际使用中,我们的数据一般都是异步读取的.EChart.js对于数据异步读取这块提供了异步加载的方法. 绑 ...
- 分享一个登录页面(前端框架layui)-20200318
效果图 对该页面的总结: 1.前端框架layui layui官网:https://www.layui.com/,下载之后,简单配置就可使用 2.layui模块引用与使用的方式 <script&g ...
- idea创建mybatis的逆向工程:generator
1在工程的目录下配置mybatis-generator插件 <build> <plugins> <!-- mybatis逆向工程 --> <plugin> ...
- Java拷贝——深拷贝与浅拷贝
深拷贝和浅拷贝 值类型 vs 引用类型 在Java中,像数组.类Class.枚举Enum.Integer包装类等等,就是典型的引用类型,所以操作时一般来说采用的也是引用传递的方式: 但是Java的语言 ...
- Git在windows上的设置详解
这几天在学习使用Git版本管理工具,发现期间的各种配置还是挺繁琐的,而且好多命令的确记不住,于是写个blog记录下来,方便以后查阅. 1. 首先到GitHub官网上下载最新的Git,然后装上,装的过程 ...