
Python爬虫系统化学习(2)
Python爬虫系统学习(2)
动态网页爬取
当网页使用Javascript时候,很多内容不会出现在HTML源代码中,所以爬取静态页面的技术可能无法使用。因此我们需要用动态网页抓取的两种技术:通过浏览器审查元素解析网页的真实地址和使用Selenium模拟浏览器的方法。
异步更新技术AJAX(Asynchronous Javascript And XML,异步Javascript 和XML):通过后台与服务器进行少量的数据交互实现异步更新。
Selenium模块
百度解释:Selenium [1] 是一个用于Web应用程序测试的工具。Selenium测试直接运行在浏览器中,就像真正的用户在操作一样。支持的浏览器包括IE(7, 8, 9, 10, 11),Mozilla Firefox,Safari,Google Chrome,Opera,Edge等。
通俗来说就是Selenium可以模拟浏览器去执行一些操作,虽然操作会慢,但是可以用来爬取动态页面,相较于request有更大的优点。
request与selenium访问页面的比较(防止混淆)
#request访问

#!/usr/bin/python

#coding:utf-8

link="http://www.bilibili.com"

r=requestss.get(link)

print(r.text)

#selenium访问

#!/usr/bin/python

#coding:utf-8

from selenium import webdriver

from selenium.webdriver.common.keys import Keys

driver=webdriver.Firefox(executable_path=r'D:\geckodriver.exe')

#这里的geckodriver.exe是驱动程序,最新版的selenium不添加是不会执行的

link="http://www.bilibili.com"

dirver.get(link)
可以看到除了使用的库不一样,selenium还需要额外使用驱动程序,下载地址如下:
下载地址:https://github.com/mozilla/geckodriver/releases
Selenium的有点在于,它可以根据元素进行具体的选择,整理如下:
| 方法 | 作用 | 样例 |
|---|---|---|
| find_element_by_css_selector | 通过class选择 | 比如<div class='bdy-as'>test<div>可以用driver.find_element_by_css_seletor('div.bdy-as') |
| find_element_by_xpath | 通过xpath选择 | 比如<form id="loginForm">可以用driver.find_element_by_xpath("//form[@id='loginForm']") |
| find_element_by_id | 通过id进行选择 | 比如<div id="bdy-as">textL</div>可以使用driver.find_element_by_id('bdy-as') |
| find_element_by_name | 通过元素name选择 | 比如<input name="username" type="text"/> driver.find_element_by_name('username') |
| find_element_by_tag_name | 通过元素的名字进行选择 | 比睿<h1>haha</h1>可使用driver.find_element_by_tag_name('h1') |
selenium高级操作:
根据selenium可以对抓取内容进行限制,使用的是FirefoxProfile()这个函数去创建句柄
from selenium import webdriver

fp = webdriver.FirefoxProfile()

#禁止层叠样式表CSS

fp.set_preference("permissions.default.stylesheet",2)

#禁止图片加载

fp.set_preference("permissions.default.image",2)

#禁止JS的运行

fp.set_preference("javascript.enabled",false)
使用三种限制方法可以加速对网页的访问
Selenium实战:爬取猎聘网渗透测试相关信息
由于猎聘网有反爬以及我选择的class存在缺憾,爬取到的只有岗位和薪资,欠缺了公司和地址,但是通过多次被反爬我大概有了反反爬虫的思路。
将爬取猎聘网的代码列下,仅供参考:
#coding:utf-8

import requests

import time

from selenium import webdriver

from selenium.webdriver.common.keys import Keys

driver=webdriver.Firefox(executable_path=r'D:\geckodriver.exe')

link="https://www.liepin.com/zhaopin/?sfrom=click-pc_homepage-centre_searchbox-search_new&d_sfrom=search_fp&key=%E6%B8%97%E9%80%8F%E6%B5%8B%E8%AF%95"

driver.get(link)

#找到文本框,输入渗透测试,输入回车

job_list=driver.find_elements_by_css_selector('div.job-info')

for each in job_list:

    name=each.find_element_by_tag_name('h3').text

    money=each.find_element_by_css_selector('span.text-warning').text

    edu=each.find_element_by_css_selector('span.edu').text

    ALL=name+money+edu+'\n'

    with open ('a.txt',"a+") as f:

        f.write(ALL)
爬取后文件夹下生成a.txt,内容如下: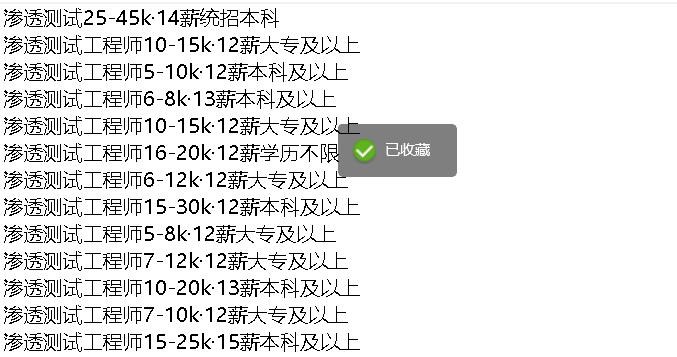
Python爬虫系统化学习(2)的更多相关文章
- Python爬虫系统化学习(4)
Python爬虫系统化学习(4) 在之前的学习过程中,我们学习了如何爬取页面,对页面进行解析并且提取我们需要的数据. 在通过解析得到我们想要的数据后,最重要的步骤就是保存数据. 一般的数据存储方式有两 ...
- Python爬虫系统化学习(5)
Python爬虫系统化学习(5) 多线程爬虫,在之前的网络编程中,我学习过多线程socket进行单服务器对多客户端的连接,通过使用多线程编程,可以大大提升爬虫的效率. Python多线程爬虫主要由三部 ...
- Python爬虫系统化学习(3)
一般来说当我们爬取网页的整个源代码后,是需要对网页进行解析的. 正常的解析方法有三种 ①:正则匹配解析 ②:BeatuifulSoup解析 ③:lxml解析 正则匹配解析: 在之前的学习中,我们学习过 ...
- Python爬虫系统学习(1)
Python爬虫系统化学习(1) 前言:爬虫的学习对生活中很多事情都很有帮助,比如买房的时候爬取房价,爬取影评之类的,学习爬虫也是在提升对Python的掌握,所以我准备用2-3周的晚上时间,提升自己对 ...
- 一个Python爬虫工程师学习养成记
大数据的时代,网络爬虫已经成为了获取数据的一个重要手段. 但要学习好爬虫并没有那么简单.首先知识点和方向实在是太多了,它关系到了计算机网络.编程基础.前端开发.后端开发.App 开发与逆向.网络安全. ...
- python爬虫专栏学习
知乎的一个讲python的专栏,其中爬虫的几篇文章,偏入门解释,快速看了一遍. 入门 爬虫基本原理:用最简单的代码抓取最基础的网页,展现爬虫的最基本思想,让读者知道爬虫其实是一件非常简单的事情. 爬虫 ...
- Python爬虫的学习经历
在准备学习人工智能之前呢,我看了一下大体的学习纲领.发现排在前面的是PYTHON的基础知识和爬虫相关的知识,再者就是相关的数学算法与金融分析.不过想来也是,如果想进行大量的数据运算与分析,宏大的基础数 ...
- python爬虫scrapy学习之篇二
继上篇<python之urllib2简单解析HTML页面>之后学习使用Python比较有名的爬虫scrapy.网上搜到两篇相应的文档,一篇是较早版本的中文文档Scrapy 0.24 文档, ...
- 【Python爬虫案例学习】下载某图片网站的所有图集
前言 其实很简短就是利用爬虫的第三方库Requests与BeautifulSoup. 其实就几行代码,但希望没有开发基础的人也能一下子看明白,所以大神请绕行. 基本环境配置 python 版本:2.7 ...
随机推荐
- Cobaltstrike去除特征
出品|MS08067实验室(www.ms08067.com) 本文作者:BlackCat(Ms08067实验室内网小组成员) 前言: 红蓝对抗的时候,如果未修改CS特征.容易被蓝队溯源. 去特征的几种 ...
- Hive配置Tez引擎踩坑
框架版本 Hadoop 2.7.7 Hive 2.3.7 Tez 0.9.2 保证hadoop集群启动,hive元数据服务启动 上传tez到HDFS tar -zxvf apache-tez-0.9. ...
- Eclipse中配置Junit
在要使用Junit的project名上,点击properties-->Java Build Path-->Libraries,点击Add Library 选择Junit 选择Junit 4 ...
- 2019牛客多校第三场D-Big Integer
题意 定义\(A(n)\) 为 n个1表示的十进制数,例如\(A(3) = 111\) 然后对于\(1 \le i \le n,1\le j \le m\) 问有多少的 \(pairs(i,j)\)满 ...
- HDU - 2825 Wireless Password (AC自动机+状压DP)
题目连接:http://acm.hdu.edu.cn/showproblem.php?pid=2825 题意:给一些字符串,构造出长度为n的字符串,它至少包含k个所给字符串,求能构造出的个数. 题解: ...
- Toxophily HDU - 2298 三分+二分
代码+解析: 1 //题意: 2 //有一个大炮在(0,0)位置,为你可不可以把炮弹射到(x,y)这个位置 3 //题目给你炮弹初始速度,让你求能不能找出来一个炮弹射出时角度满足题意 4 //题解: ...
- Educational Codeforces Round 94 (Rated for Div. 2) A. String Similarity (构造水题)
题意:给你一个长度为\(2*n-1\)的字符串\(s\),让你构造一个长度为\(n\)的字符串,使得构造的字符串中有相同位置的字符等于\(s[1..n],s[2..n+1],...,s[n,2n-1] ...
- Codeforces Round #658 (Div. 2) C1. Prefix Flip (Easy Version) (构造)
题意:给你两个长度为\(n\)的01串\(s\)和\(t\),可以选择\(s\)的前几位,取反然后反转,保证\(s\)总能通过不超过\(3n\)的操作得到\(t\),输出变换总数,和每次变换的位置. ...
- Codeforces Round #515 (Div. 3) B. Heaters (贪心)
题意:有\(n\)个桩子,\(1\)表示该位置有一个火炉,可以使两边距离为\(r\)的范围照亮,问最少使用多少炉子使得所有范围都被照亮. 题解:贪心,首先我们从\(r\)位置开始向左找,如果找到了就记 ...
- 记一次Python调试问题
C#调用python脚本错误: 使用cmd直接运行脚本报错: TabError: inconsistent use of tabs and spaces in indentation 查看日志报错: ...