
hadoop(hbase)副本数修改
一、需求场景
随着业务数据的快速增长,物理磁盘剩余空间告警,需要将数据备份从3份修改为1份,从而快速腾出可用磁盘容量。
二、解决方案
1. 修改hdfs的副本数
Hbase 的数据是存储在 hdfs 上的,Hbase的副本数是默认读取hdfs的配置进行副本备份的,所以需要修改hdfs上的副本数据。
2.删除重复数据
修改hdfs-site.xml的副本数,只能对以后的数据有效,不能修改已经存储的文件备份数,所以需要删除多余的数据。
3.负载均衡
可以增加新的存储节点,并且执行负载均衡策略。将数据均匀的分布到多个数据节点中,最大化的利用数据磁盘。
4.开启hbase表压缩
Hbase数据采用的列式存储,占用空间较大,指定压缩方式可以很好的减少磁盘的占用。
三、操作步骤
1.修改hdfs副本数
a) 通过CDH的web界面修改:

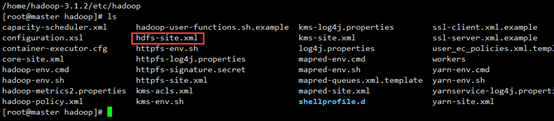
b) 通过hdfs-site.xml修改
2.删除重复数据
该问题网上有很多回答,我这里使用的强制修改备份的方法。
|
//将HDFS上的数据仅保留一份备份 hadoop fs -setrep -R 1 / // HDFS会为每一个用户创建一个回收站目录:/user/用户名/.Trash/,每一个被用户通过Shell删除的文件/目录,在系统回收站中都一个周期,也就是当系统回收站中的文件/目录在一段时间之后没有被用户回复的话,HDFS就会自动的把这个文件/目录彻底删除,之后,用户就永远也找不回这个文件/目录了。如果磁盘占用依旧很大,需要去回收厂手动删除。 |
3.负载均衡
修改存储节点后,使用hdfs用户shell命令执行:hdfs balancer
4.对现有表修改压缩方式
|
disable 'testcompression' //首先将表下线 alter 'testcompression', NAME => 'f1', COMPRESSION => 'SNAPPY' //修改表属性,指定压缩方式为SNAPPY enable 'testcompression' //启用表 desc 'testcompression' //验证是否已启用压缩放肆 major_compact 'testcompression' //执行大合并 |
四、查看结果


hadoop(hbase)副本数修改的更多相关文章
- elastic操作-索引重命名,索引副本数修改
目前我们使用的elastic版本为2.3.5 当前版本没有直接的curl操作可以更改索引的名称,索引的副本数. 有直接更改索引副本数的api. curl -XPUT "192.168.1.1 ...
- 【大数据系列】使用api修改hadoop的副本数和块大小
package com.slp.hdfs; import org.apache.commons.io.output.ByteArrayOutputStream; import org.apache.h ...
- kafka修改topic副本数
工作案例: 大数据开发用系统脚本自动在kafka建topic,检查后才发现副本数只有1个,存在数据丢失的风险.需要立刻把副本数改为3个. 开始干活,首先想到的是下面的命令: ${BIN_PATH}/k ...
- HDFS 修改默认副本数
描述:将HDFS副本数修改为2第一步:将HDFS上已有文件副本数修改为2 hdfs dfs -setrep 2 -R -w / 第二步:修改dfs.replication值为2(页面上操作),然后重启 ...
- hadoop修改MR的提交的代码程序的副本数
hadoop修改MR的提交的代码程序的副本数 Under-Replicated Blocks的数量很多,有7万多个.hadoop fsck -blocks 检查发现有很多replica missing ...
- Hadoop副本数配置
一个文件,上传到hdfs上时指定的是几个副本就是几个.修改了副本数(dfs.replications),对已经上传了的文件也不会起作用.当然可以在上传文件的同时指定创建的副本数hadoop dfs - ...
- kafka关于修改副本数和分区的数的案例实战(也可用作leader节点均衡案例)
kafka关于修改副本数和分区的数的案例实战(也可用作leader节点均衡案例) 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.关于topic分区数的修改 1>.创建1分 ...
- 修改hadoop/hbase/spark的pid文件位置
1.说明 当不修改PID文件位置时,系统默认会把PID文件生成到/tmp目录下,但是/tmp目录在一段时间后会被删除,所以以后当我们停止HADOOP/HBASE/SPARK时,会发现无法停止相应的进程 ...
- 一个大数据方案:基于Nutch+Hadoop+Hbase+ElasticSearch的网络爬虫及搜索引擎
网络爬虫架构在Nutch+Hadoop之上,是一个典型的分布式离线批量处理架构,有非常优异的吞吐量和抓取性能并提供了大量的配置定制选项.由于网络爬虫只负责网络资源的抓取,所以,需要一个分布式搜索引擎, ...
随机推荐
- 深入理解TCP建立和关闭连接
建立连接: 理解:窗口和滑动窗口TCP的流量控制TCP使用窗口机制进行流量控制什么是窗口?连接建立时,各端分配一块缓冲区用来存储接收的数据,并将缓冲区的尺寸发送给另一端 接收方发送的确认信息中包含了自 ...
- 【手把手教你】win10 虚拟机 VMware Workstation Pro 15下安装redhat 8.0
安装redhat8.0 和安装Ubuntu 差别不大 可以参考上篇文章:https://www.cnblogs.com/zero-vic/p/11593683.html 但是redhat 8.1 b ...
- [每日短篇] 1C - Spring Data JPA (0)
2019独角兽企业重金招聘Python工程师标准>>> 准备把 Spring Data JPA 完整看一遍,顺便把关键要点记录一下.在写这篇文章的今天,再不用 Spring Boot ...
- MongoDB学习(三)
MongoDB条件操作符 $gt > 大于 $lt < 小于 $gte >= 大于等于 $lte <= 小于等于 $ne != 不等于 条件操作符可用于查询语句中, ...
- Guzzle 一个PHP的HTTP客户端
Guzzle是一个PHP的HTTP客户端,用来轻而易举地发送请求,并集成到我们的WEB服务上. https://github.com/guzzle/guzzle 接口简单:构建查询语句.POST请求. ...
- iOS9.2.1 App从AppStore上下载闪退问题
首先这是小编的第一篇文章,我是一名做iOS开发的小白,出于爱好会更新发表些相关的技术文章,偶尔也会发些视频.恳请大家不要去嘲笑一个努力的人,要是做的不好请多多评论,反正我也不改. 好了!敲黑板!!说正 ...
- [LOJ2865] P4899 [IOI2018] werewolf 狼人
P4899 [IOI2018] werewolf 狼人 LOJ#2865.「IOI2018」狼人,第一次AC交互题 kruskal 重构树+主席树 其实知道重构树的算法的话,难度就主要在主席树上 习惯 ...
- unittest 中的方法调用时报错 ValueError: no such test method in <class 'mytestcase.MyTestCase'>: runTest
1.调用unittest中的方法时报错: ValueError: no such test method in <class 'mytestcase.MyTestCase'>: runTe ...
- MySQL 中 on与where筛选条件的区别
在两张表连接的时候才会有on的筛选条件,那么on和where的区别是什么呢? 在inner join中是没有区别的,但是在左连接和右连接中,区别就体现出来了,下面以左连接为例: 1.用on的时候,只对 ...
- django源码分析——本地runserver分析
本文环境python3.5.2,django1.10.x系列 1.根据上一篇文章分析了,django-admin startproject与startapp的分析流程后,根据django的官方实例此时 ...