
Zookeeper——基本使用以及应用场景(手写实现分布式锁和rpc框架)
文章目录
Zookeeper的基本使用
在之前的文章主要讲述了Zookeeper的原理,本文则是实践,包含Zookeeper单机环境到集群环境的搭建,基本配置,JavaAPI的使用以及手写实现分布式锁等内容。(PS:在往下进行之前,请务必准备至少3台linux虚拟机搭建集群。)
Zookeeper单机部署
- 首先到官网下载Zookeeper(笔者使用的是3.4.10版本)到linux虚拟机上,然后tar -zxvf解压即可。
- Zookeeper常用的命令如下(在zookeeper/bin目录下执行):
- sh zkServer.sh start:启动服务
- sh zkServer.sh stop:停止服务
- sh zkServer.sh status:查看服务状态
- sh zkServer.sh restart:重启服务
- sh zkCli.sh:连接本地zookeeper服务器
- sh zkCli.sh -timeout 0 -r -server ip:port:远程连接zookeeper服务器,并指定超时时间
- 初次使用zookeeper需要将conf目录下的zoo_sample.cfg复制一份并重命名为zoo.cfg(因为Zookeeper服务器启动时默认会去找该文件名的配置文件),然后编辑该文件配置dataDir和dataLogDir参数。重要配置说明如下(详细参数说明请参照官方文档):
| 参数名 | 说明 |
|---|---|
| dataDir | 该参数无默认值,必须配置,不支持系统属性方式配置。该参数用于配置zookeeper服务器存储快照文件的目录。默认情况下,未配置dataLogDir参数,那么事务日志也会存储在该目录。避免事务日志写性能影响到Zookeeper整体服务能力,建议同时配置dataLogDir参数 |
| dataLogDir | 该参数有默认值,dataDir指定目录,不支持系统属性方式配置。该参数用于配置Zookeeper服务器存储事务日志的目录。由于事务日志的写入对于磁盘性能要求非常高,因此,建议指定单独的磁盘用于存储事务日志。 |
| clientPort | Zookeeper对外服务的端口,默认是2181。可以设置任一端口,集群中也无需保持一致 |
| tickTime | 该参数有默认值2000,单位时ms,可以不配置,不支持系统属性方式配置。该参数用于配置Zookeeper中最小时间单元长度,很多运行时的时间都是使用tickTime的倍数表示的,比如initLimit |
| initLimit | 该参数有默认值10,即10 * tickTime,必须配置且为正整数,不支持系统属性方式配置。该参数表示Follower服务器启动与Leader服务器建立连接并同步数据的时间限制,一般情况下使用默认值即可,但随着数据量增大,需要考虑是否要增大该参数。 |
| syncLimit | 该参数有默认值5,即5 * tickTime,必须配置且为正整数,不支持系统属性方式配置。该参与表示Leader服务器和Follower服务器心跳检测的最大间隔时间,在集群运行时,若在该时间内Leader服务器无法获取到Follower服务器的心跳,则认为Follower断开连接。一般情况下使用默认值即可,当网络质量较差时,可考虑增大该参数。 |
- 启动服务器,使用客户端连接。客户端常用命令如下(中括号代表非必须参数):
- create [-s] [-e] path data [acl]:创建节点,-s指定该节点为有序节点,-e指定该节点为临时节点,path是节点key,data是节点对应的数据,acl是权限信息,默认情况不做任何权限控制
- ls path [watch]:查看指定节点的子节点列表,watch监听器
- get path [watch]:获取指定节点的数据内容和属性信息,watch监听器。节点属性内容说明:
- czxid:createdZXID,表示该数据节点被创建时的事务id
- ctime:createdTime,表示该节点被创建时的时间
- mzxid:modifiedZXID,表示该节点最后一次被修改时的事务id
- mtime:modifiedTime,表示该节点最后一次的修改时间
- version:节点的版本号
- cversion:子节点的版本号
- aversion:节点的ACL版本号
- ephemeralOwner:创建该临时节点时的sessionID,如果该节点是持久节点,该值为0
- dataLength:数据内容的长度
- numChildren:子节点的个数
- pzxid:表示该节点的子节点列表最后一次变更时的事务ID,只有子节点列表变化该值才会变化,子节点的数据变化不会影响该值
- set path data [version]:更新节点的数据内容,version指定版本号,若版本号不匹配则会更新失败
- delete path [version]:删除节点,version指定版本号
Zookeeper集群搭建
搭建集群时首先需要在每台机器下配置两个文件:
- 第一个是在dataDir指定的目录下创建一个myid,文件中指定一个服务器的id
- 第二个是zoo.cfg,对于该文件,集群中每台机器的配置应该都是一样的:
server.1=192.168.0.106:2000:3000

server.2=192.168.0.108:2000:3000

server.3=192.168.0.109:2000:3000

# 1. server.1中的“1”就是myid中指定的服务器id,服务器id要和后面的ip对应;

# 2. 第一个端口是Follower服务器和Leader服务器通信同步数据时的端口

# 3. 第二个端口是竞选Leader时投票用的端口
这样,集群环境就配置好了,只需要启动三个Zookeeper服务就行了(PS:可以逐个启动,并用sh zkServer.sh status和sh zkCli.sh命令看看会输出什么)。
JavaAPI的使用
Zookeeper为多种语言提供了API方便调用,在Java中可以使用原生的API和开源的客户端(zkClient、curator)进行开发,这里就不再演示这些基础的代码了,需要的请移步至github仓库
Zookeeper的应用场景
Zookeeper有很多的应用场景:数据的发布/订阅、负载均衡、分布式协调/通知、集群管理、分布式锁等等。下面主要讨论如何实现分布式锁以及基于Zookeeper实现一个简易版本的RPC服务注册中心。
分布式锁的实现
在单机架构中,实现线程同步只需要通过synchronized关键字和Lock类就能实现,但是在分布式中要如何实现呢?
有三种方式可以实现,分别是数据库、redis和zookeeper。而锁的种类有很多,包含了独享锁/共享锁、可/不可重入锁、公平/非公平锁等等。这里仅通过Zookeeper分析独享锁和可重入锁的实现方式。
独享锁
什么是独享锁?简单的说就是资源在同一时间只能被一个线程占用。通过前面的学习,我们不难想到,利用多个线程在Zookeeper中创建同一个节点只会有一个线程能创建成功的特性很容易就能实现一个独享锁。
即获取锁时,当前线程判断锁是否已被其它机器获取,若没有,则在/locks节点下创建临时节点/lock,创建成功则获取到锁,未创建成功或者锁已经被其它机器占用则监听/locks下子节点的变化等待获取锁;锁被释放后,删除掉/lock节点,其它机器接收到Watcher通知又开始重新竞争锁。这样就实现了一个简单的独享锁,但是为什么要创建临时节点呢?这样可以避免获取到锁的机器还未释放锁就突然挂掉而产生死锁。流程图如下:

除了上述方式还有没有其它方式可以实现呢?
我们还可以基于有序节点来实现:当多台机器竞争锁时,都去/locks下创建临时有序节点,这样所有机器都会创建成功,那我们如何确定哪一个机器获取到锁呢?我们可以获取子节点列表,从中选出序号最小或最大的节点对应的机器获取到锁(一般是最小),而其它未获取到锁的机器则监听/locks子节点的变化等待获取锁,一旦锁释放或异常中断退出则删除对应的节点,其它机器接收到Watcher通知后,重新获取子节点列表,重复获取锁的过程即可。

上面两种分布式锁的实现基本上能满足一般的业务需求,但它们都存在一个问题:羊群效应。当竞争锁的服务器数量非常多时,一旦上一个锁被释放,所有等待锁的服务器都会收到通知,但最终只会有一台服务器获取到锁,其它服务器继续等待,这就是羊群效应,很耗费性能。
怎么改进呢?我们注意到在上面的例子中锁一旦释放就会通知所有等待锁的服务器,那我们是不是可以让其只通知其中某一台服务器呢?比如说在第二个例子中让每一个服务器只监听前一个节点的变化,因为是有序节点,所以这是很容易做到的。这样,当前锁被释放,就只会通知后一个节点所对应的服务器。代码请移步GitHub仓库。
可重入锁
可重入锁是指当前获取到锁的线程可以再次获取到该锁。那基于上面的实现,我们只需要在当前服务器获取到锁时,绑定一个计数器,每当该服务器在持有锁期间再次获取锁时,无需阻塞等待,直接将计数器递增加1即可,释放锁则是对该计数器递减减1;而其它线程要获取到锁,则要等待该计数器为0才行。具体实现可参照curator-recipes中locks包下的InterProcessMutex类。
实现RPC框架
基本概念及原理
Zookeeper最重要的一个功能就是服务注册管理,Dubbo就依赖于此。那什么是服务注册管理呢?又为什么需要这个东西呢?如何实现呢?
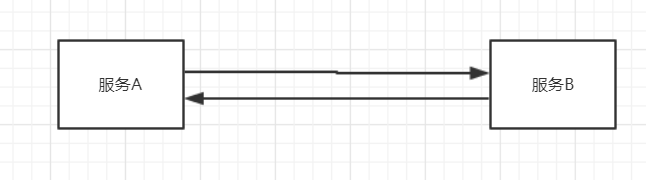
在分布式集群中,会拆分出很多的服务模块,部署在不同的机器上,当服务间彼此有依赖关系,就可以通过RPC调用其它服务的接口。若只是像上面这样,只有两台服务器,没有什么问题。但分布式应用通常是非常复杂的,拆分了非常多的服务,其中某些服务还会搭建集群,它们相互依赖就会跟下面这张图一样:

相信你也发现其中的问题了,当系统比较庞大时,服务间调用不再是点对点的关系,靠我们自己已经很难人工维护服务器的地址和调用关系了,所以就需要一个服务注册中心来统一管理服务。

像上面这样,所有的服务首先都会去服务中心发布自己的服务(服务名、服务地址等),客户端调用服务时,只需要通过服务名称去注册中心找到对应的服务并调用。
在了解了服务注册中心的基本概念后,不难发现Zookeeper就很容易实现一个注册中心。因为Zookeeper是以树形结构存储数据,那发布服务时只需要根据服务名称创建一个节点,并将服务地址作为该节点的子节点存入到Zookeeper就行:

客户端通过服务名称去获取其子节点,即服务地址,若该服务搭建了集群,则会有多个,那么客户端也可以据此实现负载均衡。说了这么多,下面就来看看一个简单的RPC框架实现。
代码实现
我这里是通过curator-4.0.0客户端来连接Zookeeper的,所以需要引入curator-framework依赖,然后实现一个获取连接的工具类:
public class ZkConnectUtils {

    private static CuratorFramework curator;

    public static CuratorFramework getConnector() {

        curator = CuratorFrameworkFactory.builder()

                .connectString(ZkConfig.CONNECT_STR)

                .retryPolicy(new ExponentialBackoffRetry(1000, 3))

                .namespace(ZkConfig.NAMESPACE)

                .sessionTimeoutMs(5000).build();

        curator.start();

        return curator;

    }

}
服务端
我们先实现服务端,首先需要实现服务的注册:
public interface IRpcRegistryCenter {

    void register(String serviceName, String address, Integer port) throws Exception;

}

public class RpcRegistryCenterImpl implements IRpcRegistryCenter {

    private static final String SEPARATOR = "/";

    /**

     * 服务注册,将服务的地址以临时节点的方式注册到zookeeper中,

     * 这样断开连接即销毁服务,而有新服务加入时,客户端通过监听器动态发现

     * 服务变化

     *

     * @param serviceName 服务名称

     * @param address     服务地址

     * @param port        服务端口

     * @return void

     * @date 2019-07-18

     */

    @Override

    public void register(String serviceName, String address, Integer port) throws Exception {

        String serviceAddress = address + ":" + port;

        String serviceNode = SEPARATOR + serviceName;

        CuratorFramework connector = ZkConnectUtils.getConnector();

        // 判断该服务节点是否已经创建,服务名称最好不要以临时节点的方式创建,否则一旦该连接断开,整个集群都将不可用。

        if (connector.checkExists().forPath(serviceNode) == null) {

            connector.create().creatingParentsIfNeeded()

                    .withMode(CreateMode.PERSISTENT)

                    .forPath(serviceNode, "0".getBytes());

        }

        // 创建临时的地址节点

        String addressNode = serviceNode + SEPARATOR + serviceAddress;

        connector.create().withMode(CreateMode.EPHEMERAL).forPath(addressNode, "0".getBytes());

        System.out.println("服务注册成功!");

    }

}
注册服务很简单,就是去Zookeeper创建相应的节点。接着实现发布服务的接口:
public class RpcServer {

    private static final ExecutorService SERVICE_POOL = Executors.newCachedThreadPool();

    private IRpcRegistryCenter registryCenter; // 注册中心

    private String address; // 服务地址

    private Integer port; // 服务端口

    public RpcServer(IRpcRegistryCenter registryCenter, String address, Integer port) {

        this.registryCenter = registryCenter;

        this.address = address;

        this.port = port;

    }

    /**

     * 发布服务

     *

     * @date 2019-07-16

     */

    public void publish() throws Exception {

        // 将服务注册到zookeeper中

        Set<String> serviceNames = ServiceRepository.getServiceNames();

        for (String serviceName : serviceNames) {

            registryCenter.register(serviceName, this.address, this.port);

            System.out.println("成功发布服务:" + serviceName + " -> " + this.address + ":" + this.port);

        }

        ServerSocket serverSocket = new ServerSocket(port);

        while (true) {

            // 监听服务并交由线程池处理

            Socket socket = serverSocket.accept();

            SERVICE_POOL.execute(new ProcessHandler(socket));

        }

    }

}

public class ServiceRepository {

    /**

     * 存储服务名称和服务对象的关系

     */

    private static final Map<String, Object> SERVICE_CACHE = new HashMap<>();

    /**

     * 绑定服务名称和服务对象

     *

     * @param service 服务对象

     * @date 2019-07-18

     *

     */

    public static void bind(Object service) {

        String serviceName = service.getClass().getAnnotation(Service.class).value().getName();

        SERVICE_CACHE.put(serviceName, service);

    }

    /**

     * 获取已发布的服务名称

     *

     * @return java.util.Set<java.lang.String>

     * @date 2019-07-18

     *

     */

    public static Set<String> getServiceNames() {

        return SERVICE_CACHE.keySet();

    }

    /**

     * 根据服务名称获取到服务对象

     *

     * @param serviceName

     * @return java.lang.Object

     * @date 2019-07-19

     *

     */

    public static Object getService(String serviceName) {

        return SERVICE_CACHE.get(serviceName);

    }

}
ServiceRepository类是服务端本地服务名称和具体服务对象的映射存储仓库,在发布服务之前,具体的服务对象需要通过bind方法绑定自己的服务名称和服务对象的映射关系,然后调用publish方法将这里的服务名称都注册到Zookeeper中去;当客户端调用时,服务端就能通过服务名称找到具体的服务对象(还可以通过动态代理等方法实现该功能)。
服务注册完成后,就需要监听等待客户端的调用,这里是通过Socket实现的,并通过线程池异步处理客户端的消息。怎么处理呢?也就是反序列化客户端消息并调用相关服务的一个过程,因此,我们需要一个统一的传输对象。因为是远程调用服务,所以该对象应该包含服务的类的全名称、方法名称和方法参数这些字段,并实现Serializable接口:
public class RpcEntity implements Serializable {

    private static final long serialVersionUID = -8789719821222021770L;

    private String className; // 全类名

    private String methodName; // 调用方法名

    private Object[] args; // 方法的参数值

    public RpcEntity(String className, String methodName, Object[] args) {

        this.className = className;

        this.methodName = methodName;

        this.args = args;

    }

    public String getClassName() {

        return className;

    }

    public void setClassName(String className) {

        this.className = className;

    }

    public String getMethodName() {

        return methodName;

    }

    public void setMethodName(String methodName) {

        this.methodName = methodName;

    }

    public Object[] getArgs() {

        return args;

    }

    public void setArgs(Object[] args) {

        this.args = args;

    }

}
服务端接收到消息后则交由ProcessHandler类处理(确保类的单一职责),该类实现了Runnable接口,交由线程池异步处理:
public class ProcessHandler implements Runnable {

    private Socket socket;

    public ProcessHandler(Socket socket) {

        this.socket = socket;

    }

    @Override

    public void run() {

        try (ObjectInputStream ois = new ObjectInputStream(socket.getInputStream());

             ObjectOutputStream oos = new ObjectOutputStream(socket.getOutputStream())) {

            // 反序列化客户端传过来的对象,并通过反射调用服务端对象的方法

            RpcEntity entity = (RpcEntity) ois.readObject();

            Object result = invokeService(entity);

            // 将结果返回给客户端

            oos.writeObject(result);

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

    private Object invokeService(RpcEntity entity) throws Exception {

        // 通过参数类型和参数名称拿到Method,再反射调用方法

        Object[] args = entity.getArgs();

        Class[] params = new Class[args.length];

        for (int i = 0; i < params.length; i++) {

            params[i] = args[i].getClass();

        }

        // 根据客户端传入的服务名调用相应的服务对象的方法

        String serviceName = entity.getClassName();

        Object service = ServiceRepository.getService(serviceName);

        Method method = service.getClass().getMethod(entity.getMethodName(), params);

        return method.invoke(service, args);

    }

}
这样,服务端功能就实现完了,客户端该如何实现?可以自己先思考一下。
客户端
服务端有一个注册服务中心,将服务注册到Zookeeper;所以,客户端就需要有个发现服务中心从Zookeeper获取到服务:
public interface IRpcDiscovery {

    String discover(String serviceName) throws Exception;

}

public class RpcDiscoveryImpl implements IRpcDiscovery {

    private static final String SEPARATOR = "/";

    private CuratorFramework curator;

    private ILB lb; // 负载均衡器

    private List<String> serviceAddresses; // 服务地址

    public RpcDiscoveryImpl() {

        this(null);

    }

    public RpcDiscoveryImpl(ILB lb) {

        this.lb = lb;

        this.curator = ZkConnectUtils.getConnector();

    }

    /**

     * 发现服务

     *

     * @param serviceName

     * @return java.lang.String

     * @date 2019-07-19

     *

     */

    @Override

    public String discover(String serviceName) throws Exception {

        String node = SEPARATOR + serviceName;

        serviceAddresses = curator.getChildren().forPath(node);

        if (serviceAddresses == null || serviceAddresses.size() == 0) {

            throw new RuntimeException("未发现服务,无法进行远程调用!");

        }

        // 添加监听器,动态发现节点的变化

        addWatcher(node);

        // 可由外部配置负载均衡器,若未配置,则默认使用随机负载均衡器

        if (lb == null) {

            lb = new RandomLB();

        }

        return lb.selectHost(serviceAddresses);

    }

    private void addWatcher(String node) throws Exception {

        PathChildrenCache childrenCache = new PathChildrenCache(curator, node, true);

        PathChildrenCacheListener listener = new PathChildrenCacheListener() {

            @Override

            public void childEvent(CuratorFramework client, PathChildrenCacheEvent event) throws Exception {

                serviceAddresses = curator.getChildren().forPath(node);

            }

        };

        childrenCache.getListenable().addListener(listener);

        childrenCache.start();

    }

}
通过服务名称获取到所有的子节点,即服务地址并监听子节点的变化,这样集群中上线服务或者下线服务,客户端立刻就能感知到。拿到服务地址后,若是集群,则可以考虑在此实现负载均衡:
public interface ILB {

    String selectHost(List<String> hosts);

}

public abstract class AbstractLB implements ILB {

    /**

     * 负载均衡,采用模板模式的思想提高扩展性,该方法只是抽离出公共的代码,

     * 具体的算法由doSelect方法实现

     *

     * @param hosts

     * @return java.lang.String

     * @date 2019-07-19

     *

     */

    @Override

    public String selectHost(List<String> hosts) {

        if (hosts == null || hosts.size() == 0) {

            return null;

        }

        if (hosts.size() == 1) {

            return hosts.get(0);

        }

        // 节点中都包含分隔符,统一处理后返回

        String node = doSelect(hosts);

        return node.replace("/", "");

    }

    /**

     * 抽象的负载算法,根据需求扩展

     *

     * @param hosts

     * @return java.lang.String

     * @date 2019-07-19

     *

     */

    protected abstract String doSelect(List<String> hosts);

}

public class PollingLB extends AbstractLB {

    private static int count = 0; // 轮询计数器

    @Override

    protected String doSelect(List<String> hosts) {

        if (count >= hosts.size()) {

            count = 0;

        }

        return hosts.get(count++);

    }

}

public class RandomLB extends AbstractLB {

    @Override

    protected String doSelect(List<String> hosts) {

        Random random = new Random();

        return hosts.get(random.nextInt(hosts.size()));

    }

}
这里我实现了简单的随机和轮询算法,可以通过模板方法模式让用户自定义负载算法(在Dubbo中就是这么实现的)。
找到服务后,我们该如何去调用呢?需要考虑以下两个方面:
- 假设客户端要调用服务端IHelloService.sayHello方法,那么客户端也需要IHelloService的接口
- 服务端是通过Socket接收消息的,那么客户端肯定需要Sokect传递消息,即序列化传递RpcEntity消息实体类
所以客户端调用IHelloService.sayHello方法时,实际应该是通过Socket发送消息,告诉服务端我要调用的服务。这里通过动态代理来实现(当然客户端也可以直接写一个实现类,但就太不灵活了):
public class RpcClientProxy {

    /**

     * 通过动态代理创建客户端代理对象

     *

     * @param interfaceClass 代理对象需实现的接口

     * @param discovery 发现服务

     * @return T

     * @date 2019-07-16

     *

     */

    public static <T> T newProxy(Class<T> interfaceClass, IRpcDiscovery discovery) {

        return (T) Proxy.newProxyInstance(interfaceClass.getClassLoader(),

                new Class[]{interfaceClass},

                new RemoteHandler(discovery));

    }

}
只需要通过Proxy类创建一个代理类就好了,具体的实现在RemoteHandler类中:
public class RemoteHandler implements InvocationHandler {

    private IRpcDiscovery discovery;

    public RemoteHandler(IRpcDiscovery discovery) {

        this.discovery = discovery;

    }

    @Override

    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {

        String className = method.getDeclaringClass().getName();

        String address = discovery.discover(className);

        String[] arrs = address.split(":");

        RpcEntity rpcEntity = new RpcEntity(className, method.getName(), args);

        SocketTransport transport = new SocketTransport(arrs[0], Integer.parseInt(arrs[1]));

        return transport.sendInfo(rpcEntity);

    }

}

public class SocketTransport {

    private String host;

    private int port;

    public SocketTransport(String host, int port) {

        this.host = host;

        this.port = port;

    }

    /**

     * 发送消息给服务端

     *

     * @param rpcEntity

     * @return java.lang.Object

     * @date 2019-07-16

     */

    public Object sendInfo(RpcEntity rpcEntity) throws Exception {

        Socket socket = null;

        try {

            socket = newSocket();

            ObjectOutputStream oos = new ObjectOutputStream(socket.getOutputStream());

            oos.writeObject(rpcEntity);

            oos.flush();

            ObjectInputStream ois = new ObjectInputStream(socket.getInputStream());

            Object result = ois.readObject();

            ois.close();

            oos.close();

            return result;

        } catch (Exception e) {

            throw new Exception("远程调用出错!");

        } finally {

            if (socket != null) {

                socket.close();

            }

        }

    }

    private Socket newSocket() throws Exception {

        System.out.println("创建连接......");

        Socket socket;

        try {

            socket = new Socket(this.host, this.port);

            return socket;

        } catch (Exception e) {

            throw new Exception("连接建立失败!");

        }

    }

}
通过从Zookeeper拿到的服务地址创建Socket连接,然后将RpcEntity消息类序列化传递即可。
至此,一个简单的RPC框架就实现完成了,最后我们来看看如何使用。首先服务端实现一个服务提供者并发布:
public interface IHelloService {

    String sayHello(String msg);

}

@Service(IHelloService.class)

public class HelloServiceImpl8080 implements IHelloService {

    @Override

    public String sayHello(String msg) {

        return "8080: Hello, " + msg;

    }

}

public class Server8080 {

    public static void main(String[] args) throws Exception {

        // 绑定服务

        IHelloService iHelloService = new HelloServiceImpl8080();

        ServiceRepository.bind(iHelloService);

        // 将服务发布到注册中心

        IRpcRegistryCenter registryCenter = new RpcRegistryCenterImpl();

        RpcServer server = new RpcServer(registryCenter, "127.0.0.1", 8080);

        server.publish();

    }

}
@Service注解只是用于定义发布服务的名称。下面看看客户端如何调用
public class Client {

    public static void main(String[] args) {

        IRpcDiscovery discovery = new RpcDiscoveryImpl(new PollingLB());

        IHelloService iHelloService = RpcClientProxy.newProxy(IHelloService.class, discovery);

        for (int i = 0; i < 10; i++) {

            String result = iHelloService.sayHello("dark");

            System.out.println(result);

        }

    }

}
初始化服务发现中心并配置负载均衡算法,然后通过代理类远程调用。若要看负载均衡的效果,可在服务端模拟集群服务即可,全部代码请移步GitHub。
总结
本篇文章主要讲解了Zookeeper的基本使用、分布式锁和RPC框架的实现原理,但Zookeeper的应用场景非常的丰富,结合平时的实际项目多多思考,才能更加深刻的理解Zookeeper。另外,我们可以看到分布式锁和RPC框架实现原理都依赖于Watcher机制,那Zookeeper是如何实现监听器的呢?下一篇将详细分析Watcher的源码
Zookeeper——基本使用以及应用场景(手写实现分布式锁和rpc框架)的更多相关文章
- 手写数字识别 卷积神经网络 Pytorch框架实现
MNIST 手写数字识别 卷积神经网络 Pytorch框架 谨此纪念刚入门的我在卷积神经网络上面的摸爬滚打 说明 下面代码是使用pytorch来实现的LeNet,可以正常运行测试,自己添加了一些注释, ...
- 手撕redis分布式锁,隔壁张小帅都看懂了!
前言 上一篇老猫和小伙伴们分享了为什么要使用分布式锁以及分布式锁的实现思路原理,目前我们主要采用第三方的组件作为分布式锁的工具.上一篇运用了Mysql中的select ...for update实现了 ...
- 【分布式锁的演化】终章!手撸ZK分布式锁!
前言 这应该是分布式锁演化的最后一个章节了,相信很多小伙伴们看完这个章节之后在应对高并发的情况下,如何保证线程安全心里肯定也会有谱了.在实际的项目中也可以参考一下老猫的github上的例子,当然代码没 ...
- 手写一个类SpringBoot的HTTP框架:几十行代码基于Netty搭建一个 HTTP Server
本文已经收录进 : https://github.com/Snailclimb/netty-practical-tutorial (Netty 从入门到实战:手写 HTTP Server+RPC 框架 ...
- 【spring】-- 手写一个最简单的IOC框架
1.什么是springIOC IOC就是把每一个bean(实体类)与bean(实体了)之间的关系交给第三方容器进行管理. 如果我们手写一个最最简单的IOC,最终效果是怎样呢? xml配置: <b ...
- 浅析MyBatis(二):手写一个自己的MyBatis简单框架
在上一篇文章中,我们由一个快速案例剖析了 MyBatis 的整体架构与整体运行流程,在本篇文章中笔者会根据 MyBatis 的运行流程手写一个自定义 MyBatis 简单框架,在实践中加深对 MyBa ...
- 参考KOA,5步手写一款粗糙的web框架
我经常在网上看到类似于KOA VS express的文章,大家都在讨论哪一个好,哪一个更好.作为小白,我真心看不出他两who更胜一筹.我只知道,我只会跟着官方文档的start做一个DEMO,然后我就会 ...
- 手写一个自己的简单MVC框架myPHP
myPHP框架 采用的是MVC 思想,应用纯面向对象及项目单一入口,实现的一个自定义的框架.(自己兴趣的练习) 一.项目单一入口 入口文件 myphp\index.php前台 一个网站所有的请求都请求 ...
- 曹工说mini-dubbo(1)--为了实践动态代理,我写了个简单的rpc框架
相关背景及资源: 之前本来一直在写spring源码解析这块,如下,aop部分刚好写完.以前零散看过一些文章,知道rpc调用基本就是使用动态代理,比如rmi,dubbo,feign调用等.自己也就想着试 ...
随机推荐
- RAC配置2个私网网卡使用HAIP服务
如果是在oracle 10gRAC, 私网网卡冗余保护只能使用操作系统网卡绑定方式,但是到了oracle 11g,如果担心一个私网网卡故障导致rac节点驱逐,可以使用2个私网网卡,Oracle将自动使 ...
- mysql中的联合查询(内联、左联、外联、右联、全联)
转 https://www.cnblogs.com/withscorpion/p/9454490.html 联合查询效率较高,举例子来说明联合查询:内联inner join .左联left oute ...
- Java集合(十)实现Map接口的HashMap
Java集合(十)继承Map接口的HashMap 一.HashMap简介(基于JDK1.8) HashMap是基于哈希表(散列表),实现Map接口的双列集合,数据结构是“链表散列”,也就是数组+链表 ...
- 用java方式实现快速排序
一.基本思想 快速排序采用分治的策略,具体如下:选择一个关键值作为基准值,找到一个元素小于比基准值小的都在左边序列(一般是无序的),比基准值大的都在右边(一般是无序的).一般选用序列第一个元素作为基准 ...
- 如何基于 echarts 在柱状图或条形图上实现转换率?(有想法吗?)
目录 需求 探索一 探索二 探索三 转换实践思路1 转换实践思路2 其他思路 探索四(揭晓答案) 答案篇说明 backgroundColor 用法 双柱合一 始终在轴的中间 百分在变,但是距离轴的距离 ...
- 前端开发SEO的理解
所谓seo(Search Engine Optimization)即搜索引擎优化.简单说就是百度.谷歌搜索引擎的‘蜘蛛’,如下图: 搜索引擎蜘蛛是通过,连接地址来找到你的网站的,seo就是让你的网站符 ...
- 关于ubuntu下使用l2tpvpn和远程桌面windows系统的测试
一.背景: 2019年9月下旬到10月上旬,到海南澄迈福山度假.随身带的笔记本电脑中windows10系统因硬盘故障挂了,在另一块硬盘上的ubuntu18.04系统正常.因媳妇需要在10月1日远程回公 ...
- Rocket - tilelink - mask
https://mp.weixin.qq.com/s/Gqv09RIgSSg5VKe-wb4aGg 讨论tilelink中使用MaskGen生成mask的用法. 1. tilelink中的ma ...
- Take advantage of Checkra1n to Jailbreak iDevice for App analysis
An unpatchable bootrom exploit called "checkm8" works on all iDevices up until the iPhone ...
- 撸一个简单的vue-router来剖析原理
理解 随着前端业务的发展, 我们一般在写一个较为大型的vue项目时候,会使用到vue-router,来根据指定的url或者hash来进行内容的分发,可以达到不像服务端发送请求,就完成页面内容的切换,能 ...