
【转载】Spark SQL 1.3.0 DataFrame介绍、使用
http://www.aboutyun.com/forum.php?mod=viewthread&tid=12358&page=1
1.DataFrame是什么?
2.如何创建DataFrame?
3.如何将普通RDD转变为DataFrame?
4.如何使用DataFrame?
5.在1.3.0中,提供了哪些完整的数据写入支持API?

DataFrame

- # 从Hive中的users表构造DataFrame
- users = sqlContext.table("users")
- # 加载S3上的JSON文件
- logs = sqlContext.load("s3n://path/to/data.json", "json")
- # 加载HDFS上的Parquet文件
- clicks = sqlContext.load("hdfs://path/to/data.parquet", "parquet")
- # 通过JDBC访问MySQL
- comments = sqlContext.jdbc("jdbc:mysql://localhost/comments", "user")
- # 将普通RDD转变为DataFrame
- rdd = sparkContext.textFile("article.txt") \
- .flatMap(lambda line: line.split()) \
- .map(lambda word: (word, 1)) \
- .reduceByKey(lambda a, b: a + b) \
- wordCounts = sqlContext.createDataFrame(rdd, ["word", "count"])
- # 将本地数据容器转变为DataFrame
- data = [("Alice", 21), ("Bob", 24)]
- people = sqlContext.createDataFrame(data, ["name", "age"])
- # 将Pandas DataFrame转变为Spark DataFrame(Python API特有功能)
- sparkDF = sqlContext.createDataFrame(pandasDF)
- # 创建一个只包含"年轻"用户的DataFrame
- young = users.filter(users.age < 21)
- # 也可以使用Pandas风格的语法
- young = users[users.age < 21]
- # 将所有人的年龄加1
- young.select(young.name, young.age + 1)
- # 统计年轻用户中各性别人数
- young.groupBy("gender").count()
- # 将所有年轻用户与另一个名为logs的DataFrame联接起来
- young.join(logs, logs.userId == users.userId, "left_outer")
- young.registerTempTable("young")
- sqlContext.sql("SELECT count(*) FROM young")
- # 追加至HDFS上的Parquet文件
- young.save(path="hdfs://path/to/data.parquet",
- source="parquet",
- mode="append")
- # 覆写S3上的JSON文件
- young.save(path="s3n://path/to/data.json",
- source="json",
- mode="append")
- # 保存为SQL表
- young.saveAsTable(tableName="young", source="parquet" mode="overwrite")
- # 转换为Pandas DataFrame(Python API特有功能)
- pandasDF = young.toPandas()
- # 以表格形式打印输出
- young.show()
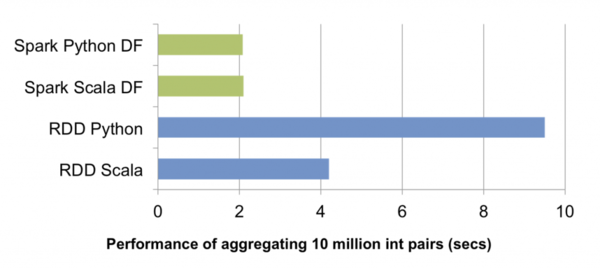
幕后英雄:Spark SQL查询优化器与代码生成
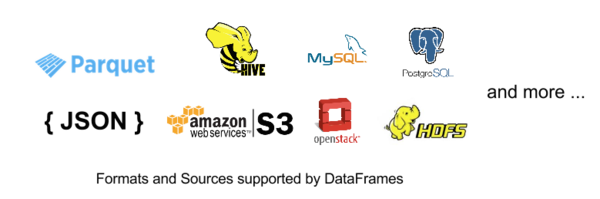
外部数据源API增强
数据写入支持
- CREATE [TEMPORARY] TABLE [IF NOT EXISTS]
- <table-name> [(col-name data-type [, ...)]
- USING <source> [OPTIONS ...]
- [AS <select-query>]
统一的load/save API
- rdd.saveAsParquetFile(...)
- rdd.saveAsTextFile(...)
- rdd.toJSON.saveAsTextFile(...)
- rdd.saveAsTable(...)
- ....
Parquet数据源增强
- // 创建两个简单的DataFrame,将之存入两个独立的分区目录
- val df1 = (1 to 5).map(i => (i, i * 2)).toDF("single", "double")
- df1.save("data/test_table/key=1", "parquet", SaveMode.Append)
- val df2 = (6 to 10).map(i => (i, i * 2)).toDF("single", "double")
- df2.save("data/test_table/key=2", "parquet", SaveMode.Append)
- // 在另一个DataFrame中引入一个新的列,并存入另一个分区目录
- val df3 = (11 to 15).map(i => (i, i * 3)).toDF("single", "triple")
- df3.save("data/test_table/key=3", "parquet", SaveMode.Append)
- // 一次性读入整个分区表的数据
- val df4 = sqlContext.load("data/test_table", "parquet")
- // 按分区进行查询,并展示结果
- val df5 = df4.filter($"key" >= 2) df5.show()
- 6 12 null 2
- 7 14 null 2
- 8 16 null 2
- 9 18 null 2
- 10 20 null 2
- 11 null 33 3
- 12 null 36 3
- 13 null 39 3
- 14 null 42 3
- 15 null 45 3
小结
【转载】Spark SQL 1.3.0 DataFrame介绍、使用的更多相关文章
- 平易近人、兼容并蓄——Spark SQL 1.3.0概览
自2013年3月面世以来,Spark SQL已经成为除Spark Core以外最大的Spark组件.除了接过Shark的接力棒,继续为Spark用户提供高性能的SQL on Hadoop解决方案之外, ...
- Spark SQL,如何将 DataFrame 转为 json 格式
今天主要介绍一下如何将 Spark dataframe 的数据转成 json 数据.用到的是 scala 提供的 json 处理的 api. 用过 Spark SQL 应该知道,Spark dataf ...
- Spark SQL概念学习系列之DataFrame与RDD的区别
不多说,直接上干货! DataFrame的推出,让Spark具备了处理大规模结构化数据的能力,不仅比原有的RDD转化方式更加简单易用,而且获得了更高的计算性能.Spark能够轻松实现从MySQL到Da ...
- Spark SQL 之 RDD、DataFrame 和 Dataset 如何选择
引言 Apache Spark 2.2 以及以上版本提供的三种 API - RDD.DataFrame 和 Dataset,它们都可以实现很多相同的数据处理,它们之间的性能差异如何,在什么情况下该选用 ...
- Spark SQL初始化和创建DataFrame的几种方式
一.前述 1.SparkSQL介绍 Hive是Shark的前身,Shark是SparkSQL的前身,SparkSQL产生的根本原因是其完全脱离了Hive的限制. SparkSQL支持查询原 ...
- spark SQL、RDD、Dataframe总结
- Spark学习之路(八)—— Spark SQL 之 DataFrame和Dataset
一.Spark SQL简介 Spark SQL是Spark中的一个子模块,主要用于操作结构化数据.它具有以下特点: 能够将SQL查询与Spark程序无缝混合,允许您使用SQL或DataFrame AP ...
- Spark 系列(八)—— Spark SQL 之 DataFrame 和 Dataset
一.Spark SQL简介 Spark SQL 是 Spark 中的一个子模块,主要用于操作结构化数据.它具有以下特点: 能够将 SQL 查询与 Spark 程序无缝混合,允许您使用 SQL 或 Da ...
- Spark SQL怎么创建编程创建DataFrame
创建DataFrame在Spark SQL中,开发者可以非常便捷地将各种内.外部的单机.分布式数据转换为DataFrame.以下Python示例代码充分体现了Spark SQL 1.3.0中DataF ...
随机推荐
- MFC通过对话框窗口句柄获得对话框对象指针
C***Dialog* pWnd= (C***Dialog*)FromHandle(hWnd); //由句柄得到对话框的对象指针 pWnd->xxx( ); ...
- RIA(富客户端)发展态势
在过去的两到三年中,Web开发人员一直是想构建一种比传统HTML更丰富的客户端:这是一个用户接口,它比用HTML能实现的接口更加健壮.反应更加灵敏和更具有令人感兴趣的可视化特性.RIA技术的出现允许我 ...
- static关键字修饰类
今天继续研究公司的新项目,据说是京东的架构,研究看了一番,果然很牛逼,大致是Maven+spingmvc+spring+mybatis+ehcache+velocity来搭建的,数据库用的是mysql ...
- mysql数据库表间内外链接详解
1. 内连接(自然连接) 2. 外连接 (1)左外连接 (左边的表不加限制)(2)右外连接(右边的表不加限制)(3)全外连接(左右两表都不加限制) 3. 自连接(同一张表内的连接) SQL的标准语法: ...
- java中关于类的封装与继承,this、super关键字的使用
原创作品,可以转载,但是请标注出处地址http://www.cnblogs.com/V1haoge/p/5454849.html. this关键字: this代表当前对象,它有以下几种用途: 1.本类 ...
- MySQL几个注意点
1.在创建表.对表进行操作之前,必须首先选择数据库.通过 mysql_select_db() 函数选取数据库.当您创建 varchar 类型的数据库字段时,必须规定该字段的最大长度,例如:varcha ...
- 浅谈IT员工管理
本人尽管还不是管理人员,但也管理过学弟们(不是同校.仅仅是工作中同事,为了好称呼叫学弟).也被管理着,工作也好多年了.今天又感而发.想来谈谈假设管理好员工(在此声明,我仅仅是发表个人意见哦.不要喷.哈 ...
- visual studio 2012进行C语言开发[图文]
现在大家计算机大概都脱离XP了,so,之前蛮多可以用的编译器,可能放在我们现在的Win7,win8下面会出现一些比如不兼容了之类的问题.其实,用微软强大的IDE-visual studio系列,也是可 ...
- utf-8 和gbk编码的差别
UTF- 8: 是用以解决国际上字符的一种多字节编码,它对英文使用8位(即一个字节),中文使用24为(三个字节)来编码. GBK 是国家标准GB2312基础上扩容后兼容GB2312的标准. GBK的文 ...
- 错误解决:release' is unavailable: not available in automatic reference counting mode
解决办法: You need to turn off Automatic Reference Counting. You do this by clicking on your project in ...