
【真相揭秘】requests获取网页编码乱码本质
有没有被网页编码抓狂,怎么转都是乱码。
通过查看requests源代码,才发现是库本身历史原因造成的。
作者是严格http协议标准写这个库的,《HTTP权威指南》里第16章国际化里提到,如果HTTP响应中Content-Type字段没有指定charset,则默认页面是'ISO-8859-1'编码。
这处理英文页面当然没有问题,但是中文页面,特别是那些不规范的页面,就会有乱码了!
比如分析jd.com 页面为gbk编码,问题就出在这里。
chardet库监测编码却是GB2312,两种编码虽然兼容的,但用GB2312解码gbk编码的网页字节串会运行错误!
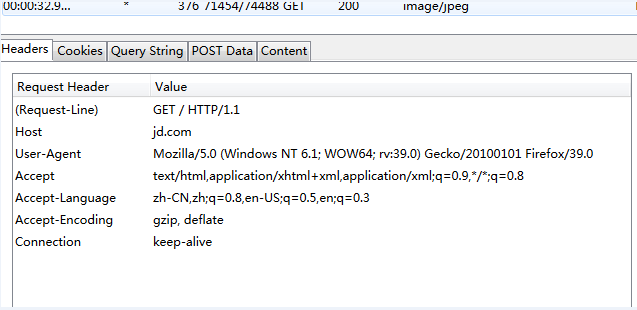

reqponse header只指定了type,但是没有指定编码(一般现在页面编码都直接在html页面中)。所有该函数就直接返回'ISO-8859-1'。
# test1

In [1]: r = requests.get('https://www.baidu.com/')

In [2]: r.encoding

Out[2]: 'ISO-8859-1'

In [3]: type(r.text)

Out[3]: unicode

In [4]: type(r.content)

Out[4]: str

In [5]: r.apparent_encoding

Out[5]: 'utf-8'

In [6]: chardet.detect(r.content)

Out[6]: {'confidence': 0.99, 'encoding': 'utf-8'}
在requests获取网页的编码格式时,有两种方式encoding和apparent_encoding,结果也不同,
推荐apparent_encoding,常规写法
url='xxx'

req =requests.get(url)

req.encoding=req.apparent_encoding

print(req.text)
总之一句话,遇到乱码加上apparent_encoding就完事了。
参考
https://www.cnblogs.com/emmm/p/9792832.html
https://www.cnblogs.com/bitpeng/p/4748872.html
【真相揭秘】requests获取网页编码乱码本质的更多相关文章
- python获取网页编码问题(encoding和apparent_encoding)
在requests获取网页的编码格式时,有两种方式,而结果也不同,通常用apparent_encoding更合适 注:推荐一个大佬写的关于获取网页编码格式以及requests中text()和conte ...
- Python 2.7.3 urllib2.urlopen 获取网页出现乱码解决方案
出现乱码的原因是,网页服务端有bug,它硬性使用使用某种特定的编码方案,而并没有按照客户端的请求头的编码要求来发送编码. 解决方案:使用chardet来猜测网页编码. 1.去chardet官网下载ch ...
- java根据URL获取网页编码
由于很多原因,我们要获取网页的编码(多半是写批量抓取的脚本吧...嘻嘻嘻) 注意: 如果你的目的是获取不乱码的网页内容(而不是根据网址发送post请求获取返回值),切记切记,移步这里 java根据UR ...
- asp.net 利用HttpWebRequest自动获取网页编码并获取网页源代码
/// <summary> /// 获取源代码 /// </summary> /// <param name="url"></param& ...
- 解决requests获取源代码时中文乱码问题
用requests获取源代码时,如果是中文网页,就可能会出现乱码,下面我以中关村的网站为例: import requests url = 'http://desk.zol.com.cn/meinv/' ...
- WebRequest 获取网页乱码
问题:在用WebRequest获取网页源码时得到的源码是乱码. 原因:1,编码不对 解决办法:设置对应编码 WebRequest request = WebRequest.Create(Url);We ...
- 爬虫 Http请求,urllib2获取数据,第三方库requests获取数据,BeautifulSoup处理数据,使用Chrome浏览器开发者工具显示检查网页源代码,json模块的dumps,loads,dump,load方法介绍
爬虫 Http请求,urllib2获取数据,第三方库requests获取数据,BeautifulSoup处理数据,使用Chrome浏览器开发者工具显示检查网页源代码,json模块的dumps,load ...
- 解决Chrome网页编码显示乱码的问题
解决Chrome网页编码显示乱码的问题 记得在没多久以前,Google Chrome上面出现编码显示问题时,可以手动来调整网页编码问题,可是好像在Chrome 55.0版以后就不再提供手动调整编码,所 ...
- node爬虫之gbk网页中文乱码解决方案
之前在用 node 做爬虫时碰到的中文乱码问题一直没有解决,今天整理下备忘.(PS:网上一些解决方案都已经不行了) 中文乱码具体是指用 node 请求 gbk 编码的网页,无法正确获取网页中的中文(需 ...
随机推荐
- Oliver Twist
对于济贫院那些绅士们而言,贫民好吃懒做.贪得无厌.他们消耗的食物即是对教区最大的威胁. 绅士们的利益得不到满足时,孤儿们只能被驱之而后快,甚至被"加价出售". 然而,眼泪这种东西根 ...
- CF思维联系--CodeForces -214C (拓扑排序+思维+贪心)
ACM思维题训练集合 Furik and Rubik love playing computer games. Furik has recently found a new game that gre ...
- CodeForces-259B]Little Elephant and Magic Square
Little Elephant loves magic squares very much. A magic square is a 3 × 3 table, each cell contains ...
- Unity 游戏框架搭建 2019 (四十二、四十三) MonoBehaviour 简化 & 定时功能
MonoBehaviour 简化 在前两篇,我们完成了第九个示例.为了完善第九个示例,我们复习了类的继承,又学习了泛型和 params 关键字. 我们已经接触了类的继承了.接触继承之前,把类仅仅当做是 ...
- github使用命令
创建本地库,提交,和绑定github ,上传代码 git init git add README.md git commit -m "first commit" git remot ...
- Java 常用API(一)
目录 Java 常用API(一) 1. Scanner类 引用类型的一般使用步骤 Scanner的使用步骤 例题 2. 匿名对象 概述 匿名对象作为方法的参数 匿名对象作为方法的返回值 3. Rand ...
- CDH删除节点(安全)
经过验证,最快最安全的删除CDH节点的方式,简单概括如下: 1.选中该机器,并停止该机器上的所有角色 2.去对应的服务中删除该机器中每一个角色 3.通过命令行,关闭该机器的的agent服务,并将该机器 ...
- 用PHP获取网页上的信息相对于xpath效率低点
用php实现对网页的抓取,及信息的收集,其实就是爬数据,具体实现步骤如下,首先应引入两个文件curl_html_get.php和save_file.php文件,两个文件具体代码是这样的curl_htm ...
- 用VirtualBox代替VMWare安装Ubuntu系统图文教程总结
文章目录 为什么使用VirtualBox,而不是VMWare? 图文教程 安装VirtualBox 下载Ubuntu镜像 新建虚拟机 安装Ubuntu系统 总结 为什么使用VirtualBox,而不是 ...
- Python拆分一列为多列
有的员工,没有公司开户行的银行卡,发放现金工资.有时人多,需要计算币数.现金工资表中,其中一列为实发工资,import pandas as pd,转化为pd.DataFrame. 面值[100,50, ...