
SRC漏洞挖掘
SRC目标搜集
文章类的平台
百度搜索
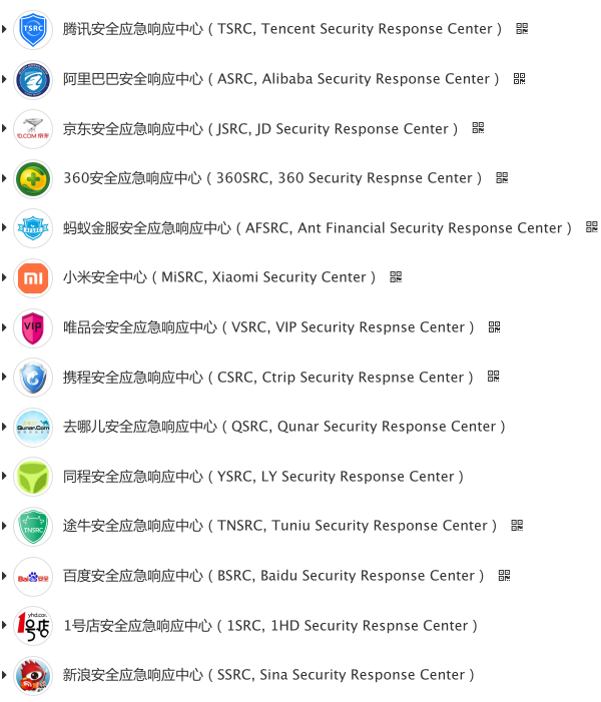
首先得知道SRC厂商的关键字,利用脚本搜集一波。
比如【应急响应中心】就可以作为一个关键字。通过搜索引擎搜索一波,去重,入库。

# -*- coding:utf-8 -*-

'''

从百度把前10页的搜索到的url爬取保存

'''

import multiprocessing  # 利用pool进程池实现多进程并行

#  from threading import Thread 多线程

import time

from bs4 import BeautifulSoup  # 处理抓到的页面

import sys

import requests

import importlib

importlib.reload(sys)  # 编码转换,python3默认utf-8,一般不用加

from urllib import request

import urllib

'''

all = open('D:\\111\\test.txt', 'a')

all.seek(0) #文件标记到初始位置

all.truncate() #清空文件

'''

headers = {

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

    'Accept-Encoding': 'gzip, deflate, compress',

    'Accept-Language': 'en-us;q=0.5,en;q=0.3',

    'Cache-Control': 'max-age=0',

    'Connection': 'keep-alive',

    'User-Agent': 'Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:22.0) Gecko/20100101 Firefox/22.0'

}  # 定义头文件,伪装成浏览器

def getfromBaidu(word):

    start = time.process_time()

    url = 'http://www.baidu.com.cn/s?wd=' + urllib.parse.quote(word) + '&pn='  # word为关键词,pn是百度用来分页的..

    pool = multiprocessing.Pool(multiprocessing.cpu_count())

    for k in range(1, 100):

        result = pool.apply_async(geturl, (url, k))  # 多进程

    pool.close()

    pool.join()

    print(time.process_time() - start)

def geturl(url, k):

    path = url + str((k - 1) * 10)

    response = request.urlopen(path)

    page = response.read()

    soup = BeautifulSoup(page, 'lxml')

    tagh3 = soup.find_all('h3')

    for h3 in tagh3:

        href = h3.find('a').get('href')

        # print(href)

        baidu_url = requests.get(url=href, headers=headers, allow_redirects=False)

        real_url = baidu_url.headers['Location']  # 得到网页原始地址

        if real_url.startswith('http'):

            print(real_url)

            #urls.insert({"url": real_url})

        # all.write(real_url + '\n')

if __name__ == '__main__':

    getfromBaidu('应急响应中心')
利用搜集好的域名
Github搜索“src 域名”
https://github.com/search?q=src+域名
SRC基础信息收集
微信公众号、xxsrc微信群。主要关注双倍积分活动、奖励大小、技术交流群里的信息。
通过公开信息掌握基础漏洞
在公开了漏洞标题的平台找最近活跃的漏洞类型是什么,然后找相关的实例学习。
通过公开信息掌握赏金较高的业务系统
通过某些公开了的漏洞标题找到业务系统,然后找同类型业务系统测试
https://sec.ly.com/bugs

https://hackerone.com/hacktivity?sort_type=latest_disclosable_activity_at&filter=type%3Aall&page=1&range=forever

https://dvpnet.io/lddt
大量的漏洞提交
不同的应急响应中心对业务漏洞的关注度不同,多提交才能知道哪些漏洞是能够高危的
1.不通过是因为写的不够详细,审核复现太麻烦,没有url,

2.教育和政府类发现xss不收,高危漏洞类型收的快

3.getshell评分高
漏洞新玩法
1.代码审计白盒挖掘传统漏洞

2.传统漏洞比较少(更多是业务逻辑,越权,资源耗尽导致的拒绝服务,多个漏洞的组合拳(xss+csrf))

3.需要更深层的资产搜集(比如阿里18周年,app搜集)

4.跟踪最新业务(京东618之前,上线了京东保租业务,近期上线了京东房产)

5.大数据分析(采集白帽子们提交的漏洞标题,分析挖洞行为)

6.业务和漏洞威胁情报

7.app漏洞挖掘

8.c/s架构漏洞挖掘/lot设备漏洞挖掘

9.hacker0ne公开的漏洞姿势学习和twitter上的分享
漏洞扫描器收集
Scanners Box是一个集合github平台上的安全行业从业者自研开源扫描器的仓库
https://github.com/We5ter/Scanners-Box
参考
[1] 区块链漏洞平台的漏洞信息 https://www.cnblogs.com/17bdw/p/11346628.html
[2] 【技巧总结】公开漏洞学习 https://www.cnblogs.com/17bdw/p/9195908.html
SRC漏洞挖掘的更多相关文章
- ref:PHP反序列化漏洞成因及漏洞挖掘技巧与案例
ref:https://www.anquanke.com/post/id/84922 PHP反序列化漏洞成因及漏洞挖掘技巧与案例 一.序列化和反序列化 序列化和反序列化的目的是使得程序间传输对象会更加 ...
- Vuzzer自动漏洞挖掘工具简单分析附使用介绍
Vuzzer 是由计算机科学机构 Vrije Universiteit Amsterdam.Amsterdam Department of Informatics 以及 International ...
- (转) exp1-1:// 一次有趣的XSS漏洞挖掘分析(1)
from http://www.cnblogs.com/hookjoy/p/3503786.html 一次有趣的XSS漏洞挖掘分析(1) 最近认识了个新朋友,天天找我搞XSS.搞了三天,感觉这一套 ...
- 关于PHP代码审计和漏洞挖掘的一点思考
这里对PHP的代码审计和漏洞挖掘的思路做一下总结,都是个人观点,有不对的地方请多多指出. PHP的漏洞有很大一部分是来自于程序员本身的经验不足,当然和服务器的配置有关,但那属于系统安全范畴了,我不太懂 ...
- xss漏洞挖掘小结
xss漏洞挖掘小结 最近,在挖掘xss的漏洞,感觉xss真的不是想象的那样简单,难怪会成为一类漏洞,我们从防的角度来讲讲xss漏洞的挖掘方法: 1.过滤 一般服务器端都是采用这种方式来防御xss攻击, ...
- 小白日记38:kali渗透测试之Web渗透-手动漏洞挖掘(四)-文件上传漏洞
手动漏洞挖掘 文件上传漏洞[经典漏洞,本身为一个功能,根源:对上传文件的过滤机制不严谨] <?php echo shell_exec($_GET['cmd']);?> 直接上传webshe ...
- 小白日记37:kali渗透测试之Web渗透-手动漏洞挖掘(三)-目录遍历、文件包含
手动漏洞挖掘 漏洞类型 #Directory traversal 目录遍历[本台机器操作系统上文件进行读取] 使用者可以通过浏览器/URL地址或者参数变量内容,可以读取web根目录[默认为:/var/ ...
- 小白日记36:kali渗透测试之Web渗透-手动漏洞挖掘(二)-突破身份认证,操作系统任意命令执行漏洞
手动漏洞挖掘 ###################################################################################### 手动漏洞挖掘 ...
- 小白日记35:kali渗透测试之Web渗透-手动漏洞挖掘(一)-默认安装引发的漏洞
手动漏洞挖掘 即扫描后,如何对发现的漏洞告警进行验证. #默认安装 流传linux操作系统比windows系统安全的说法,是因为windows系统默认安装后,会开放很多服务和无用的端口,而且未经过严格 ...
随机推荐
- python使用 pdb 进行调试--- python -m pdb xxx.py 即可 和gdb使用一样
使用 pdb 进行调试 pdb 是 python 自带的一个包,为 python 程序提供了一种交互的源代码调试功能,主要特性包括设置断点.单步调试.进入函数调试.查看当前代码.查看栈片段.动态改变变 ...
- 开发Electron可能用到的工具
nodejs:搭载谷歌v8内核的高性能的node环境npm:包管理工具webpack:模块打包器jQuery:js必备库Bootstrap:css必备库react:用于构建用户界面的库vue:构建数据 ...
- 第六周测试补交 多线程代码和sumN
1.多线程代码 要求:编译运行多线程程序,提交编译和运行命令截图 2.sumN 要求:1-N求和的截图
- HTTP Status 500 - DateConverter does not support default String to 'Date' conversion.错误
//自己指定一个类型转换器(将String转成Date) DateConverter converter = new DateConverter(); converter.setPattern(new ...
- python中的glob模块的使用
最近常常用到glob模块,这里做一个简单小结: 用它可以查找符合特定规则的文件路径名.跟使用windows下的文件搜索差不多.查找文件只用到三个匹配符:”*”, “?”, “[]”.”*”匹配0个或多 ...
- Python中实现count(distinct )
假设一个表有6个字段c1,c2,c3,c4,c5,c6,有如下的sql语句: select c1,count(distinct(c6)) from tbl where c3>1 group by ...
- Linux Shell 常用命令与目录分区的学习总结
很早就想根据自己的学习规律和遗忘规律,自己总结一下Linux/Unix系统的Shell命令,一来便于自己时常查询之用,二来也分享于各位博友 Linux shell是系统的用户界面,即命令行.它提供了用 ...
- python中的assert
assert 2>3, ("错误")print("haha") 如果断言处的表达式是错误的话,会打印assert后面的提示,并且下面的语句就不会执行了. ...
- learning java FileOutputStream
import java.io.FileInputStream; import java.io.FileNotFoundException; import java.io.FileOutputStrea ...
- [转]查看 docker 容器使用的资源
作者:sparkdev 出处:http://www.cnblogs.com/sparkdev/ 在容器的使用过程中,如果能及时的掌握容器使用的系统资源,无论对开发还是运维工作都是非常有益的.幸 ...