
CUDA[1] Introductory
Section 0 :Induction of CUDA
CUDA是啥?CUDA®: A General-Purpose Parallel Computing Platform and Programming Model
为什么用显卡就可以实现比CPU高得多的运算性能呢?这要从GPU的结构讲起:
GPU天生是为了图像处理而设计的,讲道理的话它能处理一些简单的运算工作(比如单独的顶点和线段)。但是在一个GPU中包含了许多个流处理器(Stream Processor),这些流处理器都可以并行工作。In this sense, GPUs are stream processors – processors that can operate in parallel by running one kernel on many records in a stream at once. [Reference]
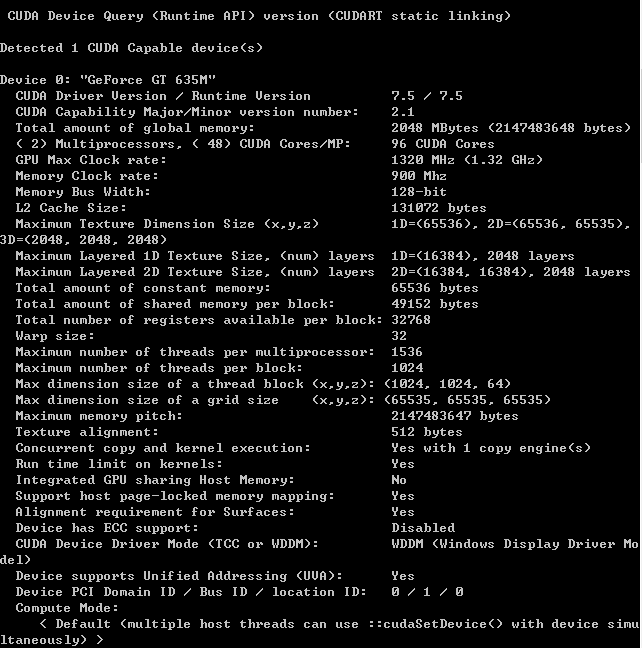
对于CPU来说,12核已经是上天了的配置。然而今天,随意一个亮机卡GPU都有96个CUDA计算单元(每个相当于一个计算核心)。其并行计算能力不可同日而语。
Section 1 :Thread Hierarchy
在CUDA的计算模型中,有如下几个concept:
1.thread
这里的线程和CPU中其实是一个意思。是执行运算的最小单位。
在执行时,每个线程都有一个自己独特的标识符 threadIdx。threadIdx可以是一维/二维/三维的。(threadIdx.x,threadIdx.y,threadIdx.z)
2.block (thread block)
一个线程块包含了多个线程
3.Streaming Multiprocessor
每个SM相当于一个计算单元,里面又包含很多个Streaming Processor。每个SM可并行运行一个block里的线程。
4.Kernel
kernel可以理解成一个函数。同一个kernel函数可以在多个线程中被执行。
比如下面的向量加法的程序:
 // Kernel definition

 __global__ void VecAdd(float* A, float* B, float* C)

 {

 int i = threadIdx.x;

 C[i] = A[i] + B[i];

 }

 int main()

 {

 ...

 // Kernel invocation with N threads

 VecAdd<<<, N>>>(A, B, C);

 ...

 }
line 2:用__global__关键字定义了一个kernel函数
line 4:threadIdx表示当前执行该kernel函数的这个thread的一个标号(可以理解为this指针的用途)
line 11:在调用kernel函数时,需要分配<<number_of_blocks , threads_per_block>> 。上述程序中分配了一个block,每个block中N个thread
虽然多个线程调用的都是同一个kernel function,但是它们分别在不同的数据空间进行加法运算(注意A、B、C的数组下标)。因此将一个大向量的加法运算给分解开了。
5.Grid
不同种类的kernel,每种kernel可以调度若干个block。这些block逻辑上被判为一个Grid。
thread、block和Streaming Multiprocessors的关系如下:
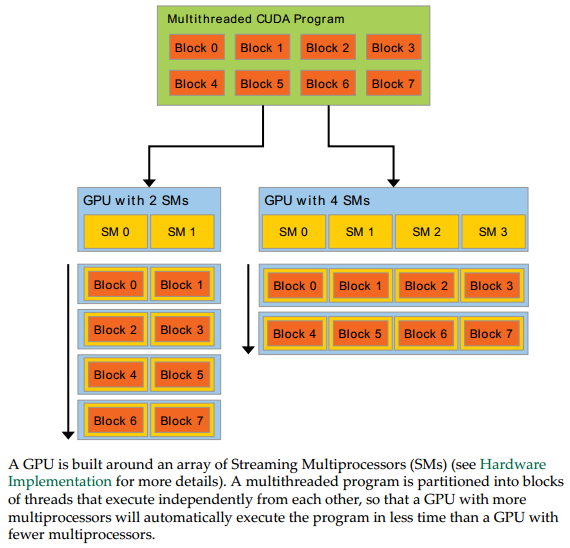
[Source: CUDA C Programming Guide.pdf]
如图,每个SM可以处理一个block,从而实现了并行计算。
两个层次的并行: • grid内多个block的并行 • block内多个thread的并行
注意:block和thread都是逻辑上的概念,物理上只存在SM。并不是一个SM一定严格对应一个block
比如对于我的亮机卡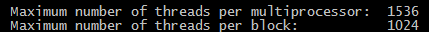
每个SM可以跑1536个线程,而每个block最多1024个
但是实际上因为寄存器大小不一定够,并不一定能全部跑满这些线程。如果强行跑,就可能会爆掉
Section 2:Memory Hierarchy
[注意这里说的Memory都是指显存。CPU无法直接访问显存中的数据。][Reference]
因此,一个CUDA程序必然少不了以下三步:
☻cudaMalloc:创建新的动态显存堆
☻cudaMemcpy:将主机(Host)内存复制到设备(Device)显存
☻显存处理完之后,cudaMemcpy:设备(Device)显存复制回主机(Host)内存,释放显存cudaFree
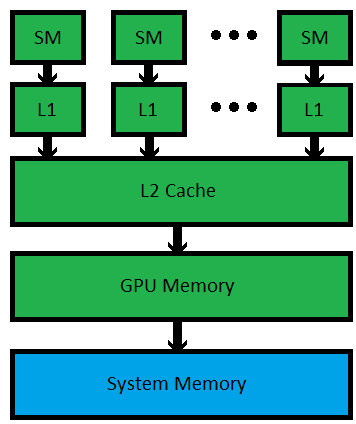
CPU/RAM与GPU/VRAM的关系如图:[Reference]
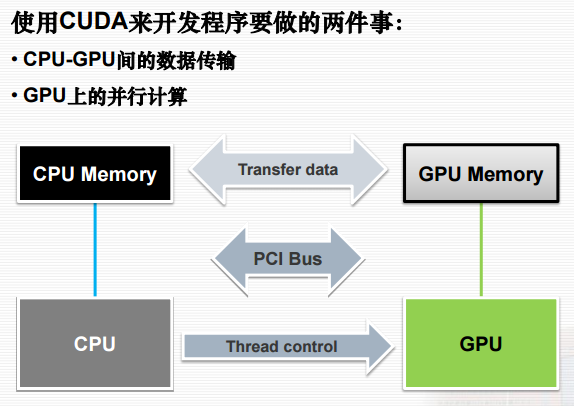
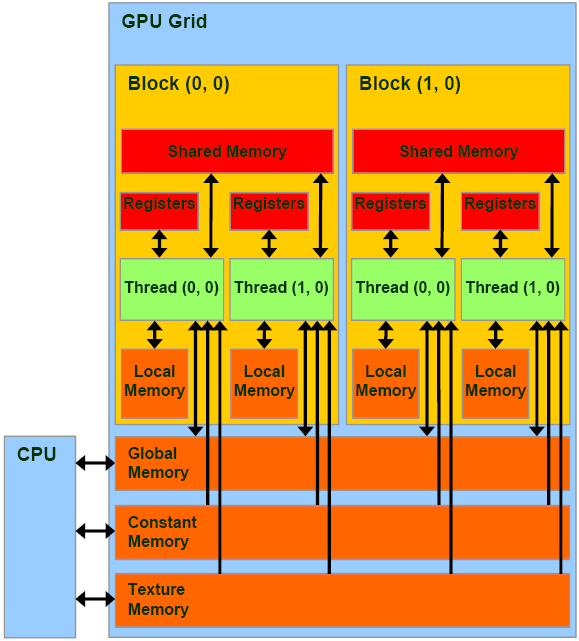
Gird、block、thread的内存访问/共享机制如下图:
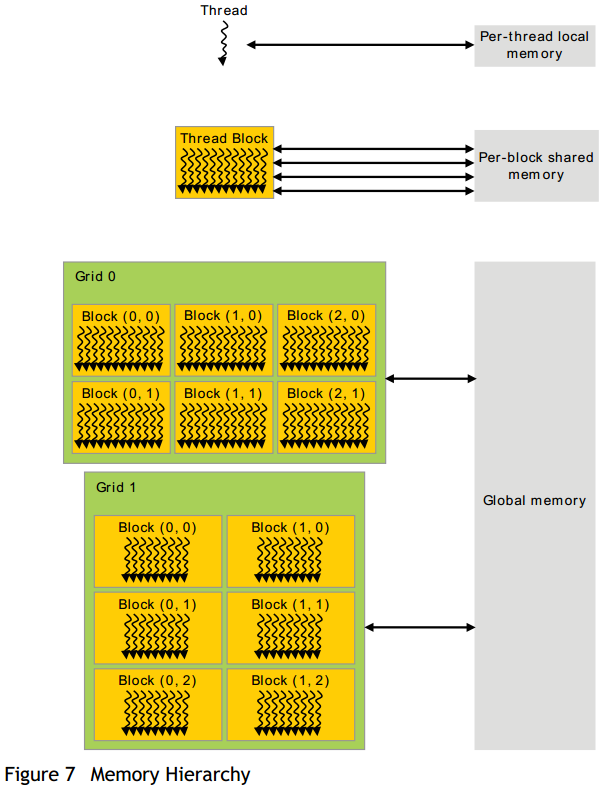
这里有几个概念:
Local Memory:单个线程内使用的内存空间
Shared Memory:一个block内所有线程共享的内存空间,常用于线程之间的通信。
每个SM(StreamingMultiprocessor)大约有16KB的shared memory
Global Memory:所有的block共享的内存空间。比shared速度慢,但是大许多
Constant Memory:存储常量。一块显卡大约有64KB的constant memory
从硬件的角度来看结构是这样的:[Reference] [Reference]
CUDA[1] Introductory的更多相关文章
- CUDA[2] Hello,World
Section 0:Hello,World 这次我们亲自尝试一下如何用粗(CU)大(DA)写程序 CUDA最新版本是7.5,然而即使是最新版本也不兼容VS2015 ...推荐使用VS2012 进入VS ...
- Couldn't open CUDA library cublas64_80.dll etc. tensorflow-gpu on windows
I c:\tf_jenkins\home\workspace\release-win\device\gpu\os\windows\tensorflow\stream_executor\dso_load ...
- ubuntu 16.04 + N驱动安装 +CUDA+Qt5 + opencv
Nvidia driver installation(after download XX.run installation file) 1. ctrl+Alt+F1 //go to virtual ...
- 手把手教你搭建深度学习平台——避坑安装theano+CUDA
python有多混乱我就不多说了.这个混论不仅是指整个python市场混乱,更混乱的还有python的各种附加依赖包.为了一劳永逸解决python的各种依赖包对深度学习造成的影响,本文中采用pytho ...
- [CUDA] CUDA to DL
又是一枚祖国的骚年,阅览做做笔记:http://www.cnblogs.com/neopenx/p/4643705.html 这里只是一些基础知识.帮助理解DL tool的实现. “这也是深度学习带来 ...
- 基于Ubuntu14.04系统的nvidia tesla K40驱动和cuda 7.5安装笔记
基于Ubuntu14.04系统的nvidia tesla K40驱动和cuda 7.5安装笔记 飞翔的蜘蛛人 注1:本人新手,文章中不准确的地方,欢迎批评指正 注2:知识储备应达到Linux入门级水平 ...
- CUDA程序设计(一)
为什么需要GPU 几年前我启动并主导了一个项目,当时还在谷歌,这个项目叫谷歌大脑.该项目利用谷歌的计算基础设施来构建神经网络. 规模大概比之前的神经网络扩大了一百倍,我们的方法是用约一千台电脑.这确实 ...
- 使用 CUDA范例精解通用GPU编程 配套程序的方法
用vs新建一个cuda的项目,然后将系统自动生成的那个.cu里头的内容,除了头文件引用外,全部替代成先有代码的内容. 然后程序就能跑了. 因为新建的是cuda的项目,所以所有的头文件和库的引用系统都会 ...
- CUDA代码移植
如果CUDA的代码移植,一个是要 include文件夹对不对,这个是.h文件能否找到的关键,另一个就是lib,这个是.lib文件能否找到的关键.具体检查地方,见下头. include: lib:
随机推荐
- spring mvc返回json字符串的方式
spring mvc返回json字符串的方式 方案一:使用@ResponseBody 注解返回响应体 直接将返回值序列化json 优点:不需要自己再处理 步骤一:在spring- ...
- [FromBody]与[FromUrl]
我们都知道,前台请求后台控制的方法有get方法和post方法两种, get:只支持ulr传数据,不管你是手动把参数拼接在Url里面还是写在data里面,只要是用get方法,都会自动绑定到url里面的形 ...
- 多页的TIFF图片在aspx页面分页显示
一.逻辑实现:将数据库中的二进制TIFF图片读出并分页显示在页面上. 1.显示界面 public FrameDimension MyGuid; ; ; public static MemoryStre ...
- Smart Tag——DevExpress WPF初探
Smart Tag是一个设计时扩展,所有标准控件均自带这个功能,当然也包括 DevExpress WPF Controls .可以快速设置控件的值或者绑定最重要的属性.它还可以帮助你完成一些重复的工作 ...
- 【代码笔记】iOS-UILable高度自适应(sizeWithFont)
一,代码. - (void)viewDidLoad { [super viewDidLoad]; // Do any additional setup after loading the view. ...
- jQuery Validate 表单验证 — 用户注册简单应用
相信很多coder在表单验证这块都是自己写验证规则的,今天我们用jQuery Validate这款前端验证利器来写一个简单的应用. 可以先把我写的这个小demo运行试下,先睹为快.猛戳链接--> ...
- A new comer playing with Raspberry Pi 3B
there are some things to do for raspberry pi 3b for the first time: 1, connect pi with monitor/KB/mo ...
- AEAI ESB路由转换机制说明
1. 背景概述 相信了解数通畅联的人对AEAI ESB并不陌生,其设计器ESBDesigner中内置组件有:路由和转换.数据适配器.协议适配器.协议接入适配器等4类组件,每类组件下面包含各种类型的组件 ...
- java中的SPI机制
1 SPI机制简介 SPI的全名为Service Provider Interface.大多数开发人员可能不熟悉,因为这个是针对厂商或者插件的.在java.util.ServiceLoader的文档里 ...
- Ubuntu 14.04 LTS 下升级 gcc 到 gcc-4.9、gcc-5 版本
如果没记错的话,阿里云ECS上的Ubuntu也是LTS版本. 如果还在使用较旧版本的Ubuntu,或者是Ubuntu LTS,那么我们是很难体验新版gcc的.怎么办呢? 我们或许可以自己去编译用旧版本 ...