
Storm学习笔记 - Storm初识
Storm学习笔记 - Storm初识
1. Strom是什么?
Storm是一个开源免费的分布式计算框架,可以实时处理大量的数据流。
2. Storm的特点
- 高性能,低延迟。
- 分布式:可解决数据量大,单机搞不定的场景。
- 可扩展:随着业务的发展,数据量越来越大,系统可以水平扩展。
容错:单个节点挂了,不影响整个应用。
3. Storm与其他框架的比较
3.1 Storm和Hadoop的比较
- Storm用于实时计算,Hadoop用于离线计算。
- Storm处理的数据保存在内存中,源源不断。Hadoop处理的数据保存在文件系统中,一批一批。
Storm与Hadoop的编程模型相似。
3.2 Storm与Spark streaming的比较
- Spark streaming采用小批量的方式,提高了吞吐性能。
处理数据的粒度变大,导致Spark streaming的数据延时不如Storm,Spark streaming是秒级返回结果(与设置的batch间隔有关),Storm则是毫秒级。
4. Storm集群架构
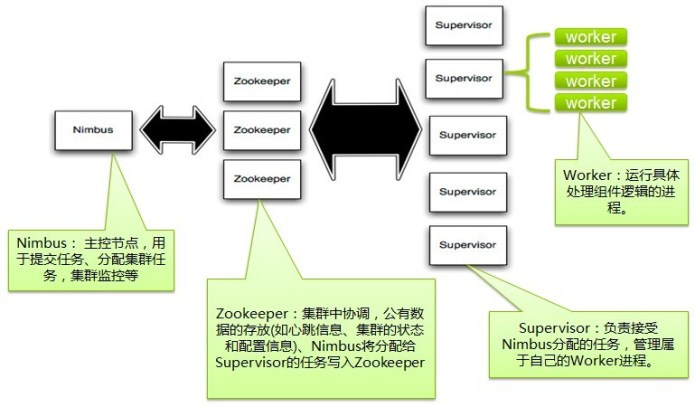
- Nimbus:Storm集群的主节点,负责分发用户代码,指派给具体的Supervisor节点上的Worker节点,去运行Topology对应的组件(Spout/Bolt)的Task。
- Supervisor,Storm集群的从节点,负责管理运行在Supervisor节点上的每一个Worker的启动和终止。可以通过配置项决定在一个Supervisor上最大可以运行多少个Slot,每个Slot通过端口号来唯一标识,一个端口号对应一个Worker进程。
- Worker:运行处理具体组件逻辑的进程,Worker运行的进程只有两种,一种是Spout进程,一种是Bolt进程。
- Task:Worker中每一个Spout/bolt的线程称为一个Task。
Zookeeper:用来协调Nimbus和Supervisor,如果Supervisor因故障出现问题而无法运行Topology,Nimbus会第一时间感知到,并重新分配Topology到其他可用的Supervisor上运行。
5. Storm编程模型
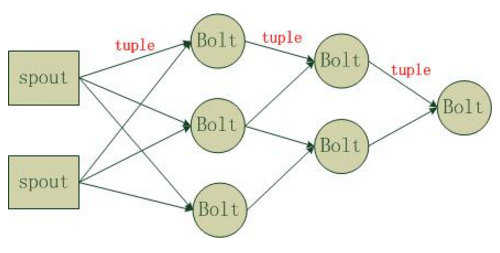
- Topology:Storm中运行的一个实时应用程序的名称。将 Spout、 Bolt整合起来的拓扑图。定义了 Spout和Bolt的结合关系、并发数量、配置等等。
- Spout:在一个topology中获取源数据流的组件。通常情况下spout会从外部数据源中读取数据,然后转换为topology内部的源数据。
- Bolt:接受数据然后执行处理的组件,用户可以在其中执行自己想要的操作。
- Tuple:一次消息传递的基本单元,理解为一组消息就是一个Tuple。
Stream:Tuple的集合。表示数据的流向。
6. 总结
- 拓扑(Topology):打包好的实时应用计算任务,同Hadoop的MapReduce任务相似。
- 元组(Tuple):是Storm提供的一个轻量级的数据格式,可以用来包装你需要实际处理的数据。
- 流(Streams):数据流(Stream)是Storm中对数据进行的抽象,它是时间上无界的tuple元组序列(无限的元组序列)。
- Spout(喷嘴):Storm中流的来源。Spout从外部数据源,如消息队列中读取元组数据并吐到拓扑里。
- Bolts:在拓扑中所有的计算逻辑都是在Bolt中实现的。
- 任务(Tasks):每个Spout和Bolt会以多个任务(Task)的形式在集群上运行。
- 组件(Component):是对Bolt和Spout的统称。
- 流分组(Stream groupings):流分组定义了一个流在一个消费它的Bolt内的多个任务(task)之间如何分组。
- 可靠性(Reliability):Storm保证了拓扑中Spout产生的每个元组都会被处理。
- Workers(工作进程):拓扑以一个或多个Worker进程的方式运行。每个Worker进程是一个物理的Java虚拟机,执行拓扑的一部分任务。
- Executor(线程):是1个被worker进程启动的单独线程。每个executor只会运行1个topology的1个component。
- Nimbus:Storm集群的Master节点,负责分发用户代码,指派给具体的Supervisor节点上的Worker节点,去运行Topology对应的组件(Spout/Bolt)的Task。
Supervisor:Storm集群的从节点,负责管理运行在Supervisor节点上的每一个Worker进程的启动和终止。
Storm学习笔记 - Storm初识的更多相关文章
- Storm学习笔记 - 消息容错机制
Storm学习笔记 - 消息容错机制 文章来自「随笔」 http://jsynk.cn/blog/articles/153.html 1. Storm消息容错机制概念 一个提供了可靠的处理机制的spo ...
- LevelDB学习笔记 (1):初识LevelDB
LevelDB学习笔记 (1):初识LevelDB 1. 写在前面 1.1 什么是levelDB LevelDB就是一个由Google开源的高效的单机Key/Value存储系统,该存储系统提供了Key ...
- Twitter Storm学习笔记
官方英文文档:http://storm.apache.org/documentation/Documentation.html 本文是学习笔记,转载整合加翻译,主要是为了便于学习. 一.基本概念 参考 ...
- Storm学习笔记——简介
1. 简介 流式计算的历史 早在7.8年前诸如UC伯克利.斯坦福等大学就开始了对流式数据处理的研究,但是由于更多的关注于金融行业的业务场景或者互联网流量监控的业务场景,以及当时互联网数据场景的限制,造 ...
- Java学习笔记心得——初识Java
初识Java 拿到这本厚厚的<Java学习笔记>,翻开目录:Java平台概论.从JDK到TDE.认识对象.封装.继承与多态...看着这些似懂非懂的术语名词,心里怀着些好奇与担忧,就这样我开 ...
- Storm学习笔记——高级篇
1. Storm程序的并发机制 1.1 概念 Workers (JVMs): 在一个物理节点上可以运行一个或多个独立的JVM 进程.一个Topology可以包含一个或多个worker(并行的跑在不同的 ...
- Storm学习笔记
1.如何让一个spout并行读取多个流? 方法:任何spout.bolts组件都可以访问TopologyContext.利用这个特性可以让Spouts的实例之间划分流. 示例:获取到storm集群sp ...
- Storm学习笔记六
1 Storm的通信机制 说明:1.worker与worker之间跨进程通信: 2.worker内部中各个executor间的通信,Task对象--->输入队列queue--->执行--- ...
- storm学习笔记(一)
1.storm介绍 storm是一种用于事件流处理的分布式计算框架,它是有BackType公司开发的一个项目,于2014年9月加入了Apahche孵化器计划并成为其旗下的顶级项目之一. ...
随机推荐
- [转] JS中的call()方法和apply()方法用法总结
//例1 <script> window.color = 'red'; document.color = 'yellow'; var s1 = {color: 'blue' }; func ...
- Spring Boot 整合Quartz定时器
概述 项目需要定时器的调度管理,原来使用Spring Boot自带的定时器,但是不能后台动态的操作暂停.启动以及新增任务等操作,维护起来相对麻烦:最近研究了Quartz的框架,觉得还算不错,整理了一下 ...
- 「JOISC 2017 Day 3」幽深府邸
题解: 和hnoi2018day2t1基本一样 我想了半小时想出了一个很麻烦的做法 写了之后发现假掉了 刚开始想的是 先预处理出每个门要打开至少要在左边的哪个点$L[]$,右边的哪个点$R[]$ 对每 ...
- 《ServerSuperIO Designer IDE使用教程》-1.标准Modbus和非标准协议的使用、测试以及驱动开发。附:v4.2发布
ServerSuperIO Designer IDE v4.2版本更新内容: 增加ServerSuperIO.Host运行程序,可以使用IDE进行测试,Host为运行环境. 针对设备驱动增加导入监测点 ...
- 实例分析ASP.NET在MVC5中使用MiniProfiler监控MVC性能的方法
这篇文章主要为大家详细介绍了ASP.NET MVC5使用MiniProfiler监控MVC性能,具有一定的参考价值,感兴趣的小伙伴们可以参考一下 MiniProfiler ,一个简单而有效的迷你剖析器 ...
- 基本urllib库
urlib库 urllib库是Python中一个最基本的网络请求库.可以模拟浏览器的行为,向指定的服务器发送一个请求,并可以保存服务器返回的数据. urlopen函数: 在Python3的urllib ...
- bower 基础认识
bower 跟 npm 很像 都是管理包的工具 只是 bower 偏向前端 npm 前后都能管理 npm init 后是 生产 package.json 下载的包在node_modules文件下 ...
- UOJ#374. 【ZJOI2018】历史 贪心,LCT
原文链接https://www.cnblogs.com/zhouzhendong/p/UOJ374.html 题解 想出正解有点小激动. 不过因为傻逼错误调到自闭.不如贺题 首先我们考虑如何 $O(n ...
- mysql分库分表,做到永不迁移数据和避免热点
作者:老顾聊技术 搜云库技术团队 来源:https://www.toutiao.com/i6677459303055491597 一.前言 中大型项目中,一旦遇到数据量比较大,小伙伴应该都知道就 ...
- 四、自动化平台搭建-Django-如何做验证码
前提:安装包 pip install pillow==3.4.1 1.打开booktest/views.py,创建视图verify_code. from PIL import Image, Ima ...