
LevelDB学习笔记 (1):初识LevelDB
LevelDB学习笔记 (1):初识LevelDB
1. 写在前面
1.1 什么是levelDB
LevelDB就是一个由Google开源的高效的单机Key/Value存储系统,该存储系统提供了Key到Value的有序映射。
1.2 为什么要学levelDB
学习源码算是一种很好的学习方式,准备精读几个经典的开源代码,那学习levelDB的原因主要有下
- 谷歌开源,代码质量非常高,而且只有1w行(去掉测试代码)不是过于复杂
- 现在主流的kv存储系统有很多基于levelDB或者借鉴了levelDB的思想
2. Linux/Mac下的编译运行
1. Quick start
下面来自于官方文档
mkdir -p build && cd build

cmake -DCMAKE_BUILD_TYPE=Release .. && cmake --build . #release版本

cmake -DCMAKE_BUILD_TYPE=Debug .. && cmake --build .	 #debug版本
在类linux系统下编译非常简单,上面两行就可以了
不过这里编译可能会遇到一些问题

比如我遇到了上面的问题,这是因为在third_party这个文件夹内缺少googletest和benchmark。
这里手动下载一下这两个文件把这个目录下的空文件替换了就好了。然后在执行cmake即可
上面是对应的github地址,直接点进去git clone就行,当然最近的github好像git clone总是出问题,我是直接下载zip然后替换过去的。
2. Quick test
新建一个文件夹叫my_test。添加一个新的cpp文件run_test.cpp
随后修改CMakeList.txt里添加关于新测试文件的规则。就可以了
我们准备写一个运行的测试文件,来创建一个db,随后进行添加和删除数据
#include <iostream>

#include <cassert>

#include "leveldb/db.h"

#include "leveldb/write_batch.h"

int main()

{

    // Open a database.

    leveldb::DB* db;

    leveldb::Options opts;

    opts.create_if_missing = true;

    leveldb::Status status = leveldb::DB::Open(opts, "../tmp/testdb", &db);

    assert(status.ok());

    // Write data.

    status = db->Put(leveldb::WriteOptions(), "name", "zxl");

    assert(status.ok());

    // Read data.

    std::string val;

    status = db->Get(leveldb::ReadOptions(), "name", &val);

    assert(status.ok());

    std::cout << val << std::endl;

   }
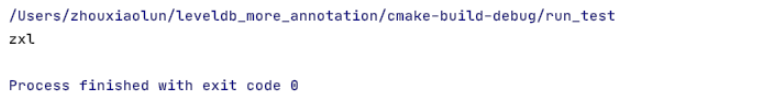
上面的代码就是我们在tmp文件下创建一个testdb。然后写入一条数据 key = "name" value = "zxl"。这个时候我们执行get操作就会得到我们刚才写入的值
3. LevelDB的基本操作
关于数据库的创建以及读写操作我们上面以及提过了
3.1 原子更新-Atomic Updates
下面的例子来自官方文档
考虑下面这一种情况,假如进程在Put key2 和 Delete key1两个操作之间结束,那么key1和key2这两个不同的键值将存储相同的值,这和我们的意愿相违背。为了避免这种情况的出现,leveldb利用WriteBatch来进行具有原子性的更新。
td::string value;

leveldb::Status s = db->Get(leveldb::ReadOptions(), key1, &value);

if (s.ok()) s = db->Put(leveldb::WriteOptions(), key2, value);

if (s.ok()) s = db->Delete(leveldb::WriteOptions(), key1);
#include "leveldb/write_batch.h"

...

std::string value;

leveldb::Status s = db->Get(leveldb::ReadOptions(), key1, &value);

if (s.ok()) {

  leveldb::WriteBatch batch;

  batch.Delete(key1);

  batch.Put(key2, value);

  s = db->Write(leveldb::WriteOptions(), &batch);

}
WriteBatch对象保存对数据库进行的一系列操作,然后在这一批次中按照顺序执行这些操作。
注意:这里先进行Delete操作,然后再进行Put操作。
WriteBatch类除了原子性的优势外,也可以用于通过将大量个体变动放置在同一批次中而加速批量更新。
3.2 迭代 - Iteration
下面的例子来自官方文档
下面的例子演示了如何从数据库中成对的打印键值:
leveldb::Iterator* it = db->NewIterator(leveldb::ReadOptions());

for (it->SeekToFirst(); it->Valid(); it->Next()) {

  cout << it->key().ToString() << ": "  << it->value().ToString() << endl;

}

assert(it->status().ok());  // Check for any errors found during the scan

delete it;
下面的修改后的例子演示了如何仅获取[start, limit)范围内的键;
for (it->Seek(start);

     it->Valid() && it->key().ToString() < limit;

     it->Next()) {

  ...

}
还可以通过相反的顺序进行处理。(警告:反向迭代比正向迭代慢一些)
for (it->SeekToLast(); it->Valid(); it->Prev()) {

  ...

}
好下面结合迭代和刚才学到的原子更新自己写一个测试文件
- 顺序全体迭代
 // test Atomic Updates

    leveldb::WriteBatch batch;

    batch.Delete("name");

    batch.Put("name0", "zxl0");

    batch.Put("name1", "zxl1");

    batch.Put("name2", "zxl2");

    status = db->Write(leveldb::WriteOptions(), &batch);

    assert(status.ok());

    //Scan database.

    leveldb::Iterator *it = db->NewIterator(leveldb::ReadOptions());

    for (it->SeekToFirst(); it->Valid(); it->Next()) {

        std::cout << it->key().ToString() << ": " <<

                  it->value().ToString() << std::endl;

    }

    assert(it->status().ok());
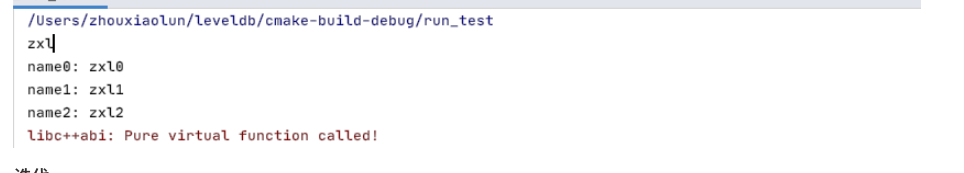
这段代码就会输出我们写入的三个k-v对
2. range 迭代
  for (it->Seek("name1"); it->Valid() && it->key().ToString() < "name2"; it->Next()) {

    std::cout << it->key().ToString() << ": " <<

              it->value().ToString() << std::endl;

  }

  delete it;
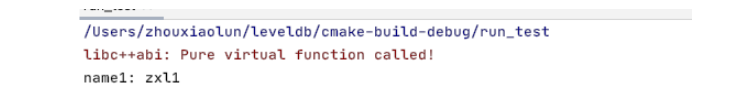
只会输出key值位于[name1,"name2")之间的value也就只输出了key=name1的value
当然还有其他的基本操作,但是这里我们展示了增删改查已经足够了.后面会在梳理具体实现的时候在增加新的测试文件
LevelDB学习笔记 (1):初识LevelDB的更多相关文章
- LevelDB学习笔记 (3): 长文解析memtable、跳表和内存池Arena
LevelDB学习笔记 (3): 长文解析memtable.跳表和内存池Arena 1. MemTable的基本信息 我们前面说过leveldb的所有数据都会先写入memtable中,在leveldb ...
- LevelDB 学习笔记1:布隆过滤器
LevelDB 学习笔记1:布隆过滤器 底层是位数组,初始都是 0 插入时,用 k 个哈希函数对插入的数字做哈希,并用位数组长度取余,将对应位置 1 查找时,做同样的哈希操作,查看这些位的值 如果所有 ...
- LevelDB 学习笔记2:合并
LevelDB 学习笔记2:合并 部分图片来自 RocksDB 文档 Minor Compaction 将内存数据库刷到硬盘的过程称为 minor compaction 产出的 L0 层的 sstab ...
- Storm学习笔记 - Storm初识
Storm学习笔记 - Storm初识 1. Strom是什么? Storm是一个开源免费的分布式计算框架,可以实时处理大量的数据流. 2. Storm的特点 高性能,低延迟. 分布式:可解决数据量大 ...
- Java学习笔记心得——初识Java
初识Java 拿到这本厚厚的<Java学习笔记>,翻开目录:Java平台概论.从JDK到TDE.认识对象.封装.继承与多态...看着这些似懂非懂的术语名词,心里怀着些好奇与担忧,就这样我开 ...
- leveldb 学习笔记之VarInt
在leveldb在查找比较时的key里面保存key长度用的是VarInt,何为VarInt呢,就是变长的整数,每7bit代表一个数,第8bit代表是否还有下一个字节, 1. 比如小于128(一个字节以 ...
- leveldb学习笔记
LevelDB由 Jeff Dean和Sanjay Ghemawat开发. LevelDb是能够处理十亿级别规模Key-Value型数据持久性存储的C++ 程序库. 特别如下: 1.LevelDb是一 ...
- LevelDB学习笔记 (2): 整体概览与读写实现细节
1. leveldb整体介绍 首先leveldb的数据是存储在磁盘上的.采用LSM-Tree实现,LSM-Tree把对于磁盘的随机写操作转换成了顺序写操作.这是得益于此leveldb的写操作非常快,为 ...
- leveldb 学习笔记之log结构与存取流程
log文件的格式 log文件每一条记录由四个部分组成: CheckSum,即CRC验证码,占4个字节 记录长度,即数据部分的长度,2个字节 类型,这条记录的类型,后续讲解,1个字节 数据,就是这条记录 ...
随机推荐
- 关于__new__和__call__的想法
__new__和__call__很像,两个都是用来产生对象的 __new__用来产生的对象是'类',class 时触发(不是) __call__用来产生的对象是'对象',这种对象无法继续产生对象,但是 ...
- 怎么用CMD命令进入D盘
怎么用CMD命令进入D盘 太平洋电脑网 已认证的官方帐号 6 人赞同了该文章 大家都知道win操作系统想要打开D盘,直接点我的电脑就能进d盘了,有时候只能使用dos的情况下也利用系统自带的cmd命 ...
- linux服务器默认使用中文字符集zh_CN.UTF-8
linux服务器默认使用中文字符集zh_CN.UTF-8 一.问题描述和相关概念 linux服务器的字符集设置可能影响到网站页面出现 "???" 等问号乱码,还有可能导致文件中的汉 ...
- Linux进阶之正则,shell三剑客(grep,awk,sed),cut,sort,uniq
一.正则表达式:Regular Expression 正则表达式:正则表达式使用单个字符串来描述.匹配一系列符合某个句法规则的字符串.在很多文本编辑器里,正则表达式通常被用来检索.替换那些符合某个模式 ...
- 11.7 iostat: I/O信息统计
iostat是I/O statistics(输入/输出统计)的缩写,其主要功能是对系统的磁盘I/O操作进行监视.它的输出主要是显示磁盘读写操作的统计信息,同时也会给出CPU的使用情况.同vmstat命 ...
- Docker的镜像理解以及容器的备份、恢复和迁移操作
Docker的镜像理解以及容器的备份.恢复和迁移操作 这篇文章主要介绍了Docker的镜像理解以及容器的备份.恢复和迁移操作,覆盖很多原理知识以及容器的重要操作步骤,极力推荐!需要的朋友可以参考下 D ...
- Step By Step(Lua输入输出库)
Step By Step(Lua输入输出库) I/O库为文件操作提供了两种不同的模型,简单模型和完整模型.简单模型假设一个当前输入文件和一个当前输出文件,他的I/O操作均作用于这些文件.完整模型则使用 ...
- Harmony生命周期
Harmony生命周期 系统管理或用户操作等行为,均会引起Page实例在其生命周期的不同状态之间进行转换.Ability类提供的回调机制能够让Page及时感知外界变化,从而正确地应对状态变化(比如释放 ...
- CUDA统一内存分析
CUDA统一内存分析 PascalMIG 如 NVIDIA Titan X 和 NVIDIA Tesla P100 是第一个包含页 GPUs 定额引擎的 GPUs ,它是统一内存页错误处理和 MIG ...
- 嵌入式C程序基础与编程结构
嵌入式C程序基础与编程结构 Basics of Embedded C Program and Programming Structure 嵌入式C编程是处理器在我们日常生活中遇到的每一个嵌入式系统(如 ...