
Python爬虫获取知乎图片
前段时间想抓点知乎问题中的图片,了解了下爬虫,发现还是Python的简单方便,于是做了点尝试.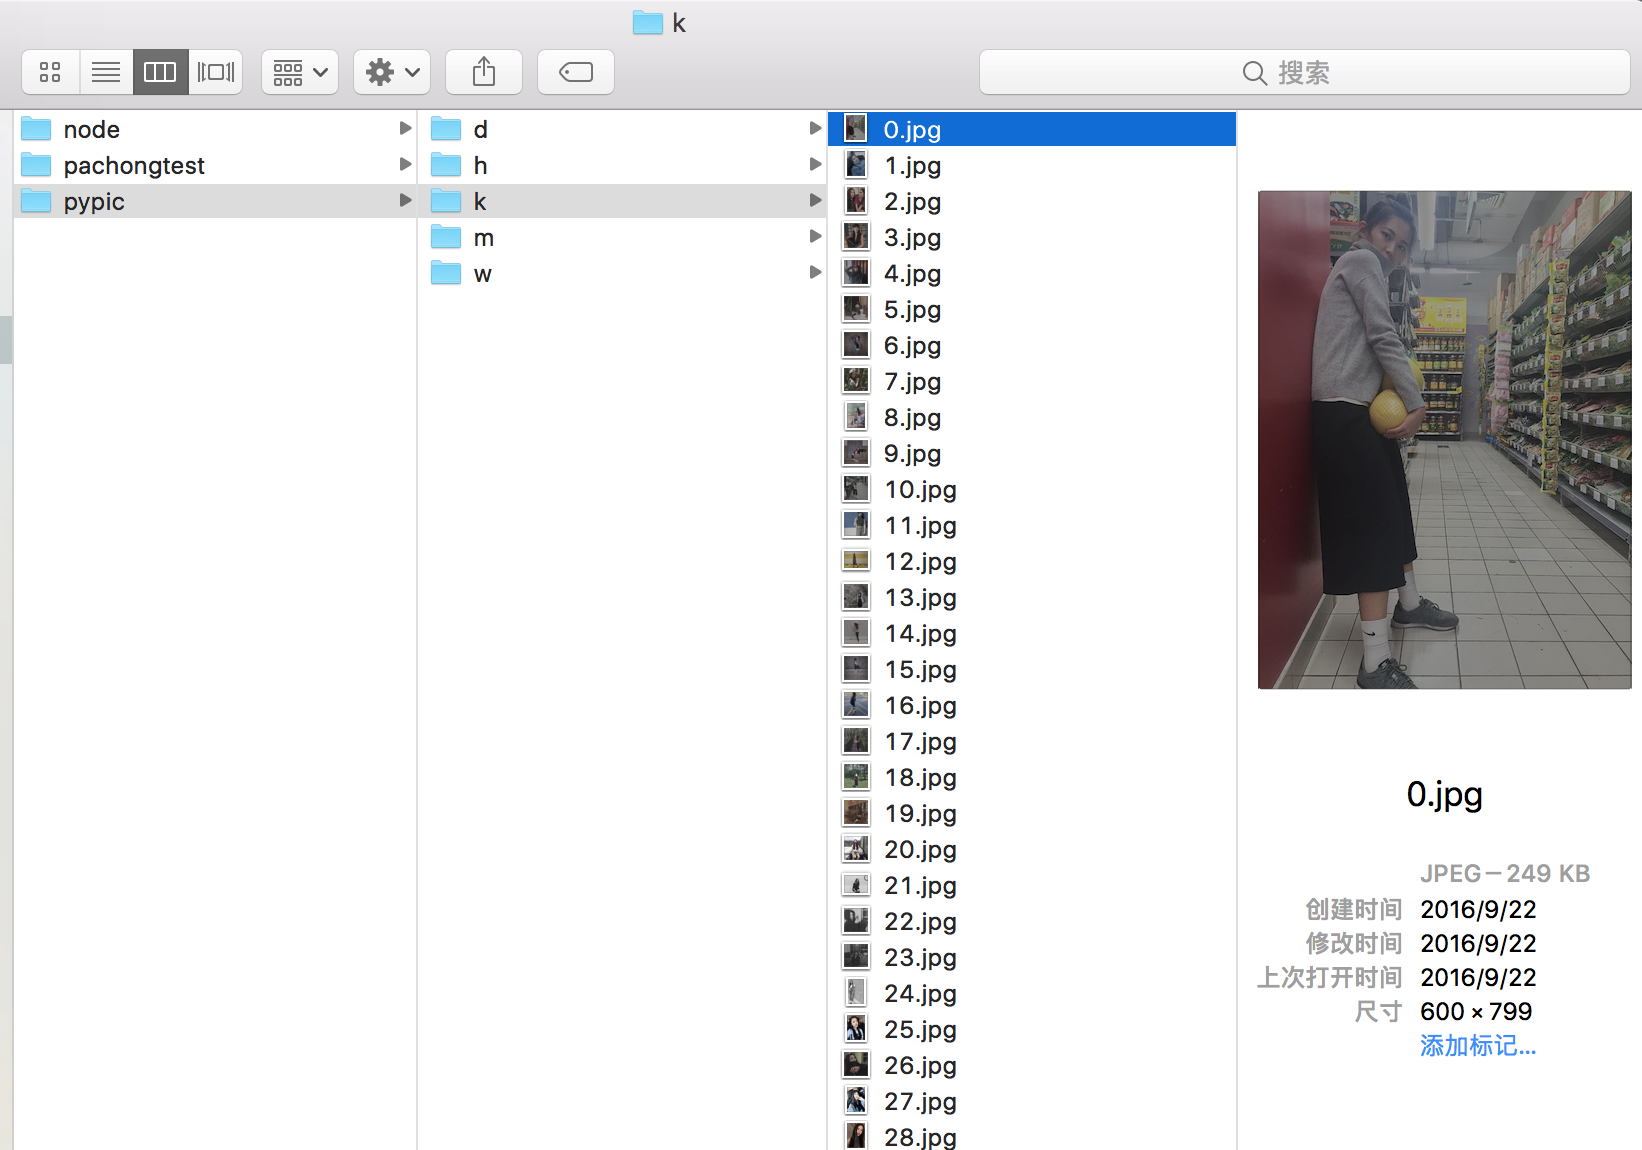
#coding=utf-8

import urllib

import re

def getHtml(url):

    page = urllib.urlopen(url)

    html = page.read()

    return html

def getImg(html):

   # reg = r'<noscript><img src="(.+?\.jpg)"'

    reg = r'data-actualsrc="(.+?\.jpg)"'

    imgre = re.compile(reg)

    imglist = re.findall(imgre,html)

    x = 0

    for imgurl in imglist:

        urllib.urlretrieve(imgurl,'%s.jpg' % x)

        x+=1

html = getHtml("https://www.zhihu.com/question/24278285")

print getImg(html)
把getHtml中的URL换成自己想获取的知乎问题就可以用了,默认是保存在xxx.py所在的文件夹中.
Python爬虫获取知乎图片的更多相关文章
- [Python]爬虫获取知乎某个问题下所有图片并去除水印
获取URL 进入某个知乎问题的主页下,按F12打开开发者工具后查看network面板. network面板可以查看页面向服务器请求的资源.资源的大小.加载资源花费的时间以及哪些资源加载失败等信息.还可 ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- python 爬虫得到网页的图片
import urllib.request,os import re # 获取html 中的内容 def getHtml(url): page=urllib.request.urlopen(url) ...
- python 爬虫必知必会
#python爬虫 #新闻数据 #机器学习:股票数据获取及分析 #网络搜索引擎的一个部件 #Http协议 #正则表达式 #多线程,分布式 #http报文展示 #Http 应答报文介绍 #1.应答码 # ...
- Python爬虫获取异步加载站点pexels并下载图片(Python爬虫实战3)
1. 异步加载爬虫 对于静态页面爬虫很容易获取到站点的数据内容,然而静态页面需要全量加载站点的所有数据,对于网站的访问和带宽是巨大的挑战,对于高并发和大访问访问量的站点来说,需要使用AJAX相关的技术 ...
- python爬虫获取百度图片(没有精华,只为娱乐)
python3.7,爬虫技术,获取百度图片资源,msg为查询内容,cnt为查询的页数,大家快点来爬起来.注:现在只能爬取到百度的小图片,以后有大图片的方法,我会陆续发贴. #!/usr/bin/env ...
- Python爬虫获取百度贴吧图片
#!/usr/bin/python# -*- coding: UTF-8 -*-import urllibimport re文章来源:https://www.cnblogs.com/Axi8/p/57 ...
- python爬虫获取图片
import re import os import urllib #根据给定的网址来获取网页详细信息,得到的html就是网页的源代码 def getHtml(url): page = urllib. ...
- Python爬虫之简单的图片获取
简单的静态网页的图片获取: import urllib import re import os url = 'http://www.toutiao.com/a6467889113046450702/' ...
随机推荐
- Class类文件结构、类加载机制以及字节码执行
一.Class类文件结构 Class类文件严格按照顺序紧凑的排列,由无符号数和表构成,表是由多个无符号数或其他数据项构成的符合数据结构. Class类文件格式按如下顺序排列: 类型 名称 数量 u ...
- 17.1.2.1 Advantages and Disadvantages of Statement-Based and Row-Based Replication 基于语句和行的复制的优势和劣势
17.1.2.1 Advantages and Disadvantages of Statement-Based and Row-Based Replication 基于语句和行的复制的优势和劣势 每 ...
- dom4j修改xml文件
@SuppressWarnings("unchecked") @Override public void insertCustomInfo(File file, String mo ...
- bzoj1232
由题意知,最后要保留的边肯定都要被走过 来回一条边所花费的时间=2*边长+安慰边两端的牛所要花的时间和 总时间就等于所保留边来回的时间和+根节点时间: 不难想到做一下最小生成树即可 贪心可知,根一定选 ...
- Apache Struts 跨站脚本漏洞
漏洞名称: Apache Struts 跨站脚本漏洞 CNNVD编号: CNNVD-201311-010 发布时间: 2013-11-04 更新时间: 2013-11-04 危害等级: 漏洞类型 ...
- [ZOJ 3631] Watashi's BG
Watashi's BG Time Limit: 3 Seconds Memory Limit: 65536 KB Watashi is the couch of ZJU-ICPC Team ...
- Hadoop RPC源码阅读-服务端Server
Hadoop版本Hadoop2.6 RPC主要分为3个部分:(1)交互协议 (2)客户端(3)服务端 (3)服务端 RPC服务端的实例代码: public class Starter { public ...
- 如何区分Shapefile,Coverage,Geodatabase(转载)
转自:http://www.cnblogs.com/linhugh/archive/2012/04/06/2435266.html 在过去20年中,矢量数据模型是GIS中变化最大的方面,例如,ESRI ...
- selenium webdriver(5)---超时设置
自动化测试中,等待时间的运用占据了举足轻重的地位,平常我们需要处理很多和时间息息相关的场景,例如: 打开新页面,只要特定元素出现而不用等待页面全部加载完成就对其进行操作 设置等待某元素出现的时间,超时 ...
- Apache支持.htaccess配置方法
打开httpd.conf文件用文本编辑器打开后,查找 代码如下 复制代码 Options FollowSymLinks AllowOverride None 改为: Options FollowSy ...