
自然语言推理:微调BERT
自然语言推理:微调BERT
Natural Language Inference: Fine-Tuning BERT
SNLI数据集上的自然语言推理任务设计了一个基于注意力的体系结构。现在通过微调BERT来重新讨论这个任务。自然语言推理是一个序列级文本对分类问题,而微调BERT只需要额外的基于MLP的架构,如图1所示。
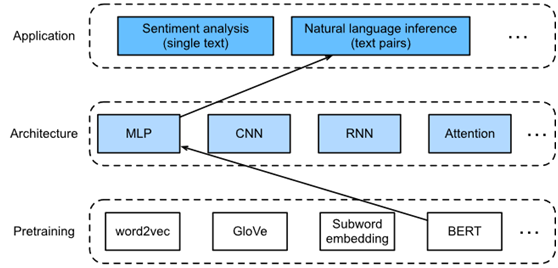
Fig. 1. This section feeds pretrained BERT to an MLP-based architecture for natural language inference.
下载一个经过预训练的小版本BERT,然后对其进行微调,以便在SNLI数据集上进行自然语言推理。
from d2l import mxnet as d2l
import json
import multiprocessing
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
import os
npx.set_np()
1. Loading Pretrained BERT
解释了如何在WikiText-2数据集上预训练BERT(注意,原始的BERT模型是在更大的语料库上预训练的)。最初的BERT模型有上亿个参数。提供两个版本的预训练BERT:“bert.base “大约和原始的BERT基模型一样大,需要大量的计算资源进行微调,而“bert.small”是一个小版本,便于演示。
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.zip',
'7b3820b35da691042e5d34c0971ac3edbd80d3f4')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.zip',
'a4e718a47137ccd1809c9107ab4f5edd317bae2c')
任何一个预训练的BERT模型都包含一个“vocab.json”定义词汇集和“pretrained.params”预训练参数的文件。实现了如下加载预训练模型函数来load_pretrained_model加载预训练的BERT参数。
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len, ctx):
data_dir = d2l.download_extract(pretrained_model)
# Define an empty vocabulary to load the predefined vocabulary
vocab = d2l.Vocab([])
vocab.idx_to_token = json.load(open(os.path.join(data_dir, 'vocab.json')))
vocab.token_to_idx = {token: idx for idx, token in enumerate(
vocab.idx_to_token)}
bert = d2l.BERTModel(len(vocab), num_hiddens, ffn_num_hiddens, num_heads,
num_layers, dropout, max_len)
# Load pretrained BERT parameters
bert.load_parameters(os.path.join(data_dir, 'pretrained.params'), ctx=ctx)
return bert, vocab
为了便于在大多数机器上演示,将加载并微调小版本(“bert.small”)的名称。在练习中,将演示如何微调更大的“bert.base”以显著提高测试精度。
ctx = d2l.try_all_gpus()
bert, vocab = load_pretrained_model(
'bert.small', num_hiddens=256, ffn_num_hiddens=512, num_heads=4,
num_layers=2, dropout=0.1, max_len=512, ctx=ctx)
Downloading ../data/bert.small.zip from http://d2l-data.s3-accelerate.amazonaws.com/bert.small.zip...
2. The Dataset for Fine-Tuning BERT
对于SNLI数据集上的下游任务自然语言推理,定义了一个自定义的数据集类SNLIBERTDataset。在每个例子中,前提和假设形成一对文本序列,并被打包成一个BERT输入序列,如图2所示。段IDs用于区分BERT输入序列中的前提和假设。使用预定义的BERT输入序列的最大长度(max_len),输入文本对中较长的最后一个标记会一直被删除,直到满足max_len。为了加速生成用于微调BERT的SNLI数据集,使用4个worker进程并行地生成训练或测试示例。
class SNLIBERTDataset(gluon.data.Dataset):
def __init__(self, dataset, max_len, vocab=None):
all_premise_hypothesis_tokens = [[
p_tokens, h_tokens] for p_tokens, h_tokens in zip(
*[d2l.tokenize([s.lower() for s in sentences])
for sentences in dataset[:2]])]
self.labels = np.array(dataset[2])
self.vocab = vocab
self.max_len = max_len
(self.all_token_ids, self.all_segments,
self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
print('read ' + str(len(self.all_token_ids)) + ' examples')
def _preprocess(self, all_premise_hypothesis_tokens):
pool = multiprocessing.Pool(4) # Use 4 worker processes
out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
all_token_ids = [
token_ids for token_ids, segments, valid_len in out]
all_segments = [segments for token_ids, segments, valid_len in out]
valid_lens = [valid_len for token_ids, segments, valid_len in out]
return (np.array(all_token_ids, dtype='int32'),
np.array(all_segments, dtype='int32'),
np.array(valid_lens))
def _mp_worker(self, premise_hypothesis_tokens):
p_tokens, h_tokens = premise_hypothesis_tokens
self._truncate_pair_of_tokens(p_tokens, h_tokens)
tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
* (self.max_len - len(tokens))
segments = segments + [0] * (self.max_len - len(segments))
valid_len = len(tokens)
return token_ids, segments, valid_len
def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
# Reserve slots for '<CLS>', '<SEP>', and '<SEP>' tokens for the BERT
# input
while len(p_tokens) + len(h_tokens) > self.max_len - 3:
if len(p_tokens) > len(h_tokens):
p_tokens.pop()
else:
h_tokens.pop()
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx]), self.labels[idx]
def __len__(self):
return len(self.all_token_ids)
在下载SNLI数据集之后,通过实例化SNLIBERTDataset类来生成训练和测试示例。这些例子将在自然语言推理的训练和测试中分批阅读。
# Reduce `batch_size` if there is an out of memory error. In the original BERT
# model, `max_len` = 512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = gluon.data.DataLoader(train_set, batch_size, shuffle=True,
num_workers=num_workers)
test_iter = gluon.data.DataLoader(test_set, batch_size,
num_workers=num_workers)
read 549367 examples
read 9824 examples
3. Fine-Tuning BERT
如图2所示,用于自然语言推理的微调BERT只需要由两个完全连接的层组成的额外MLP(参见自隐藏以及自输出在下面的BERTClassifier类中)。这种MLP将编码前提和假设信息的特殊“<cls>”标记的BERT表示转化为自然语言推理的三种输出:蕴涵、矛盾和中性。
class BERTClassifier(nn.Block):
def __init__(self, bert):
super(BERTClassifier, self).__init__()
self.encoder = bert.encoder
self.hidden = bert.hidden
self.output = nn.Dense(3)
def forward(self, inputs):
tokens_X, segments_X, valid_lens_x = inputs
encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x)
return self.output(self.hidden(encoded_X[:, 0, :]))
接下来,将预训练的BERT模型BERT输入BERT分类器实例网络,供下游应用程序使用。在一般的BERT微调实现中,只有输出层的参数附加MLP(net.output)从零开始学习。预训练BERT编码器的所有参数(net.encoder)以及附加MLP的隐藏层(net.hidden)将进行微调。
net = BERTClassifier(bert)
net.output.initialize(ctx=ctx)
MaskLM类和NextSentencePred类在使用的mlp中都有参数。这些参数是预训练BERT模型BERT的一部分,因此也是网络中的一部分。然而,这些参数仅用于计算预训练过程中的隐含语言建模损失和下一句预测损失。这两个损失函数与下游应用的微调无关,因此当对BERT进行微调时,MaskLM和NextSentencePred中使用的MLPs的参数不会更新(过期)。
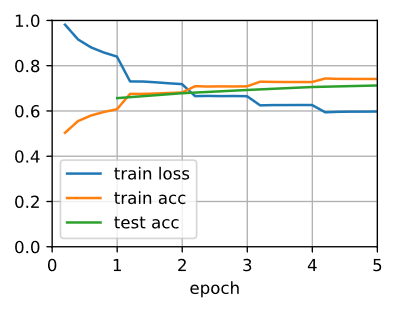
为了允许参数具有过时渐变,在d2l.train_batch_ch13的步进函数中设置标志ignore_stale_grad=True。利用SNLI的训练集(train_iter)和测试集(test_iter)来训练和评估模型网络。由于计算资源有限,训练和测试的准确性还有待进一步提高:将其讨论留在练习中。
lr, num_epochs = 1e-4, 5
trainer = gluon.Trainer(net.collect_params(), 'adam', {'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, ctx,
d2l.split_batch_multi_inputs)
loss 0.597, train acc 0.741, test acc 0.713
8563.9 examples/sec on [gpu(0), gpu(1)]
4. Summary
- We can fine-tune the pretrained BERT model for downstream applications, such as natural language inference on the SNLI dataset.
- During fine-tuning, the BERT model becomes part of the model for the downstream application. Parameters that are only related to pretraining loss will not be updated during fine-tuning.
自然语言推理:微调BERT的更多相关文章
- [NLP自然语言处理]谷歌BERT模型深度解析
我的机器学习教程「美团」算法工程师带你入门机器学习 已经开始更新了,欢迎大家订阅~ 任何关于算法.编程.AI行业知识或博客内容的问题,可以随时扫码关注公众号「图灵的猫」,加入”学习小组“,沙雕博主 ...
- 美团:WSDM Cup 2019自然语言推理任务获奖解题思路
WSDM(Web Search and Data Mining,读音为Wisdom)是业界公认的高质量学术会议,注重前沿技术在工业界的落地应用,与SIGIR一起被称为信息检索领域的Top2. 刚刚在墨 ...
- 微调BERT:序列级和令牌级应用程序
微调BERT:序列级和令牌级应用程序 Fine-Tuning BERT for Sequence-Level and Token-Level Applications 为自然语言处理应用程序设计了不同 ...
- 《Enhanced LSTM for Natural Language Inference》(自然语言推理)
解决的问题 自然语言推理,判断a是否可以推理出b.简单讲就是判断2个句子ab是否有相同的含义. 方法 我们的自然语言推理网络由以下部分组成:输入编码(Input Encoding ),局部推理模型(L ...
- <A Decomposable Attention Model for Natural Language Inference>(自然语言推理)
http://www.xue63.com/toutiaojy/20180327G0DXP000.html 本文提出一种简单的自然语言推理任务下的神经网络结构,利用注意力机制(Attention Mec ...
- Textual Entailment(自然语言推理-文本蕴含) - AllenNLP
自然语言推理是NLP高级别的任务之一,不过自然语言推理包含的内容比较多,机器阅读,问答系统和对话等本质上都属于自然语言推理.最近在看AllenNLP包的时候,里面有个模块:文本蕴含任务(text en ...
- 【学习笔记】B站-2019-NLP(自然语言处理)之 BERT 课程 -- 相关课程笔记
BERT 课程笔记 1. 传统方案遇到的问题 BERT的核心在于Transformer,Transformer就类似seq2seq网络输入输出之间的网络结构. 传统的RNN网络:最大的问题,因为不能并 ...
- 用NVIDIA-NGC对BERT进行训练和微调
用NVIDIA-NGC对BERT进行训练和微调 Training and Fine-tuning BERT Using NVIDIA NGC 想象一下一个比人类更能理解语言的人工智能程序.想象一下为定 ...
- 基于TensorRT的BERT实时自然语言理解(下)
基于TensorRT的BERT实时自然语言理解(下) BERT Inference with TensorRT 请参阅Python脚本bert_inference.py还有详细的Jupyter not ...
随机推荐
- hdu4403暴力搜索
题意: 给你一个数字串,让你在里面添加一个=和若干个+,使等式成立. 思路: lmax最大是15,直接暴搜,无压力,关键是判重,要在答案的时候判重,一开始在进队列之前判的,各种wa ...
- hdu3117 斐波那契前后4位
题意: 求斐波那契的前后4位,n <= 10^8. 思路: 至于前四位,和hdu1568的求法一样: http://blog.csdn.net/u013761 ...
- HTTPS协议工作原理(SSL数字证书)
目录 HTTPS SSL协议的工作过程 SSL数字证书的查看 HTTPS 我们都知道HTTP协议是明文传输的,并且不能验证对方的身份,而且不能保证数据的完整性.而当我们在网络上进行购物电子交易时,电子 ...
- Intel汇编语言程序设计学习-第三章 汇编语言基础-下
3.4 定义数据 3.4.1 内部数据类型 MASM定义了多种内部数据类型,每种数据类型都描述了该模型的变量和表达式的取值集合.数据类型的基本特征是以数据位的数目量的大小:8,16,32,,48, ...
- 一、Github+Pycharm基础
GitHub为版本管理工具 常用的版本管理工具:本地化版本管理系统.集中式版本管理系统SVN.分布式版本管理系统 一.安装git(自行百度) 二.文件操作与分支管理基础 1.版本控制系统分类 集中化版 ...
- [bug] Job for network.service failed because the control process exited with error code
原因 复制虚拟机,没有改网卡配置文件 参考 https://blog.csdn.net/dongfei2033/article/details/81124465
- 使用 yum-cron 自动更新 Linux系统
使用 yum-cron 自动更新 Linux系统 Linux系统技术交流QQ群(1675603)验证问题答案:刘遄 我知道如何使用 yum 命令行 更新系统,但是我想用 cron 任务自动更新软件 ...
- 攻防世界(十二)upload1
攻防世界系列 :upload1 1.打开题目,文件上传. 2.立即上传shell 1.php <?php @eval($_POST[root]); ?> 提示只能上传图片 3.burp改报 ...
- pgrep cron
# pgrep cron947[root@localhost cron]# pgrep --help Usage: pgrep [options] <pattern> Options: - ...
- 050.Python前端jQuery
一 jQuery是什么? jQuery由美国人John Resig创建,至今已吸引了来自世界各地的众多 javascript高手加入其team. jQuery是继prototype之后又一个优秀的Ja ...