
Spark常用函数讲解之Action操作
RDD:弹性分布式数据集,是一种特殊集合 ‚ 支持多种来源 ‚ 有容错机制 ‚ 可以被缓存 ‚ 支持并行操作,一个RDD代表一个分区里的数据集
RDD有两种操作算子:
Ation(执行):触发Spark作业的运行,真正触发转换算子的计算
本系列主要讲解Spark中常用的函数操作:
1.RDD基本转换
2.键-值RDD转换
3.Action操作篇
def main(args: Array[String]) {

    val conf = new SparkConf().setMaster("local").setAppName("reduce")

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(1 to 10,2)

    val reduceRDD = rdd.reduce(_ + _)

    val reduceRDD1 = rdd.reduce(_ - _) //如果分区数据为1结果为 -53

    val countRDD = rdd.count()

    val firstRDD = rdd.first()

    val takeRDD = rdd.take(5)    //输出前个元素

    val topRDD = rdd.top(3)      //从高到底输出前三个元素

    val takeOrderedRDD = rdd.takeOrdered(3)    //按自然顺序从底到高输出前三个元素

    println("func +: "+reduceRDD)

    println("func -: "+reduceRDD1)

    println("count: "+countRDD)

    println("first: "+firstRDD)

    println("take:")

    takeRDD.foreach(x => print(x +" "))

    println("\ntop:")

    topRDD.foreach(x => print(x +" "))

    println("\ntakeOrdered:")

    takeOrderedRDD.foreach(x => print(x +" "))

    sc.stop

  }
func +:

func -:  //如果分区数据为1结果为 -53

count:

first:

take:

top:

takeOrdered:
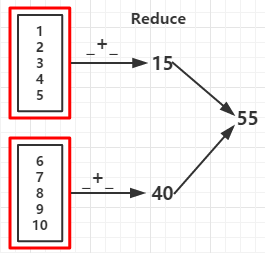

 def main(args: Array[String]) {

    val conf = new SparkConf().setMaster("local").setAppName("KVFunc")

    val sc = new SparkContext(conf)

    val arr = List(("A", 1), ("B", 2), ("A", 2), ("B", 3))

    val rdd = sc.parallelize(arr,2)

    val countByKeyRDD = rdd.countByKey()

    val collectAsMapRDD = rdd.collectAsMap()

    println("countByKey:")

    countByKeyRDD.foreach(print)

    println("\ncollectAsMap:")

    collectAsMapRDD.foreach(print)

    sc.stop

  }
countByKey:

(B,)(A,)

collectAsMap:

(A,)(B,)

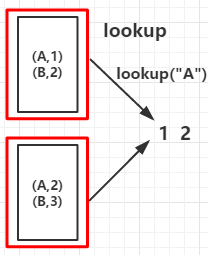
def main(args: Array[String]) {

    val conf = new SparkConf().setMaster("local").setAppName("Fold")

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(List(1,2,3,4),2)

    val aggregateRDD = rdd.aggregate(2)(_+_,_ * _)

    println(aggregateRDD)

    sc.stop

  }

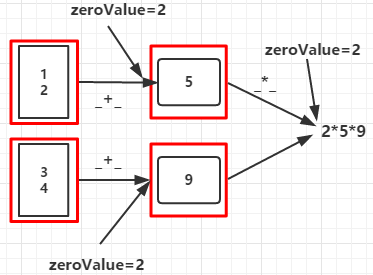
def main(args: Array[String]) {

    val conf = new SparkConf().setMaster("local").setAppName("Fold")

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(Array(("a", 1), ("b", 2), ("a", 2), ("c", 5), ("a", 3)), 2)

    val foldRDD = rdd.fold(("d", 0))((val1, val2) => { if (val1._2 >= val2._2) val1 else val2

    })

    println(foldRDD)

  }
c,5

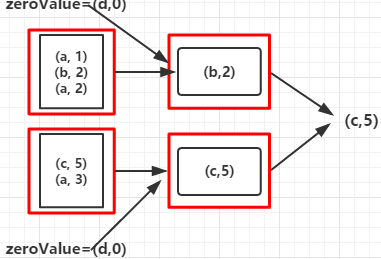
Spark常用函数讲解之Action操作的更多相关文章
- Spark常用函数讲解之键值RDD转换
摘要: RDD:弹性分布式数据集,是一种特殊集合 ‚ 支持多种来源 ‚ 有容错机制 ‚ 可以被缓存 ‚ 支持并行操作,一个RDD代表一个分区里的数据集RDD有两种操作算子: Trans ...
- spark 常用函数介绍(python)
以下是个人理解,一切以官网文档为准. http://spark.apache.org/docs/latest/api/python/pyspark.html 在开始之前,我先介绍一下,RDD是什么? ...
- Spark RDD概念学习系列之action操作
不多说,直接上干货! action操作
- Spark常用函数(源码阅读六)
源码层面整理下我们常用的操作RDD数据处理与分析的函数,从而能更好的应用于工作中. 连接Hbase,读取hbase的过程,首先代码如下: def tableInitByTime(sc : SparkC ...
- CI框架常用函数(AR数据库操作的常用函数)
用户手册地址:http://codeigniter.org.cn/user_guide/index.html 1.查询表记录$this->db->select(); //选择查询的字段$t ...
- 四、spark常用函数说明学习
1.parallelize 并行集合,切片数.默认为这个程序所分配到的资源的cpu核的个数. 查看大小:rdd.partitions.size sc.paraliel ...
- Opencv常用函数讲解
1.approxPolyDP(Mat(ps), poly, 5, true);//根据点集,拟合出多边形 2.fillConvexPoly(mask, Mat(ps), Scalar(255));根据 ...
- Spark RDD、DataFrame原理及操作详解
RDD是什么? RDD (resilientdistributed dataset),指的是一个只读的,可分区的分布式数据集,这个数据集的全部或部分可以缓存在内存中,在多次计算间重用. RDD内部可以 ...
- Spark Streaming中的操作函数讲解
Spark Streaming中的操作函数讲解 根据根据Spark官方文档中的描述,在Spark Streaming应用中,一个DStream对象可以调用多种操作,主要分为以下几类 Transform ...
随机推荐
- [Oracle] 使用触发器实现IP限制用户登录
在Oracle里,不像MySQL那样方便,可以直接在用户上进行IP限制,Oracle要实现用户级别的IP限制,可以使用触发器来迂回实现,下面是一个触发器的例子: create or replace t ...
- [RxJS] Refactoring Composable Streams in RxJS, switchMap()
Refactoring streams in RxJS is mostly moving pieces of smaller streams around. This lessons demonstr ...
- Android 打造任意层级树形控件 考验你的数据结构和设计
转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/40212367,本文出自:[张鸿洋的博客] 1.概述 大家在项目中或多或少的可能会 ...
- Picasso – Android系统的图片下载和缓存类库
Picasso – Android系统的图片下载和缓存类库 Picasso 是Square开源的一个用于Android系统下载和缓存图片的项目.该项目和其他一些下载图片项目的主要区别之一是:使用4.0 ...
- Linux命令vi/vim编辑
一.vi的基本概念基本上vi可以分为三种状态,分别是命令模式(command mode).插入模式(Insert mode)和底行模式(last line mode),各模式的功能区分如下:a) 命令 ...
- .net 判断日期格式yyyy-MM-dd hh:MM:ss的正则表达式
加上引用: using System.Text.RegularExpressions; /// <summary> /// 检查字符串是否是日期格式 /// </sum ...
- C#调用进程
Process process = new Process(); process.StartInfo.FileName = "123.exe"; process.StartInfo ...
- setTimeout与setInterval方法的区别
setTimeout与setInterval方法的区别 setTimeout()用于设定在指定的时间之后执行对应的函数或代码.,在全局作用域下执行 setTimeout(code,time[,args ...
- PHP命名空间(Namespace)的使用详解(转)
对于命名空间,官方文档已经说得很详细[查看],我在这里做了一下实践和总结. 命名空间一个最明确的目的就是解决重名问题,PHP中不允许两个函数或者类出现相同的名字,否则会产生一个致命的错误.这种情况下只 ...
- WordPress插件制作教程(七): 插件函数之过滤器(Filter)函数
上一篇对插件函数之动作(Action)函数做了下介绍,这篇在介绍下过滤器(Filters). 过滤器是一类函数,WordPress执行传递和处理数据的过程中,在针对这些数据做出某些动作之前的特定运行( ...