
Spark 实践——音乐推荐和 Audioscrobbler 数据集
本文基于《Spark 高级数据分析》第3章 用音乐推荐和Audioscrobbler数据
完整代码见 https://github.com/libaoquan95/aasPractice/tree/master/c3/recommend
1.获取数据集
本 章 示 例 使 用 Audioscrobbler 公 开 发 布 的 一 个 数 据 集。 Audioscrobbler 是 last.fm 的 第一个音乐推荐系统。 last.fm 创建于 2002 年,是最早的互联网流媒体广播站点之一。
Audioscrobbler 数据集有些特别, 因为它只记录了播放数据,主要的数据集在文件 user_artist_data.txt 中,它包含 141 000 个用户和 160 万个艺术家,记录了约 2420 万条用户播放艺术家歌曲的信息,其中包括播放次
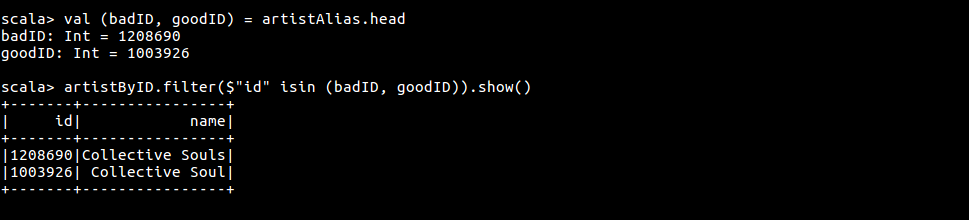
数信息。数据集在 artist_data.txt 文件中给出了每个艺术家的 ID 和对应的名字。请注意,记录播放信息时,客户端应用提交的是艺术家的名字。名字如果有拼写错误,或使用了非标准的名称, 事后才能被发现。 比如,“The Smiths”“Smiths, The”和“the smiths”看似代表不同艺术家的 ID,但它们其实明显是指同一个艺术家。因此,为了将拼写错误的艺术家 ID 或ID 变体对应到该艺术家的规范 ID,数据集提供了 artist_alias.txt 文件。
下载地址:
- http://www-etud.iro.umontreal.ca/~bergstrj/audioscrobbler_data.html (原书地址,已失效)
- https://github.com/libaoquan95/aasPractice/tree/master/c3/profiledata_06-May-2005(数据集大于git上传限制,分卷压缩)
2.数据处理
加载数据集
val dataDirBase = "profiledata_06-May-2005/"

val rawUserArtistData = sc.read.textFile(dataDirBase + "user_artist_data.txt")

val rawArtistData = sc.read.textFile(dataDirBase + "artist_data.txt")

val rawArtistAlias = sc.read.textFile(dataDirBase + "artist_alias.txt")

rawUserArtistData.show()

rawArtistData.show()

rawArtistAlias.show()
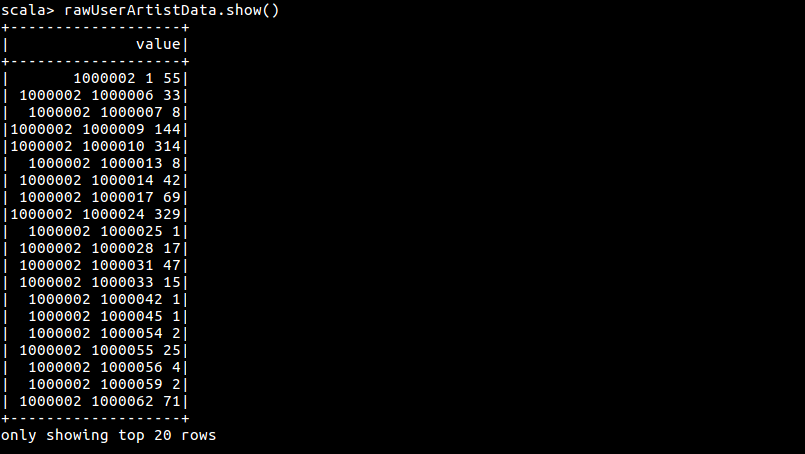
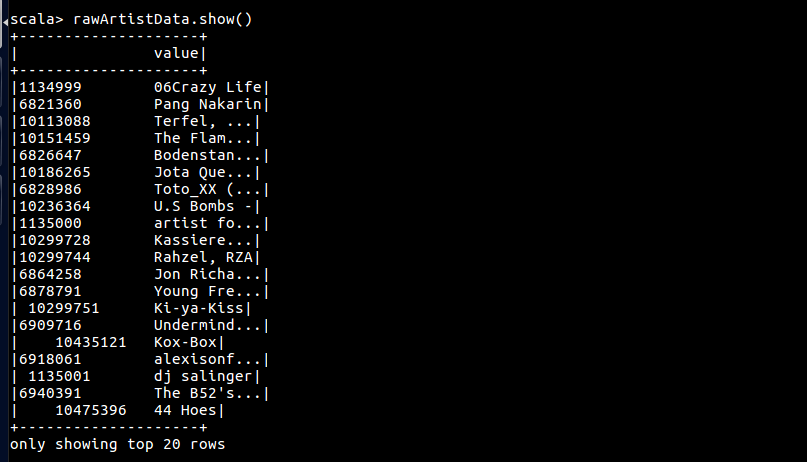
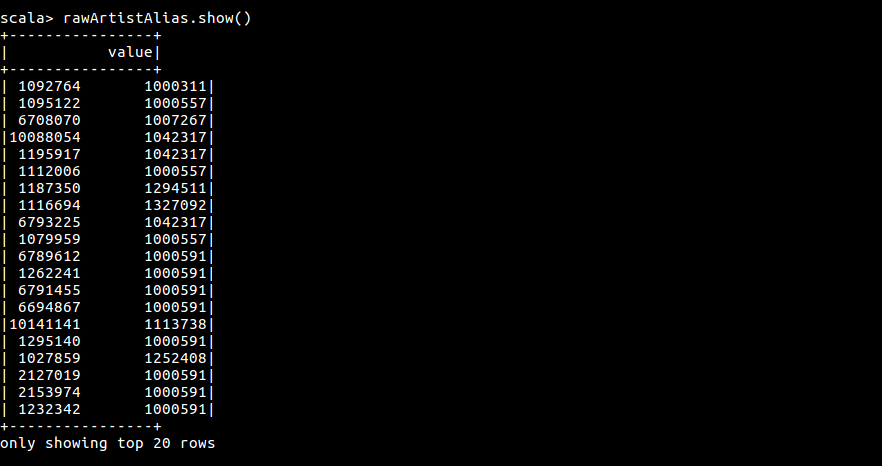
格式化数据集,转换成 DataFrame
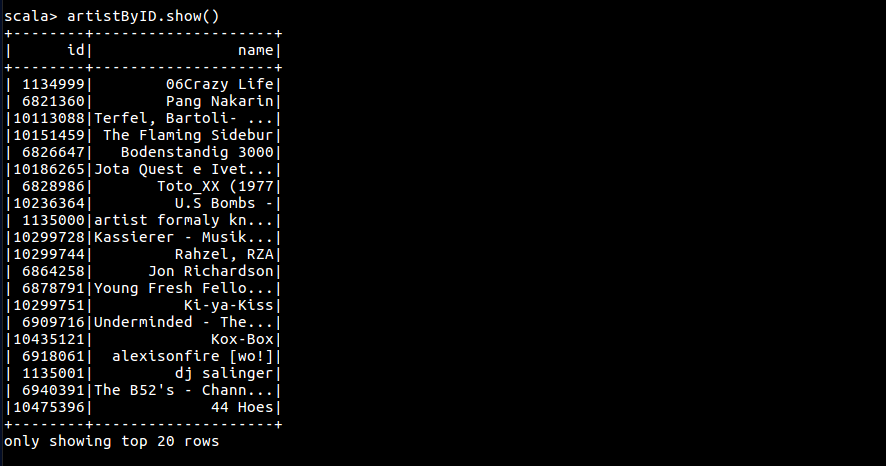
val artistByID = rawArtistData.flatMap { line =>

  val (id, name) = line.span(_ != '\t')

  if (name.isEmpty()){

    None

  } else {

    try {

      Some((id.toInt, name.trim))

    } catch{

      case _: NumberFormatException => None

    }

  }

}.toDF("id", "name").cache()

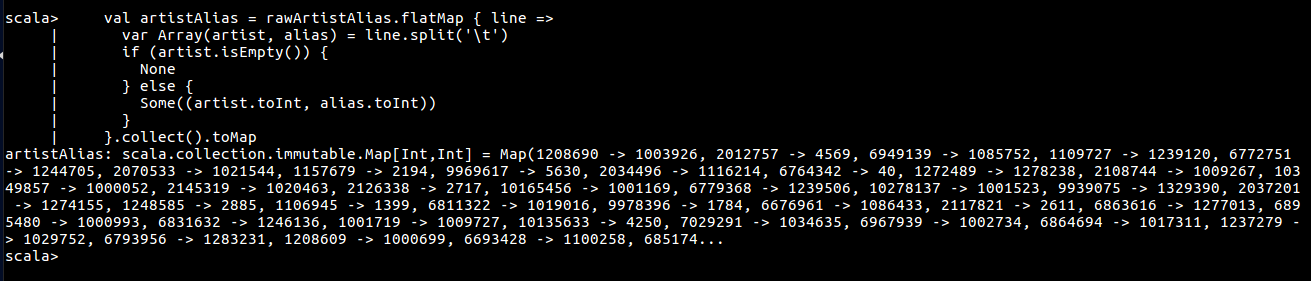
val artistAlias = rawArtistAlias.flatMap { line =>

  var Array(artist, alias) = line.split('\t')

  if (artist.isEmpty()) {

    None

  } else {

    Some((artist.toInt, alias.toInt))

  }

}.collect().toMap

val bArtistAlias = sc.sparkContext.broadcast(artistAlias)

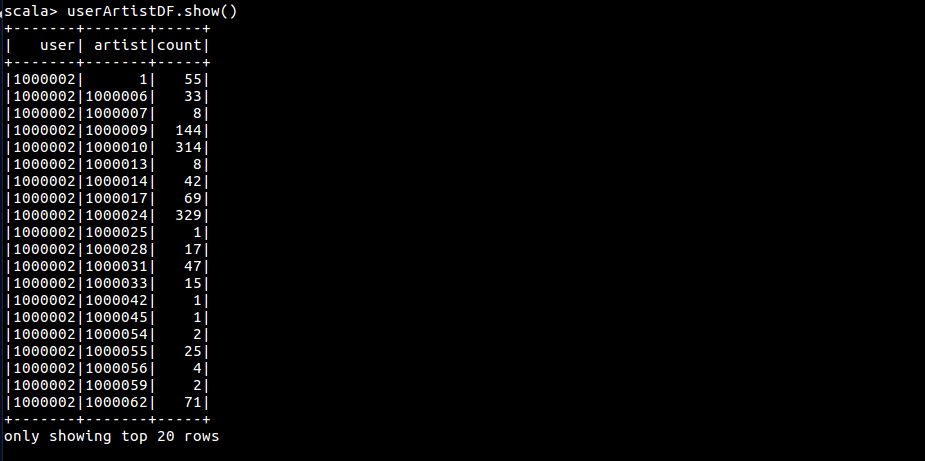
val userArtistDF = rawUserArtistData.map { line =>

  val Array(userId, artistID, count) = line.split(' ').map(_.toInt)

  val finalArtistID = bArtistAlias.value.getOrElse(artistID, artistID)

  (userId, artistID, count)

}.toDF("user", "artist", "count").cache()
查看 artist 别名与实名
val (badID, goodID) = artistAlias.head

artistByID.filter($"id" isin (badID, goodID)).show()
3.利用 Spark MLlib 进行推荐
Spark MLlib 使用 ALS (交替最小二乘) 来实现协同过滤算法,该模型只需传入三元组 (用户ID, 物品ID, 评分) 就可以进行计算,需要注意,用户ID 和 物品ID必须是整型数据。
val Array(trainData, cvData) = userArtistDF.randomSplit(Array(0.9, 0.1))

val model = new ALS().

    setSeed(Random.nextLong()).

    setImplicitPrefs(true).

    setRank(10).

    setRegParam(0.01).

    setAlpha(1.0).

    setMaxIter(5).

    setUserCol("user").

    setItemCol("artist").

    setRatingCol("count").

    setPredictionCol("prediction").

    fit(trainData)
推荐模型已经搭建完成,不过 Spark MLlib 每次只能对单个用户进行推荐,无法进行单次的全局推荐。
val userId = 2093760

val topN = 10

val toRecommend = model.itemFactors.

  select($"id".as("artist")).

  withColumn("user", lit(userId))

val topRecommendations  = model.transform(toRecommend).

  select("artist", "prediction").

  orderBy($"prediction".desc).

  limit(topN)

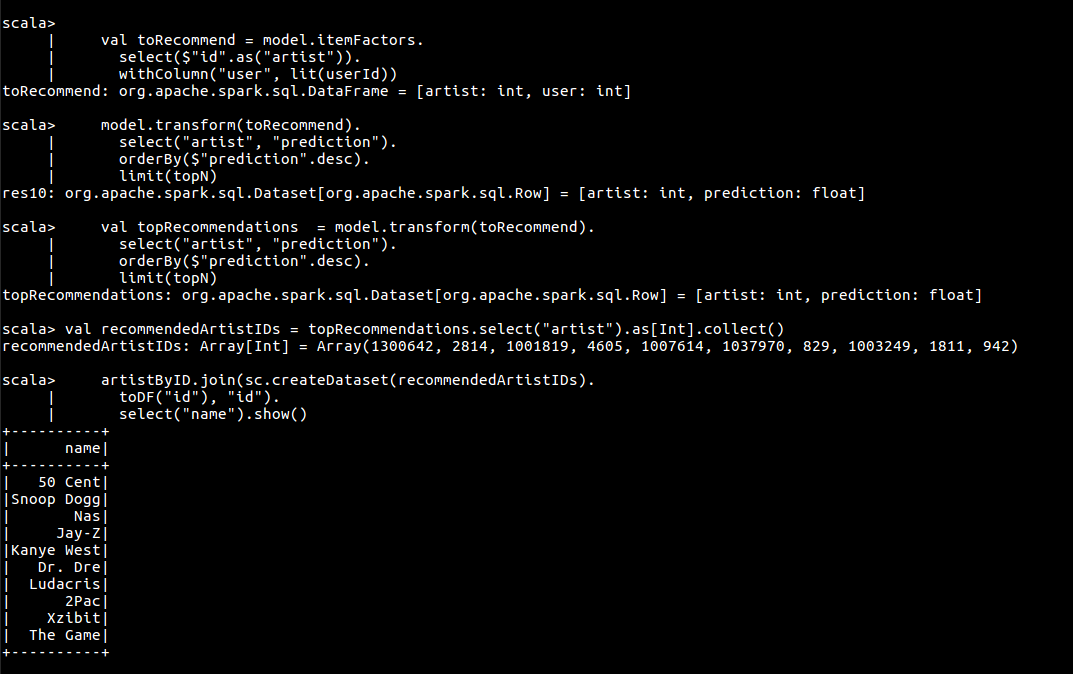
// 查看推荐结果

val recommendedArtistIDs = topRecommendations.select("artist").as[Int].collect()

artistByID.join(sc.createDataset(recommendedArtistIDs).

  toDF("id"), "id").

  select("name").show()
Spark 实践——音乐推荐和 Audioscrobbler 数据集的更多相关文章
- 音乐推荐与Audioscrobbler数据集
1. Audioscrobbler数据集 数据下载地址: http://www.iro.umontreal.ca/~lisa/datasets/profiledata_06-May-2005.tar. ...
- 3-Spark高级数据分析-第三章 音乐推荐和Audioscrobbler数据集
偏好是无法度量的. 相比其他的机器学习算法,推荐引擎的输出更直观,更容易理解. 接下来三章主要讲述Spark中主要的机器学习算法.其中一章围绕推荐引擎展开,主要介绍音乐推荐.在随后的章节中我们先介绍S ...
- ALS音乐推荐(上)
本篇文章的开头笔者提出一个疑问,何为数据科学,数据科学是做什么的?大家带着这个疑问去读接下来的这篇音乐推荐的公众号. 从经验上讲,推荐引擎属于大规模机器学习,在日常购物中大家或许深有体会,比如:你在淘 ...
- Recommending music on Spotify with deep learning 采用深度学习算法为Spotify做基于内容的音乐推荐
本文参考http://blog.csdn.net/zdy0_2004/article/details/43896015译文以及原文file:///F:/%E6%9C%BA%E5%99%A8%E5%AD ...
- 个推 Spark实践教你绕过开发那些“坑”
Spark作为一个开源数据处理框架,它在数据计算过程中把中间数据直接缓存到内存里,能大大提高处理速度,特别是复杂的迭代计算.Spark主要包括SparkSQL,SparkStreaming,Spark ...
- Spark 实践——基于 Spark MLlib 和 YFCC 100M 数据集的景点推荐系统
1.前言 上接 YFCC 100M数据集分析笔记 和 使用百度地图api可视化聚类结果, 在对 YFCC 100M 聚类出的景点信息的基础上,使用 Spark MLlib 提供的 ALS 算法构建推荐 ...
- 推荐系统实践 0x05 推荐数据集MovieLens及评测
推荐数据集MovieLens及评测 数据集简介 MoiveLens是GroupLens Research收集并发布的关于电影评分的数据集,规模也比较大,为了让我们的实验快速有效的进行,我们选取了发布于 ...
- MongoDB,HDFS, Spark to 电影推荐
http://www.infoq.com/cn/news/2014/12/mongdb-spark-movie-recommend MovieWeb是一个电影相关的网站,它提供的功能包括搜索电影信息. ...
- Spark实践 -- 性能优化基础
性能调优相关的原理讲解.经验总结: 掌握一整套Spark企业级性能调优解决方案:而不只是简单的一些性能调优技巧. 针对写好的spark作业,实施一整套数据倾斜解决方案:实际经验中积累的数据倾斜现象的表 ...
随机推荐
- Actor模式初步入门
Actor模型概念 Actor模型为并行而生,简单说是未解决高并发的一种编程思路.在Actor模型中,主角是Actor,类似一种worker,Actor彼此之间直接发送消息,不需要经过什么中介,消息是 ...
- Kafka学习之路 (五)Kafka在zookeeper中的存储
一.Kafka在zookeeper中存储结构图 二.分析 2.1 topic注册信息 /brokers/topics/[topic] : 存储某个topic的partitions所有分配信息 [zk: ...
- Win10环境Tensorflow-GPU13.1/JupyterNotebook的安装
参考 : Anaconda Tensorflow GPU 版本的安装问题 https://blog.csdn.net/u010977034/article/details/62038698 Windo ...
- VC基于单文档OpenGL框架
本文是在VC6.0的环境下,运用MFC实现的OpenGL最基本框架,需要简单了解MFC编程(会在VC6.0里创建MFC单文档应用程序就行),甚至不必了解OpenGL的知识.以下是具体的步骤. 1.创建 ...
- OpenCV——KAZE、AKAZE特征检测、匹配与对象查找
AKAZE是KAZE的加速版 特征点查找和绘制:把surf中的surf改成KAZE或AKAZE即可 #include <opencv2/opencv.hpp> #include < ...
- vector使用小结
1.创建vector容器: std::vector<int> data; std::vector<int> data(20);大小20,自动赋值为0 std::vector&l ...
- C语言程序设计II—第一周教学
第一周教学总结(25/2-3/3) 教学内容 开学谈心 测验数据类型.运算符与表达式的自学情况,并讲解测验题目 第七章 数组 7.1 一维数组 课前准备 在蓝墨云发布资源:回顾数据类型与表达式测试活动 ...
- Android 网络请求超时处理方案
以用户登录为例介绍用户访问网络时的请求超时处理的两种方法: 1)使用android提供的工具类AsyncTask类,此类提供了一个AsyncTask.execute().get(timeout, un ...
- ASP.NET Core的Kestrel服务器(转载)
Kestrel是一个基于libuv的跨平台ASP.NET Core web服务器,libuv是一个跨平台的异步I/O库.ASP.NET Core模板项目使用Kestrel作为默认的web服务器.Kes ...
- SVN之 trunk, branches and tags意义
--简单的对照 SVN的工作机制在某种程度上就像一颗正在生长的树: 一颗有树干和很多分支的树 分支从树干生长出来.而且细的分支从相对较粗的树干中长出 一棵树能够仅仅有树干没有分支(可是这样的情况不会持 ...