
Python使用Tabula提取PDF表格数据
今天遇到一个批量读取pdf文件中表格数据的需求,样式大体是以下这样:
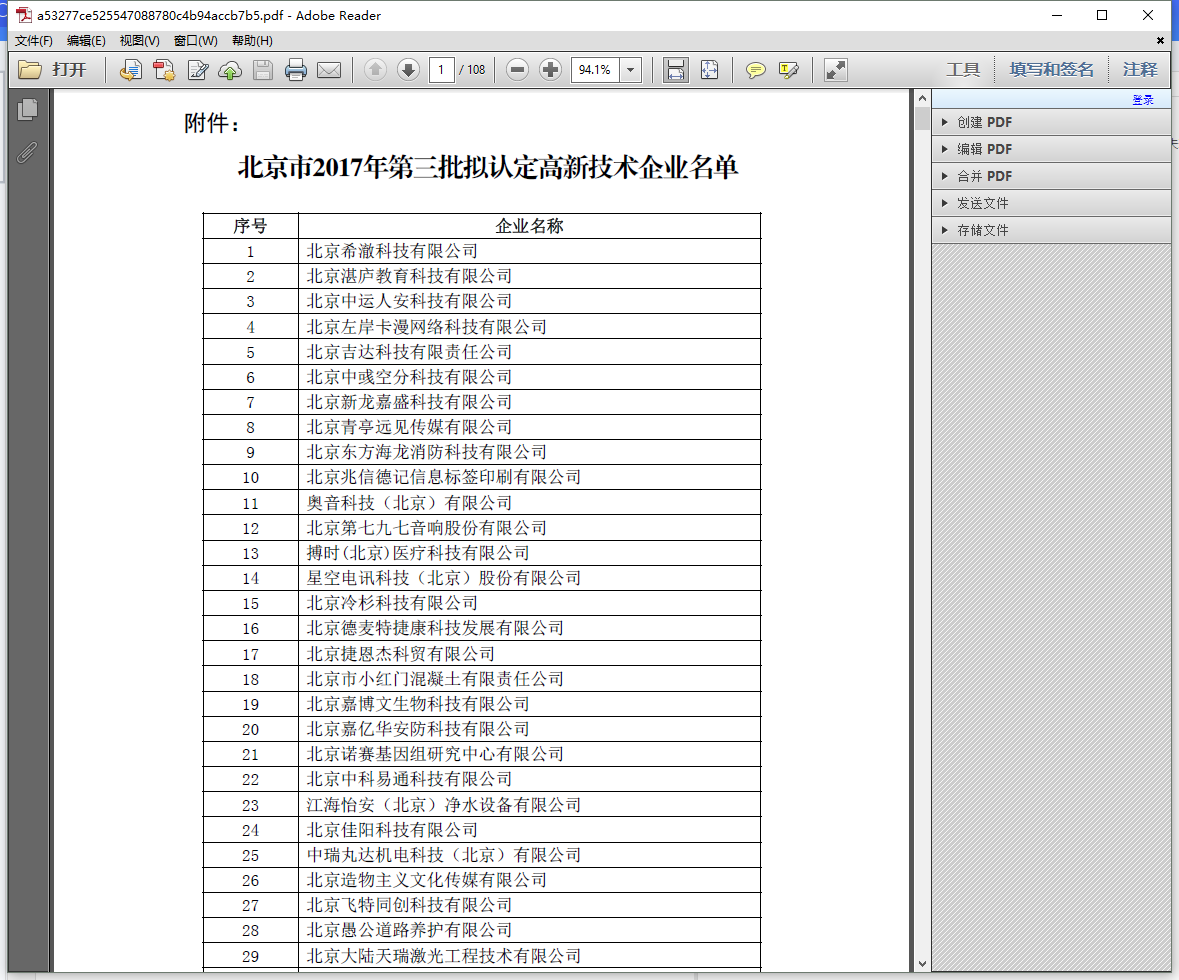
python读取PDF无非就是三种方式(我所了解的),pdfminer、pdf2htmlEX 和 Tabula。综合考虑后,选择了最后一种。下面对三种方式分别介绍:
pdfminer
该方式从网上搜索的结果是,可以提取pdf文本数据,但是提取后表格信息就乱了。所以本人没有亲自实验,就果断放弃了实验该方法。如果只是提取pdf里面的文本内容,该方式可能是比较合适的。
pdf2htmlEX
该方式是通过把pdf格式转换成html格式,然后再提取信息的方法。
Github: https://github.com/coolwanglu/pdf2htmlEX
需先下载pdf2htmlEX可执行程序,下载地址:https://github.com/coolwanglu/pdf2htmlEX/wiki/Download。
#-*- conding: utf-8 -*-

import subprocess

subprocess.call('"D:\Program Files (x86)\pdf2htmlEX-win32-0.14.6-upx-with-poppler-data\pdf2htmlEX.exe"  --dest-dir E:\\test\extract\\2017gq\\out E:\\test\extract\\2017gq\\a53277ce525547088780c4b94accb7b5.pdf', shell=True)
执行以上代码,会在指定目录 E:\test\extract\2017gq\out 下生成对应html文件,浏览器中查看效果:
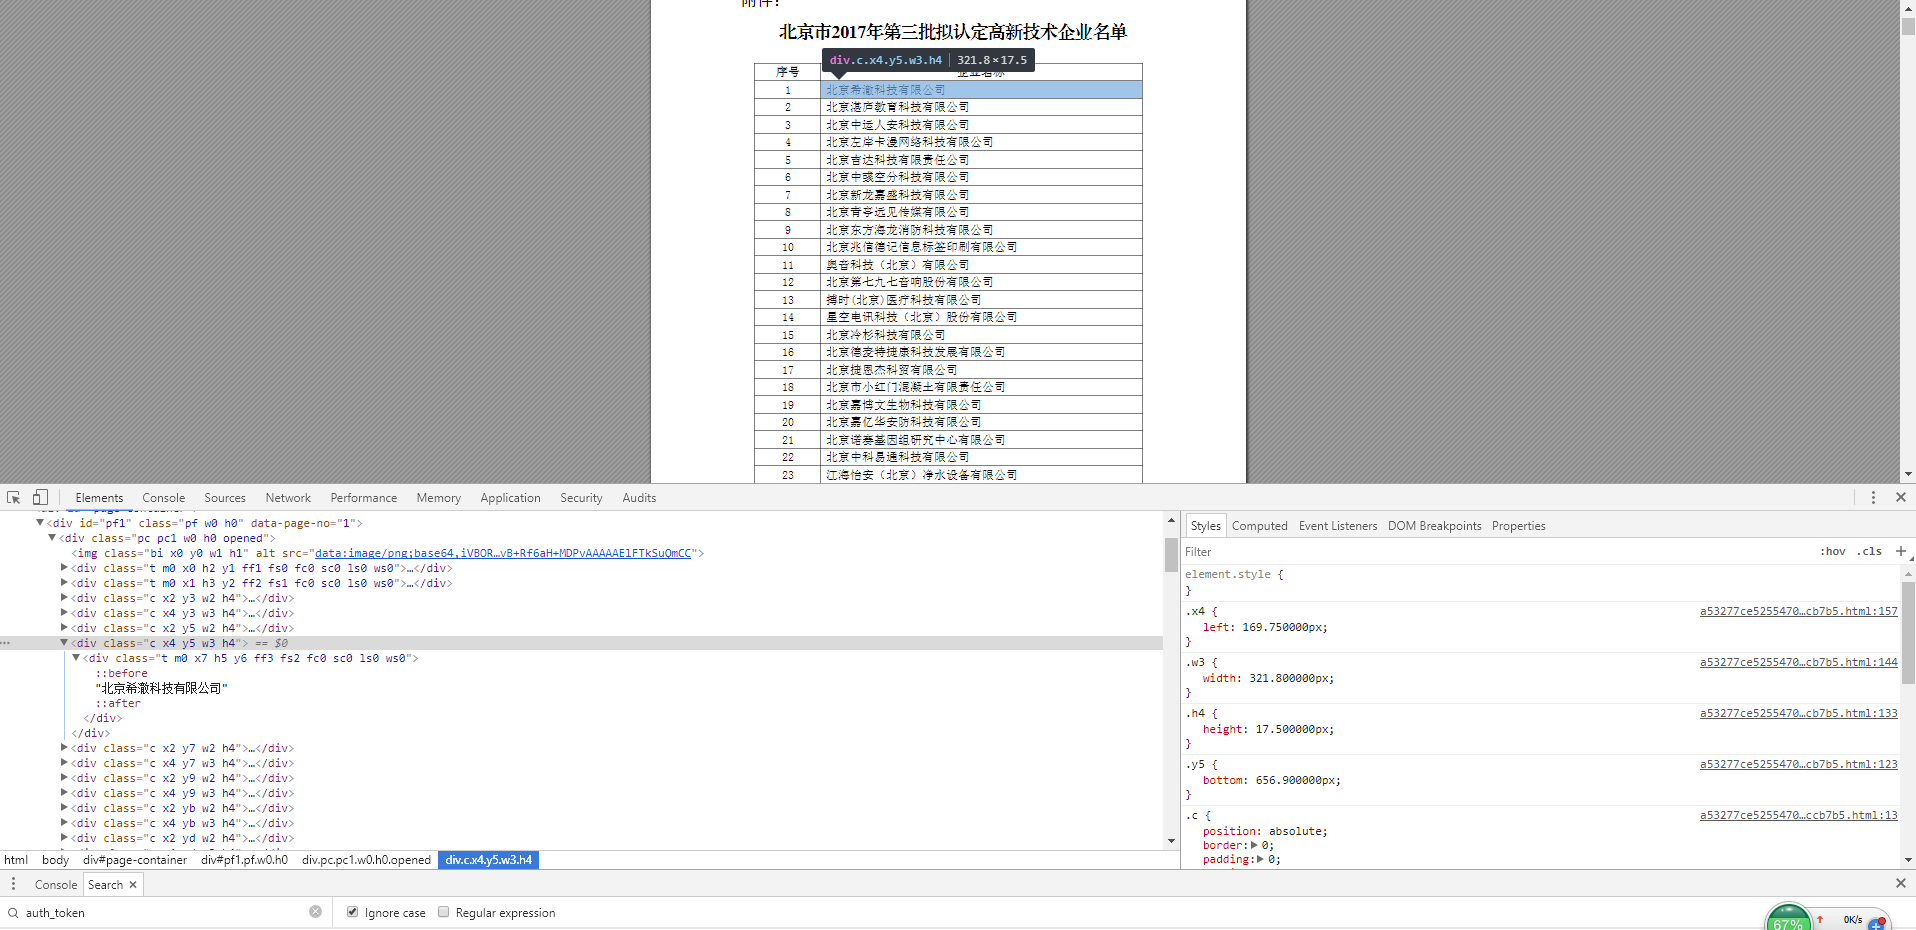
可以看到整体转换的效果非常不错,但是转换后的标签没有特点,使数据的提取变得非常困难。多番尝试后,感觉该方法不够通用,没法解决我的需求。也许对于单纯的pdf转html,该方式可能是最好的选择。
Tabula
Tabula是专门用来提取PDF表格数据的,同时支持PDF导出为CSV、Excel格式。
官网: http://tabula.technology/
Github: https://github.com/chezou/tabula-py
首先安装tabula-py: pip install tabula-py
tabula-py依赖库包括java、pandas、numpy,所以需保证运行环境中安装了这些库。
#-*- conding: utf-8 -*-

import tabula

df = tabula.read_pdf("E:\\test\\extract\\2017gq\\a53277ce525547088780c4b94accb7b5.pdf", encoding='gbk', pages='all')

print(df)

for indexs in df.index:

    # 遍历打印企业名称

    print(df.loc[indexs].values[1].strip())
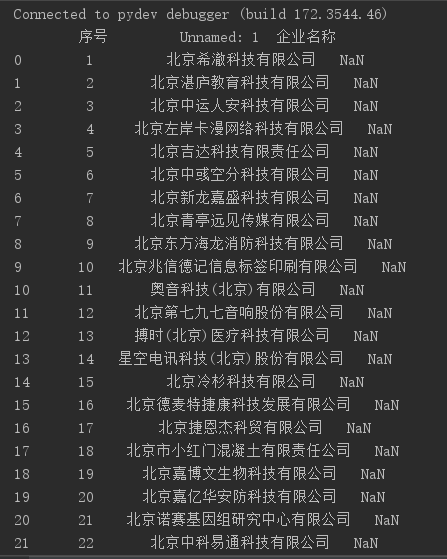
执行以上代码,成功打印出表格中的所有企业名称,查看打印的 df 的结构,如下图:
总结
以上三种方式中,最后一种方式完美的解决了我的从PDF表格中提取数据的需求,希望能抛砖引玉,大家在使用时选择最适合自己的方法,如有介绍不当之处,望留言中指正,谢过。
Python使用Tabula提取PDF表格数据的更多相关文章
- 利用python第三方库提取PDF文件的表格内容
小爬最近接到一个棘手任务:需要提取手机话费电子发票PDF文件中的数据.接到这个任务的第一时间,小爬决定搜集各个地区各个时间段的电子发票文件,看看其中的差异点.粗略统计下来,PDF文件的表格框架是统一的 ...
- python提取分析表格数据
#/bin/python3.4# -*- coding: utf-8 -*- import xlrd def open_excel(file="file.xls"): try: d ...
- Python利用xlutils统计excel表格数据
假设有像上这样一个表格,里面装满了各式各样的数据,现在要利用模板对它进行统计每个销售商的一些数据的总和.模板如下: 代码开始: 1 #!usr/bin/python3 2 # -*-coding=ut ...
- python:字符串中提取特定的数据
在日志文件中有一大堆,格式相同的文本,需要提取出接口耗时的时间 >>> 运单号:71742507538566,快递100接口耗时:8,返回结果:[{"lengthPre&q ...
- 个人永久性免费-Excel催化剂功能第88波-批量提取pdf文件信息(图片、表格、文本等)
日常办公场合中,除了常规的Excel.Word.PPT等文档外,还有一个不可忽略的文件格式是pdf格式,而对于想从pdf文件中获取信息时,常规方法将变得非常痛苦和麻烦.此篇给大家送一pdf文件提取信息 ...
- 另类爬虫:从PDF文件中爬取表格数据
简介 本文将展示一个稍微不一样点的爬虫. 以往我们的爬虫都是从网络上爬取数据,因为网页一般用HTML,CSS,JavaScript代码写成,因此,有大量成熟的技术来爬取网页中的各种数据.这次, ...
- python提取网页表格并保存为csv
0. 1.参考 W3C HTML 表格 表格标签 表格 描述 <table> 定义表格 <caption> 定义表格标题. <th> 定义表格的表头. <tr ...
- 办公室文员必备python神器,将PDF文件表格转换成excel表格!
[阅读全文] 第三方库说明 # PDF读取第三方库 import pdfplumber # DataFrame 数据结果处理 import pandas as pd 初始化DataFrame数据对象 ...
- 干货--Excel的表格数据的一般处理和常用python模块。
写在前面: 本文章的主要目的在于: 介绍了python常用的Excel处理模块:xlwt,xlrd,xllutils,openpyxl,pywin32的使用和应用场景. 本文只针对于Excel表中常用 ...
随机推荐
- C语言之基本算法37—数组最大值及其位置
//数组运算 /* ================================================================== 题目:查找数组的最大元素,并输出其位置和值! ...
- 为什么MOBA、“吃鸡”游戏不推荐用tcp协议——实测数据
欢迎大家前往云加社区,获取更多腾讯海量技术实践干货哦~ 作者:腾讯云游戏行业资深架构师 余国良 MOBA类和"吃鸡"游戏为什么对网络延迟要求高? 我们知道,不同类型的游戏因为玩法. ...
- nginx+redis缓存微信的token数据
上一篇文章我们讲了如何在负载均衡的项目中使用redis来缓存session数据,戳这里. 我们在项目的进展过程中,不仅需要缓存session数据,有时候还需要缓存一些别的数据,比如说,微信的acces ...
- 用keras做SQL注入攻击的判断
本文是通过深度学习框架keras来做SQL注入特征识别, 不过虽然用了keras,但是大部分还是普通的神经网络,只是外加了一些规则化.dropout层(随着深度学习出现的层). 基本思路就是喂入一堆数 ...
- 单源最短路径(1):Dijkstra 算法
一:背景 Dijkstra 算法(中文名:迪杰斯特拉算法)是由荷兰计算机科学家 Edsger Wybe Dijkstra 提出.该算法常用于路由算法或者作为其他图算法的一个子模块.举例来说,如果图中的 ...
- redis hash结构 遍历某一个key下所有的(field,values)的方法
本文同时发表在https://github.com/zhangyachen/zhangyachen.github.io/issues/95 redis的hash结构中存储了如下的数据: $input ...
- Ryz的鬼题
蚂蚁(ant)[题目描述] 小 R 种了一棵苹果树,这棵树上有 n 个节点(标号从 0 到 n-1),有 n-1 条树枝连接这 n 个节点,这 n 个节点相互连通.每条树枝的长度为 1. 苹果树 ...
- bzoj 3142: [Hnoi2013]数列
Description 小T最近在学着买股票,他得到内部消息:F公司的股票将会疯涨.股票每天的价格已知是正整数,并且由于客观上的原因,最多只能为N.在疯涨的K天中小T观察到:除第一天外每天的股价都比前 ...
- 用js筛选数据排序
题目 参考以下示例代码,页面加载后,将提供的空气质量数据数组,按照某种逻辑(比如空气质量大于60)进行过滤筛选,最后将符合条件的数据按照一定的格式要求显示 <!DOCTYPE html> ...
- ES6 正则的扩展
1. RegExp构造函数 ES5中,RegExp构造函数的参数: 参数是字符串,这时第二个参数表示正则表达式的修饰符(flag) 参数是一个正则表示式,这时会返回一个原有正则表达式的拷贝.但是,ES ...