
第三百三十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—Scrapy启动文件的配置—xpath表达式
第三百三十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—Scrapy启动文件的配置—xpath表达式
我们自定义一个main.py来作为启动文件
main.py
#!/usr/bin/env python

# -*- coding:utf8 -*-

from scrapy.cmdline import execute  #导入执行scrapy命令方法

import sys

import os

sys.path.append(os.path.join(os.getcwd())) #给Python解释器,添加模块新路径 ,将main.py文件所在目录添加到Python解释器

execute(['scrapy', 'crawl', 'pach', '--nolog'])  #执行scrapy命令
爬虫文件
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request

import urllib.response

from lxml import etree

import re

class PachSpider(scrapy.Spider):

    name = 'pach'

    allowed_domains = ['blog.jobbole.com']

    start_urls = ['http://blog.jobbole.com/all-posts/']

    def parse(self, response):

        pass
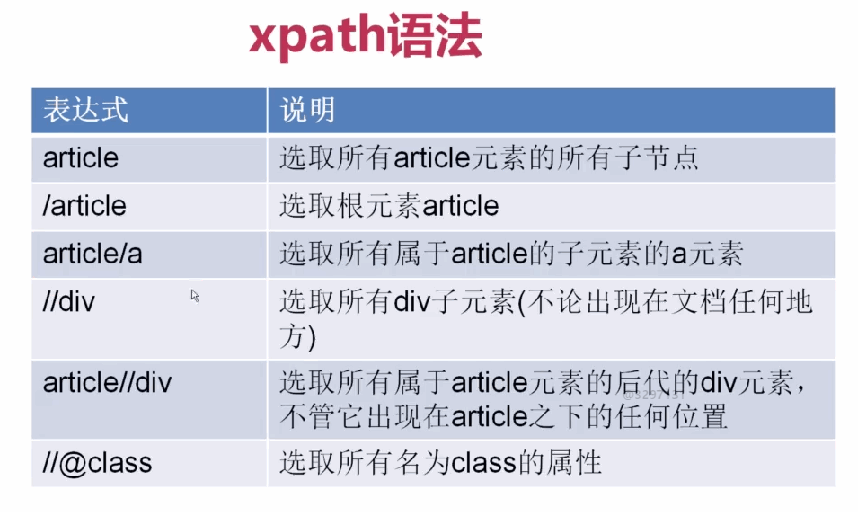
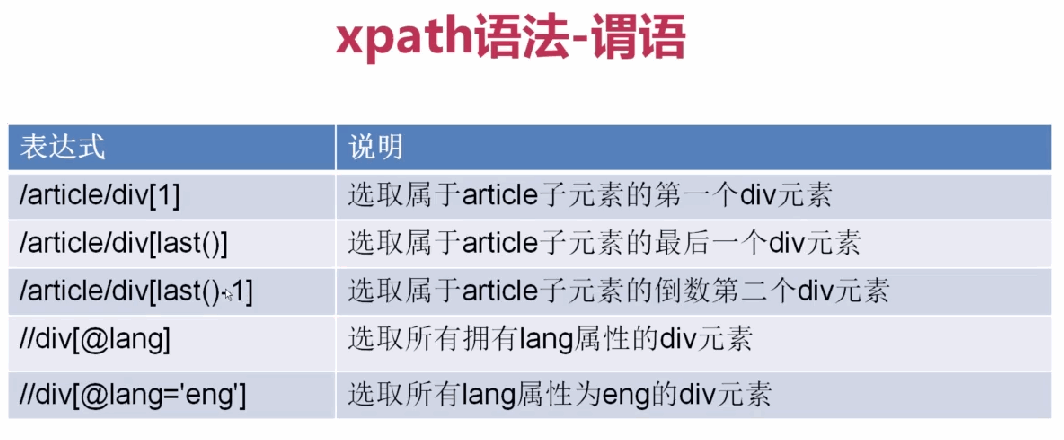
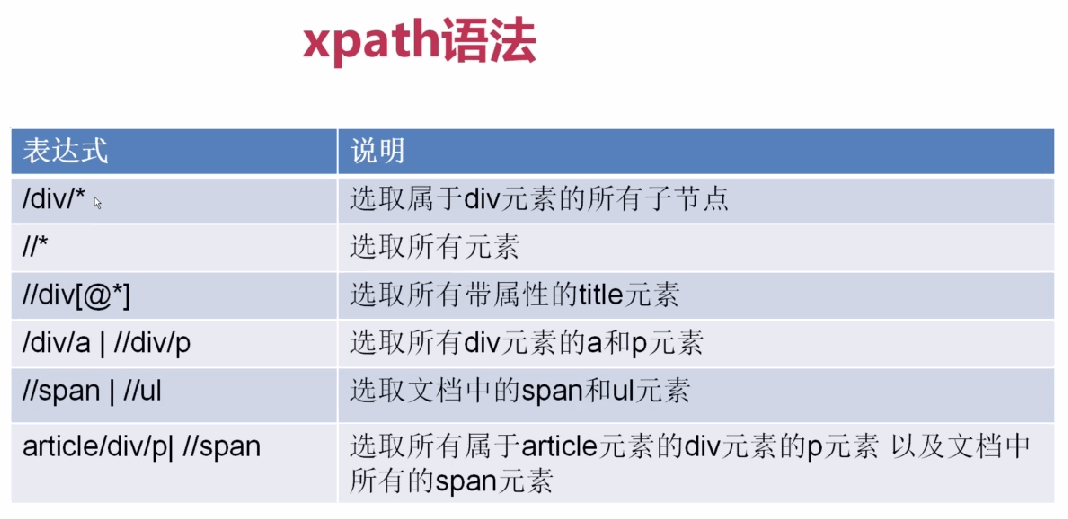
xpath表达式
1、
2、
3、
基本使用
allowed_domains设置爬虫起始域名
start_urls设置爬虫起始url地址
parse(response)默认爬虫回调函数,response返回的是爬虫获取到的html信息对象,里面封装了一些关于htnl信息的方法和属性
responsehtml信息对象下的方法和属性
response.url获取抓取的rul
response.body获取网页内容
response.body_as_unicode()获取网站内容unicode编码
xpath()方法,用xpath表达式过滤节点
extract()方法,获取过滤后的数据,返回列表
# -*- coding: utf-8 -*-

import scrapy

class PachSpider(scrapy.Spider):

    name = 'pach'

    allowed_domains = ['blog.jobbole.com']

    start_urls = ['http://blog.jobbole.com/all-posts/']

    def parse(self, response):

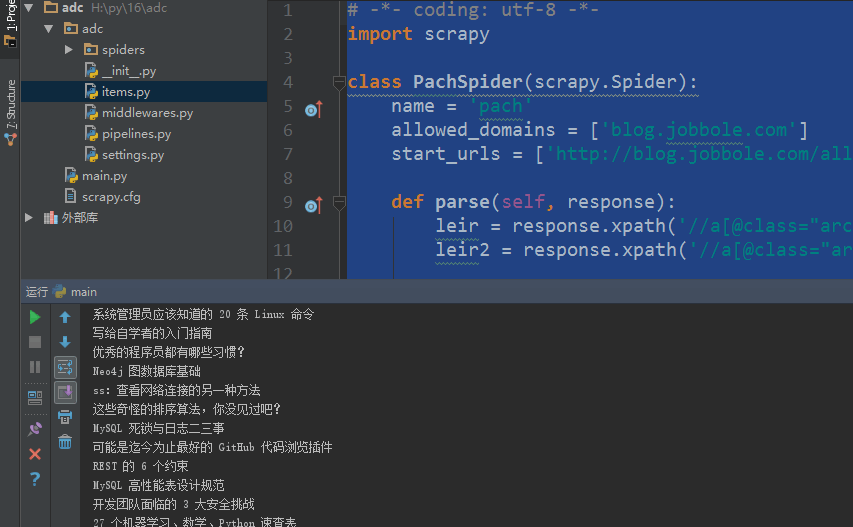
        leir = response.xpath('//a[@class="archive-title"]/text()').extract()  #获取指定标题

        leir2 = response.xpath('//a[@class="archive-title"]/@href ').extract() #获取指定url

        print(response.url)    #获取抓取的rul

        print(response.body)   #获取网页内容

        print(response.body_as_unicode())  #获取网站内容unicode编码

        for i in leir:

            print(i)

        for i in leir2:

            print(i)
第三百三十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—Scrapy启动文件的配置—xpath表达式的更多相关文章
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
- 第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中
第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中,判断URL是否重复 布隆过滤器(Bloom Filter)详 ...
- 第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启 scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的UR ...
- 第三百七十九节,Django+Xadmin打造上线标准的在线教育平台—xadmin的安装
第三百七十九节,Django+Xadmin打造上线标准的在线教育平台—xadmin的安装 xadmin介绍 xadmin是基于Django的admin开发的更完善的后台管理系统,页面基于Bootstr ...
- 第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理—用户代理和ip代理结合应用
第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理 使用IP代理 ProxyHandler()格式化IP,第一个参数,请求目标可能是http或者https,对应设置build_opener ...
- 第三百八十九节,Django+Xadmin打造上线标准的在线教育平台—列表筛选结合分页
第三百八十九节,Django+Xadmin打造上线标准的在线教育平台—列表筛选结合分页 根据用户的筛选条件来结合分页 实现原理就是,当用户点击一个筛选条件时,通过get请求方式传参将筛选的id或者值, ...
- 第三百三十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—深度优先与广度优先原理
第三百三十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—深度优先与广度优先原理 网站树形结构 深度优先 是从左到右深度进行爬取的,以深度为准则从左到右的执行(递归方式实现)Scrapy默认 ...
- 第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP
第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP 设置代理ip只需要,自定义一个中间件,重写process_request方法, request ...
- 第三百四十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy模拟登陆和知乎倒立文字验证码识别
第三百四十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy模拟登陆和知乎倒立文字验证码识别 第一步.首先下载,大神者也的倒立文字验证码识别程序 下载地址:https://gith ...
随机推荐
- Android-一只手指滑动View,另一只手指按Home键,重新进入后View状态无法更新的问题
上午测试报了一个bug:说是一只手指拖动虚拟摇杆上的View滑块不松,另一只手指点击Home键将App压后台,重新进入的时候,View滑块卡死了. 刚开始看到这个问题感觉很奇怪,因为正常情况下,手指离 ...
- 每日英语:5 Things to Know About Missing Malaysia Airlines Flight and Air Safety
Malaysia Airlines Flight MH370, with 239 people aboard, lost contact early Saturday with the airline ...
- excel 添加换行符,去除换行符:
excel 中添加换行符: :alt+enter 去掉excel中的换行符有三种方法: 注:解决过程中翻阅其他博客,看到如下方式: 1.看到有的说全选后“取消自动换行”,保存后,再打开,依然存在换行符 ...
- 将map中的查询参数拼装到URL路径中
被调接口的URL路径: //被调接口url String apiUrl = "http://api.open.xxxxxx.com/implatform/interview/send?acc ...
- sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类
sbt打包Scala写的Spark程序,打包正常,提交运行时提示找不到对应的类 详述 使用sbt对写的Spark程序打包,过程中没有问题 spark-submit提交jar包运行提示找不到对应的类 解 ...
- Mac使用pyenv安装Python出现The Python zlib extension was not compiled. Missing the zlib错误
Mac使用pyenv安装Python出现The Python zlib extension was not compiled. Missing the zlib错误 参考这里,详细如下: On Mac ...
- SAP BI vs. Oracle BI
对比Oracle BI产品和SAP BI 产品,做一些简单的产品功能比较,经供参考. 这里把SAP和Oracle同类的产品放在一行,用于比较. SAP BI 特点 Oracle BI 特点 BW 和S ...
- Android.mk简介
http://www.cnblogs.com/hnrainll/archive/2012/12/18/2822711.html Android.mk文件是GNU Makefile的一小部分,它用来对A ...
- Airlaunch 快捷设置代码分享
Airlaunch 快捷设置代码分享设置:prefs:root=SETTING蜂窝网络:prefs:root=MOBILE_DATA_SETTINGS_IDWIFI:prefs:root=WIFI定位 ...
- window.opener方法的使用 js 跨域
用到了这个方法: window.opener.location.reload() 与 window.opener.location.href=window.opener.location.href 都 ...