
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的URL不在爬取
实现暂停与重启记录状态
1、首先cd进入到scrapy项目里
2、在scrapy项目里创建保存记录信息的文件夹
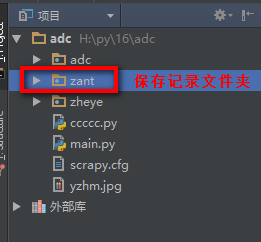
3、执行命令:
scrapy crawl 爬虫名称 -s JOBDIR=保存记录信息的路径
如:scrapy crawl cnblogs -s JOBDIR=zant/001
执行命令会启动指定爬虫,并且记录状态到指定目录
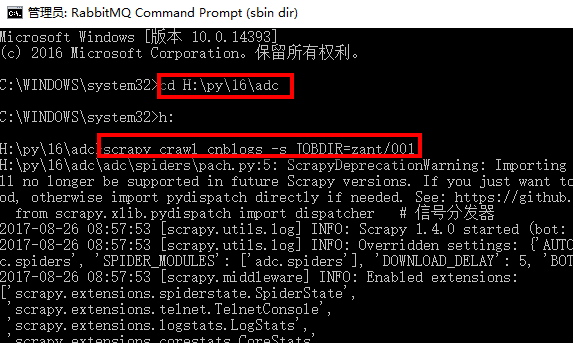
爬虫已经启动,我们可以按键盘上的ctrl+c停止爬虫
停止后我们看一下记录文件夹,会多出3个文件
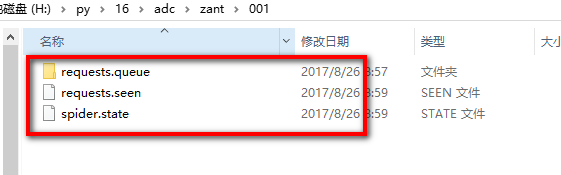
其中的requests.queue文件夹里的p0文件就是URL记录文件,这个文件存在就说明还有未完成的URL,当所有URL完成后会自动删除此文件
当我们重新执行命令:scrapy crawl cnblogs -s JOBDIR=zant/001 时爬虫会根据p0文件从停止的地方开始继续爬取,
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启的更多相关文章
- 第三百五十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—chrome谷歌浏览器无界面运行、scrapy-splash、splinter
第三百五十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—chrome谷歌浏览器无界面运行.scrapy-splash. splinter 1.chrome谷歌浏览器无界面运行 chrome ...
- 第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目
第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目 scrapyd模块是专门用于部署scrapy项目的,可以部署和管理scrapy项目 下载地址:h ...
- 第三百六十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)基本的索引和文档CRUD操作、增、删、改、查
第三百六十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)基本的索引和文档CRUD操作.增.删.改.查 elasticsearch(搜索引擎)基本的索引 ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 第三百五十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy信号详解
第三百五十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy信号详解 信号一般使用信号分发器dispatcher.connect(),来设置信号,和信号触发函数,当捕获到信号时执行 ...
- 第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图 1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scra ...
- 第三百四十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware中间件全局随机更换user-agent浏览器用户代理
第三百四十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware随机更换user-agent浏览器用户代理 downloadmiddleware介绍中间件是 ...
- 第三百四十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—编写spiders爬虫文件循环抓取内容—meta属性返回指定值给回调函数—Scrapy内置图片下载器
第三百四十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—编写spiders爬虫文件循环抓取内容—meta属性返回指定值给回调函数—Scrapy内置图片下载器 编写spiders爬虫文件循环 ...
- Python分布式爬虫打造搜索引擎完整版-基于Scrapy、Redis、elasticsearch和django打造一个完整的搜索引擎网站
Python分布式爬虫打造搜索引擎 基于Scrapy.Redis.elasticsearch和django打造一个完整的搜索引擎网站 https://github.com/mtianyan/Artic ...
- 四十六 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中
前面我们讲到的elasticsearch(搜索引擎)操作,如:增.删.改.查等操作都是用的elasticsearch的语言命令,就像sql命令一样,当然elasticsearch官方也提供了一个pyt ...
随机推荐
- .NET Core 中读取appsettings.json配置文件的方法
appsettings.json配置文件结构如下: { "WeChatPay": { "WeChatApp_ID": "wx9999998999&qu ...
- ES6,新增数据结构Set的用法
ES6 提供了新的数据结构 Set. 特性 似于数组,但它的一大特性就是所有元素都是唯一的,没有重复. 我们可以利用这一唯一特性进行数组的去重工作. 单一数组的去重. let set6 = new S ...
- javascript基础拾遗(三)
1.map数组映射操作 function add(x) { return x+1 } var nums = [1,3,5,7,9] result = nums.map(add) console.log ...
- ZooKeeper示例 分布式锁
[转载请注明作者和原文链接, 如有谬误, 欢迎在评论中指正. ] 场景描述 在分布式应用, 往往存在多个进程提供同一服务. 这些进程有可能在相同的机器上, 也有可能分布在不同的机器上. 如果这些进程 ...
- 【Socket】linux高性能网络服务程序
1.mystery引入 1)高性能的网络服务程序分为单线程重复式网络服务.多进程网络服务 .多线程网络服务.线程池网络服务和IO多路复用网络服务等 2)单线程重复式是最基本的一种TCP服务模式,其实现 ...
- python版本坑:md5例子(python2与python3中md5区别)
对于一些字符,python2和python3的md5加密出来是不一样的. Python2 和Python3MD5加密 # python2.7 pwd = "xxx" + chr(1 ...
- JIRA python篇之展示多人未完成任务列表
[本文出自天外归云的博客园] 通过python中的jira类我们可以方便的操作jira,获取一些我们想要再加工的信息. 这里举例,用html页面的形式展示分派给组内每个人的任务(未完成的.正在进行中的 ...
- c++ 调用matlab程序
以64 bit win7下的matlab 2012a(64bit)和vs2010为例:[1] 在vs2010中新建一个C++控制台工程,添加依赖项:(请根据自己的matlab安装目录更改)[2] ...
- ubuntu 安装 sublime
1.安装包下载 http://www.sublimetext.com/ 2.解压并移动到/usr/lib/下 tar -xvf Sublime.tar.bz2 mv Sublime /usr/lib/ ...
- docker简易命令
docker应用 安装 sudo yum install docker 启动 docker 进程 $ sudo service docker start Docker 默认开机启动 $ sudo ch ...