
Python爬虫-豆瓣电影 Top 250
爬取的网页地址为:https://movie.douban.com/top250
打开网页后,可观察到:TOP250的电影被分成了10个页面来展示,每个页面有25个电影。
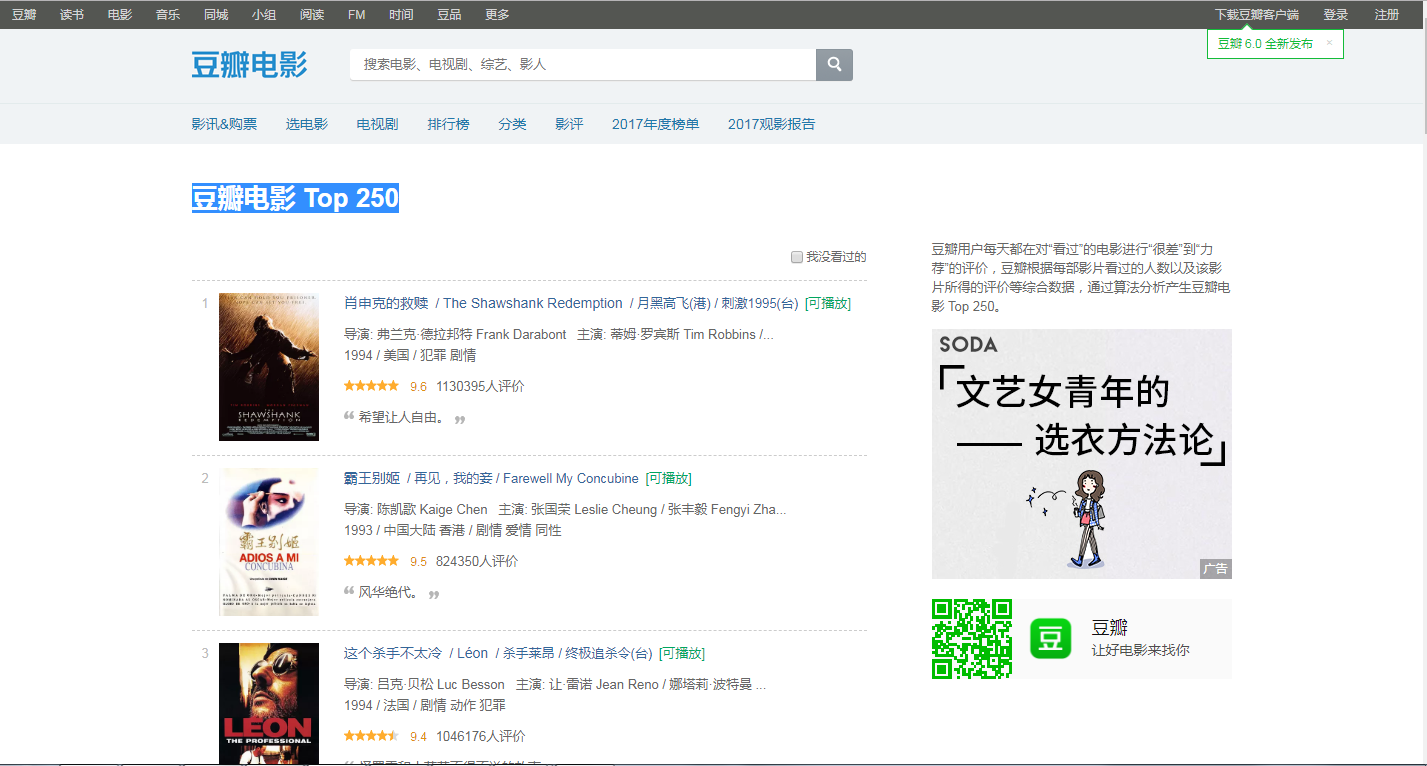
那么要爬取所有电影的信息,就需要知道另外9个页面的URL链接。
第一页:https://movie.douban.com/top250
第二页:https://movie.douban.com/top250?start=25&filter=
第三页:https://movie.douban.com/top250?start=50&filter=
以此类推...
分析网页源代码:以首页为例
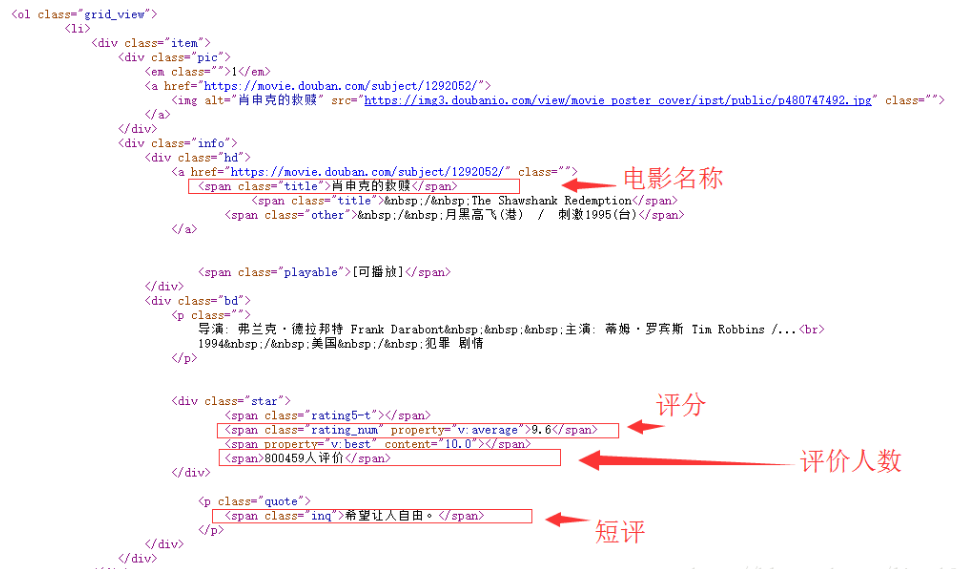
观察后可以发现:
所有电影信息在一个ol标签之内,该标签的 class属性值为grid_view;
每个电影在一个li标签里面;
每个电影的电影名称在:第一个 class属性值为hd 的div标签 下的 第一个 class属性值为title 的span标签里;
每个电影的评分在对应li标签里的(唯一)一个 class属性值为rating_num 的span标签里;
每个电影的评价人数在 对应li标签 里的一个 class属性值为star 的div标签中 的最后一个数字;
每个电影的短评在 对应li标签 里的一个 class属性值为inq 的span标签里。
Python主要模块:requests模块 BeautifulSoup4模块
>pip install requests
>pip install BeautifulSoup4
主要代码:
|
1
2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 |
# -*- coding:utf-8 -*-
import requests # requests模块 from bs4 import BeautifulSoup # BeautifulSoup4模块 import re # 正则表达式模块 import time # 时间模块 import sys # 系统模块 """获取html文档""" """解析数据""" # 得到电影的评分 # 得到电影的评价人数 # 得到电影的短评 ))) # 将输出重定向到txt文件 outputfile.close() |
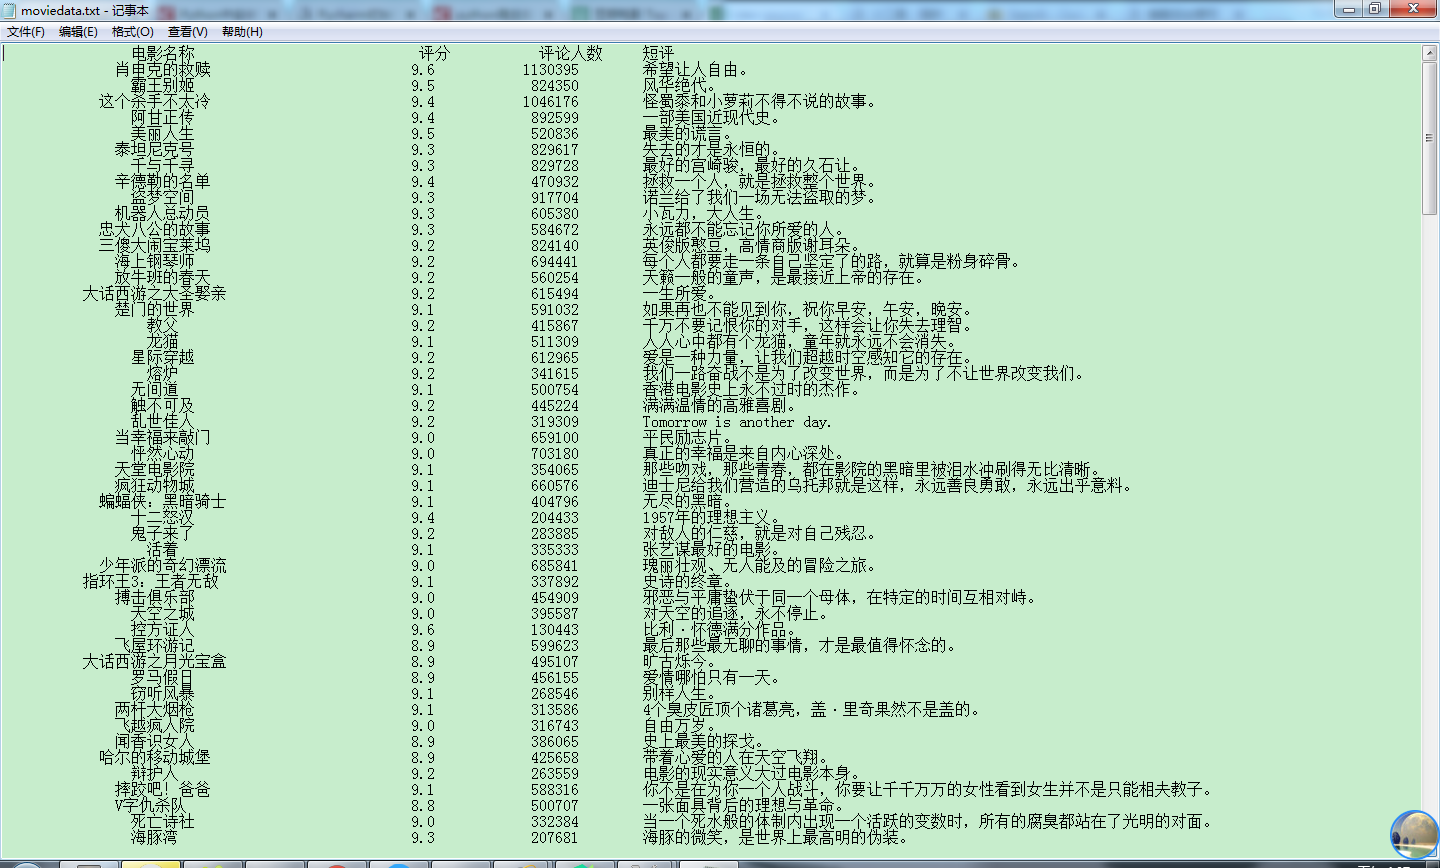
参考出处:https://blog.csdn.net/linzch3/article/details/62444947
Python爬虫-豆瓣电影 Top 250的更多相关文章
- 用python爬取豆瓣电影Top 250
首先,打开豆瓣电影Top 250,然后进行网页分析.找到它的Host和User-agent,并保存下来. 然后,我们通过翻页,查看各页面的url,发现规律: 第一页:https://movie.dou ...
- 爬取豆瓣电影TOP 250的电影存储到mongodb中
爬取豆瓣电影TOP 250的电影存储到mongodb中 1.创建项目sp1 PS D:\scrapy> scrapy.exe startproject douban 2.创建一个爬虫 PS D: ...
- Python开发爬虫之静态网页抓取篇:爬取“豆瓣电影 Top 250”电影数据
所谓静态页面是指纯粹的HTML格式的页面,这样的页面在浏览器中展示的内容都在HTML源码中. 目标:爬取豆瓣电影TOP250的所有电影名称,网址为:https://movie.douban.com/t ...
- python爬虫: 豆瓣电影top250数据分析
转载博客 https://segmentfault.com/a/1190000005920679 根据自己的环境修改并配置mysql数据库 系统:Mac OS X 10.11 python 2.7 m ...
- python爬虫-豆瓣电影的尝试
一.背景介绍 1. 使用工具 Pycharm 2. 安装的第三方库 requests.BeautifulSoup 2.1 如何安装第三方库 File => Settings => Proj ...
- 豆瓣电影 Top 250
import refrom urllib.request import urlopen def getPage(url): # 获取网页的字符串 response = urlopen(url) ret ...
- 爬虫——正则表达式爬取豆瓣电影TOP前250的中英文名
正则表达式爬取豆瓣电影TOP前250的中英文名 1.首先要实现网页的数据的爬取.新建test.py文件 test.py 1 import requests 2 3 def get_Html_text( ...
- 爬虫系列1:Requests+Xpath 爬取豆瓣电影TOP
爬虫1:Requests+Xpath 爬取豆瓣电影TOP [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]: ...
- 放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~)
放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wa ...
随机推荐
- mariadb是替代MySQL的好方式
像Oracle这样成熟稳定的数据库,足以支撑海量数据的存储与查询了?为什么还需要数据切片呢?的确,Oracle的DB确实很成熟很稳定,但是高昂的使用费用和高端的硬件支撑不是每一个公司能支付的起的.试想 ...
- 【C#】使用user32.dll的MessageBox弹窗消息
要使用user32.dll的MessageBox弹窗消息,自然需要引入user32.dll到项目中. 一个最简单的实例如下: using System; using System.Runtime.In ...
- [root]既然sudo 可以暂时获取root权限,那么为何还需要root这个用户呢
既然sudo 可以暂时获取root权限,那么为何还需要root这个用户呢 sudo 非root用户可以临时行使root权限,也就是非root用户可以操作该系统下的任何文件,仍然存在安全风险,怎么解释? ...
- java获取上周任意一天的日期
/** * 获取上周周几的日期,默认一周从周一开始 * @param dayOfWeek * @param weekOffset * @return */ public static Date get ...
- Java并发编程 LockSupport源码分析
这个类比较简单,是一个静态类,不需要实例化直接使用,底层是通过java未开源的Unsafe直接调用底层操作系统来完成对线程的阻塞. package java.util.concurrent.locks ...
- Linq to Sql 动态条件另类实现方法
其实我也不知道是不是另类的,反正我找了好久园子里和其他资源. 无外乎两类 1,构造动态表达式的,这个真心繁琐,我是懒人,不想弄表达式. 2,拼SQL语句,直接执行,这个和ado.net就没有啥区别了. ...
- iptables配置文件/etc/sysconfig/iptables内容详解
#头两行是注释说明# Firewall configuration written by system-config-securitylevel# Manual customization of th ...
- Spring Cloud搭建手册(2)——Spring Cloud Config
※在Dalston.SR2版本以后,均不能正常加密,如果必须使用此功能,需要降级到SR1或Camden SR7. 1.首先需要创建一个config-server工程,作为配置中心的服务器,用来与git ...
- Linux下 ln 命令详解
这是linux中一个非常重要命令,请大家一定要熟悉.它的功能是为某一个文件或目录在另外一个位置建立一个同步的链接,类似Windows下的超级链接. 这个命令最常用的参数是-s,具体用法是: sudo ...
- Linux 条件变量函数signal和wait补充
pthread_cond_wait必须放在pthread_mutex_lock和pthread_mutex_unlock之间,因为他要根据共享变量的状态来觉得是否要等待,而为了不永远等待下去所以必须要 ...