
Linux 搭建Hadoop集群 成功
内容基于(自己的真是操作步骤编写)
一:下载安装 Hadoop
1.1:下载指定的Hadoop
hadoop-2.8.0.tar.gz

1.2:通过XFTP把文件上传到master电脑bigData目录下
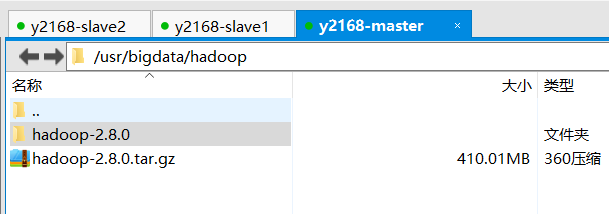
1.3:解压hadoop压缩文件
tar -xvf hadoop-2.8.0.tar.gz
1.4:进入压缩文件之后 复制路径
/bigData/hadoop-2.8.0
1.5:配置Hadoop的环境变量
vim /etc/profile

添加如下配置:

export HADOOP_HOME=/usr/bigdata/hadoop/hadoop-2.8.0
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
让文件生效:
wq!保存并退出
source /etc/profile让文件生效

二:Hadoop集群的配置
2.1:进入hadoop的配置文件位置
进入hadoop配置文件目录
cd hadoop2.8.0/etc/hadoop/

2.2:配置hadoop-env.sh文件
vim hadoop-env.sh
加入如下配置:
export JAVA_HOME=/usr/bigdata/java/jdk1.8.0_121
2.3:配置yarn-env.sh文件
vim yarn-env.sh
加入如下配置:
export JAVA_HOME=/usr/bigdata/java/jdk1.8.0_121
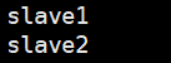
2.4:配置slaves文件,增加slave主机名或者IP地址
01.vim slaves
删除原有localhost,加入子机器名称或者ip地址
2.5:配置core-site.xml文件
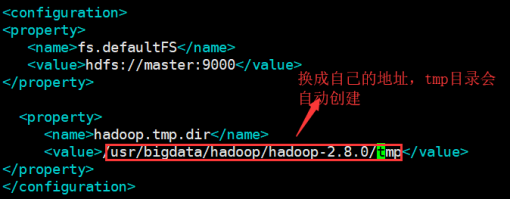
01.vim core-site.xml
02.在configuration节点下加入如下配置:
<property>

     <name>fs.defaultFS</name>

     <value>hdfs://master:9000</value>

</property>

<property>

     <name>hadoop.tmp.dir</name>

    <value>/usr/bigdata/hadoop/hadoop-2.8.0/tmp</value>

</property>
2.6:配置hdfs-site.xml文件
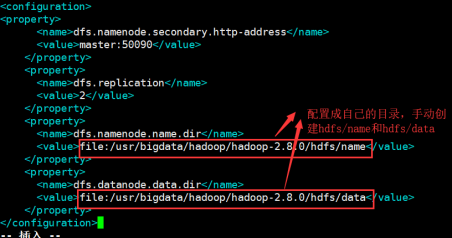
vim hdfs-site.xml
在configuration节点下加入如下配置:
<property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>master:50090</value>

</property>

<property>

    <name>dfs.replication</name>

    <value>2</value>

</property>

<property>

    <name>dfs.namenode.name.dir</name>

    <value>file:/usr/bigdata/hadoop/hadoop-2.8.0/hdfs/name</value>

</property>

<property>

    <name>dfs.datanode.data.dir</name>

    <value>file:/usr/bigdata/hadoop/hadoop-2.8.0/hdfs/data</value>

</property>
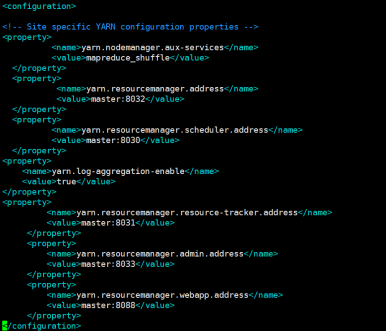
2.7:配置yarn-site.xml文件
在configuration节点下加入如下配置:
vim yarn-site.xml
<property>

    <name>yarn.nodemanager.aux-services</name>

    <value>mapreduce_shuffle</value>

</property>

<property>

     <name>yarn.resourcemanager.address</name>

     <value>master:8032</value>

 </property>

<property>

     <name>yarn.resourcemanager.scheduler.address</name>

     <value>master:8030</value>

</property>

<property>

      <name>yarn.log-aggregation-enable</name>

      <value>true</value>

</property>

<property>

      <name>yarn.resourcemanager.resource-tracker.address</name>

      <value>master:8031</value>

</property>

<property>

      <name>yarn.resourcemanager.admin.address</name>

      <value>master:8033</value>

</property>

<property>

      <name>yarn.resourcemanager.webapp.address</name>

      <value>master:8088</value>

</property>
2.8:配置mapred-site.xml文件
mapred-site.xml.template存在
mapred-site.xml不存在
先要copy一份
cp mapred-site.xml.template mapred-site.xml
然后编辑
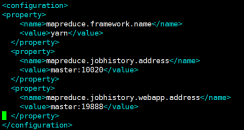
vim mapred-site.xml
在configuration节点下加入如下配置:
<property>

     <name>mapreduce.framework.name</name>

     <value>yarn</value>

</property>

<property>

    <name>mapreduce.jobhistory.address</name>

    <value>master:10020</value>

</property>

<property>

     <name>mapreduce.jobhistory.webapp.address</name>

     <value>master:19888</value>

</property>
2.9:把配置好的hadoop文件复制到其他的子机器中
scp -r /usr/bigdata/hadoop/hadoop-2.8.0 root@slave1:/usr/bigdata/hadoop
scp -r /usr/bigdata/hadoop/hadoop-2.8.0 root@slave2:/usr/bigdata/hadoop
3.0把配置好的/etc/profile复制到其他两个子机器中
scp /etc/profile root@slave1:/etc/profile
scp /etc/profile root@slave2:/etc/profile
分别在两个子机器中应用/etc/profile
source /etc/profile
3.1:在master 主机器中运行
hdfs namenode -format
3.2:在master 主机器中启动hadoop环境
进入/usr/bigdata/hadoop/hadoop-2.8.0/sbin
./start-all.sh 启动hadoop集群
./stop-all.sh 关闭hadoop集群
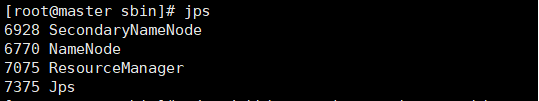
3.3:jps
vim jps
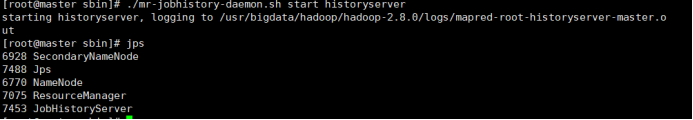
3.4:启动JobHistoryServer
./mr-jobhistory-daemon.sh start historyserver
访问页面:
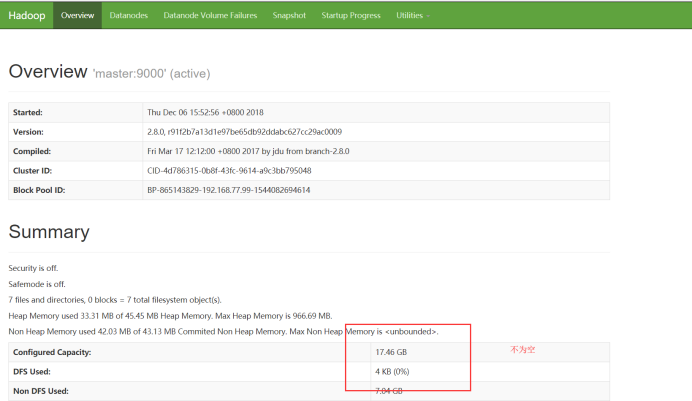


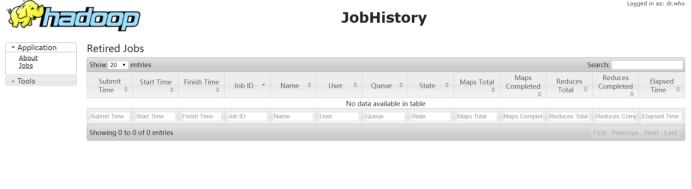
Hadoop集群搭建成功
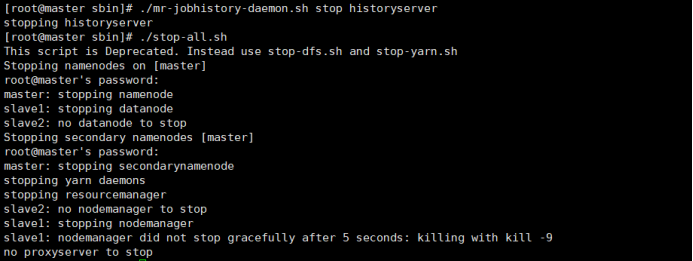
3.5关闭:
第一步:
关闭JobHistoryServer
./mr-jobhistory-daemon.sh stop historyserver
第二步:
关闭hadoop集群
./stop-all.sh
Linux 搭建Hadoop集群 成功的更多相关文章
- Linux 搭建Hadoop集群错误锦集
一.Hadoop集群配置好后,执行start-dfs.sh后报错,一堆permission denied zf sbin $ ./start-dfs.sh Starting namenodes on ...
- Linux 搭建Hadoop集群 ----workcount案例
在 Linux搭建集群---JDK配置 Linux搭建集群---SSH免密登陆 Linux搭建集群---集群搭建成功 的基础上实现workcount案例 注意 虚拟机三台启动集群(自己亲自搭建) 1. ...
- Linux搭建Hadoop集群---Jdk配置
三台虚拟机:master slave1 slave2 192.168.77.99 master 192.168.77.88 slave1 192.168.77.77 slave2 1.修改主机名: ...
- 使用Docker搭建Hadoop集群(伪分布式与完全分布式)
之前用虚拟机搭建Hadoop集群(包括伪分布式和完全分布式:Hadoop之伪分布式安装),但是这样太消耗资源了,自学了Docker也来操练一把,用Docker来构建Hadoop集群,这里搭建的Hado ...
- Linux下搭建Hadoop集群
本文地址: 1.前言 本文描述的是如何使用3台Hadoop节点搭建一个集群.本文中,使用的是三个Ubuntu虚拟机,并没有使用三台物理机.在使用物理机搭建Hadoop集群的时候,也可以参考本文.首先这 ...
- 使用Windows Azure的VM安装和配置CDH搭建Hadoop集群
本文主要内容是使用Windows Azure的VIRTUAL MACHINES和NETWORKS服务安装CDH (Cloudera Distribution Including Apache Hado ...
- 搭建Hadoop集群 (一)
上面讲了如何搭建Hadoop的Standalone和Pseudo-Distributed Mode(搭建单节点Hadoop应用环境), 现在我们来搭建一个Fully-Distributed Mode的 ...
- virtualbox 虚拟3台虚拟机搭建hadoop集群
用了这么久的hadoop,只会使用streaming接口跑任务,各种调优还不熟练,自定义inputformat , outputformat, partitioner 还不会写,于是干脆从头开始,自己 ...
- 搭建Hadoop集群 (三)
通过 搭建Hadoop集群 (二), 我们已经可以顺利运行自带的wordcount程序. 下面学习如何创建自己的Java应用, 放到Hadoop集群上运行, 并且可以通过debug来调试. 有多少种D ...
随机推荐
- JS函数预解析(小记)
一,预解析:寻找var function 形参 a=undefined fn = function fn(){ alert(); } 二,逐行解读代码: 1.表达式 2. ...
- JAVA 重写equals和重写hashCode
面试官可能会问你:“你重写过 hashcode 和 equals 么,为什么重写equals时必须重写hashCode方法?” 首先你需要了解: hashCode()的作用是获取哈希码(散列码) 它实 ...
- Django框架详细介绍---视图系统
Django视图系统 1.什么是视图 在Django中,一个视图函数/类,称为视图.实质就是一个用户自定义的简单函数,用来接收WEB请求并xing响应请求,响应的内容可以是一个HTML文件.重定向.一 ...
- 点火开关分为4个档位,分别是off,acc,IG-on,和ST
off全车除了常火(如应急灯,时钟等的记忆功能)外,均不供电.acc 是附件档,部分车载附属设备供电,如视听系统,仪表灯,灯光等.也就是说,车停在哪里,发动机不转,除了空调不能用外,车内的设备基本都可 ...
- .net core webapi+vue 跨域访问
最近在做一个前后端分离的示例,以下代码完美解决跨域的问题 一.后端服务 1.首先我们建一个.net core webapi的项目 2.项目引用Microsoft.AspNetCore.Cors 包 3 ...
- yaf
一.yaf使用自定义的类 Yaf的library和model的文件命名规则和调用:https://www.cnblogs.com/leedom/p/9396138.html 安装参考: https:/ ...
- iOS开发 -------- 网络状态监测
一 示例代码 需要先把第三方Reachability下载导入到工程中 下载网址 https://github.com/tonymillion/Reachability 1 封装网络工具类 Netw ...
- lnmp或者lamp环境一键安装
参考网址:https://lnmp.org/install.html 下载并安装LNMP一键安装包: 您可以选择使用下载版(推荐美国及海外VPS或空间较小用户使用)或者完整版(推荐国内VPS使用,国内 ...
- VC.重定向标准输出到文件(父进程方式)
1.libxml2 使用过程中,有时 libxml2里面会报一些错误信息,在 控制台的程序中 这些信息看起来比较乱,不易观察,我想将这些信息重定向到 文件中 1.1.本进程内:试着 将标准输出,标准错 ...
- 力扣(LeetCode) 263. 丑数
编写一个程序判断给定的数是否为丑数. 丑数就是只包含质因数 2, 3, 5 的正整数. 示例 1: 输入: 6 输出: true 解释: 6 = 2 × 3 示例 2: 输入: 8 输出: true ...