
Linux 搭建Hadoop集群 ----workcount案例
在
Linux搭建集群---JDK配置
Linux搭建集群---SSH免密登陆
Linux搭建集群---集群搭建成功
的基础上实现workcount案例
注意
虚拟机三台启动集群(自己亲自搭建)
1. wordcount程序
1.1Hadoop集群测试WordCount程序
1.1.1 在hadoop目录下创建一个wordcount文件夹

1.1.2切换到wordcount文件夹,新增两个文件,并且编辑内容
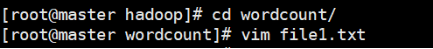
文件内容如下:

文件内容如下:

1.1.3在HDFS中创建input文件夹

1.1.4查看HDFS中的文件夹
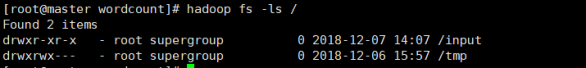
1.1.5 将创建的两个文件复制到/input目录中

1.1.6查看input文件夹下内容
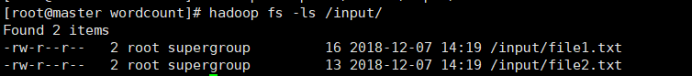
1.1.7 运行wordcount程序
切换到hadoop安装目录下share/hadoop/mapreduce目录下,hadoop自带运行wordcount程序的jar包

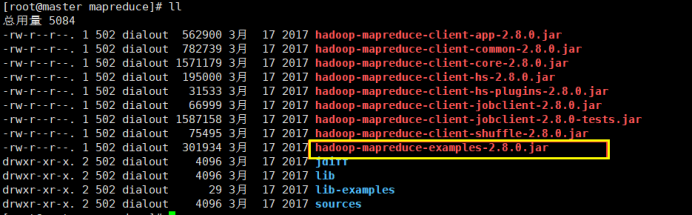
使用jar命令运行wordcount程序,input代表计算文件位置,output代表计算结果指定位置

1.1.8查看运行结果
hadoop fs -cat /output/*
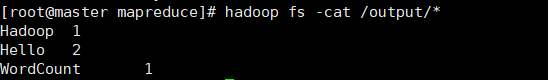
1.2 eclipse集成hadoop插件
1.2.1 如果eclipse安装到windows当中,那么就需要在真机安装Hadoop
配置hadoop环境变量(将hadoop-2.8.0用管理员用户解压)
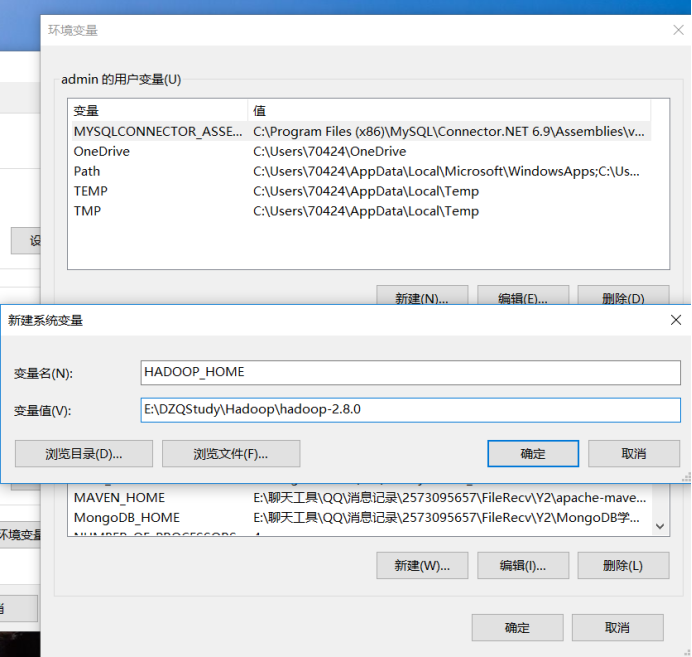

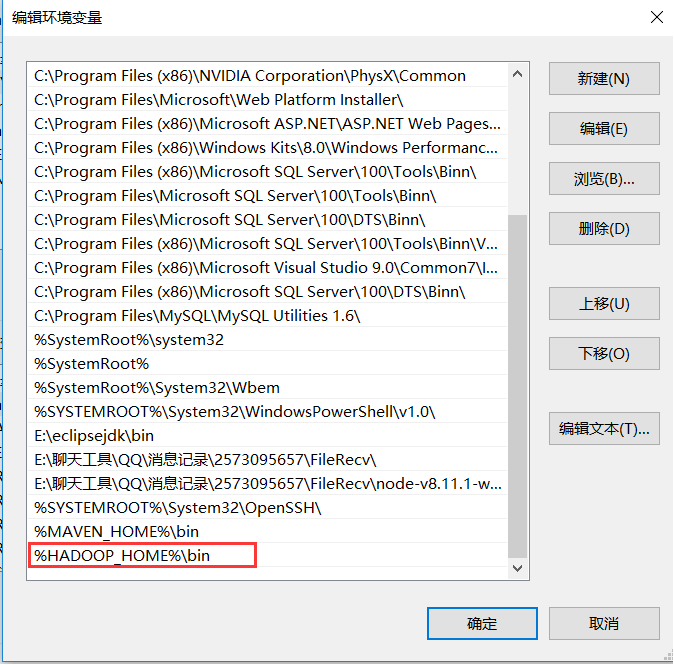
查看JDK 和Hadoop的版本号(不用管理员的身份)

1.2.2 下载hadoop-eclipse-plugin-2.6.0.jar赋值到eclipse安装目录下的plugins目录下
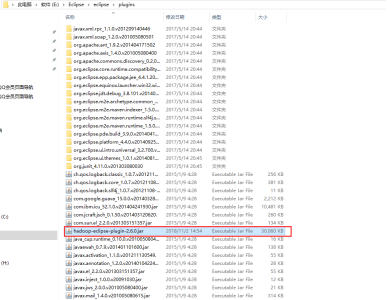
1.2.3配置hadoop安装目录
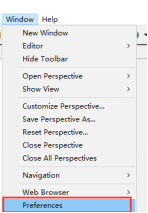
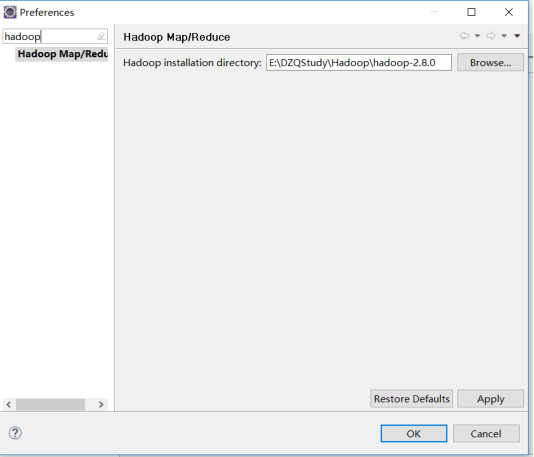
1.2.4配置插件
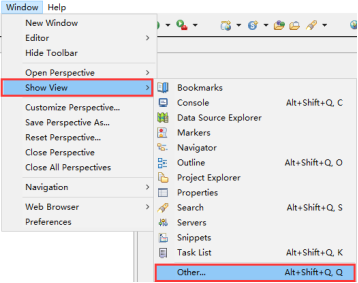
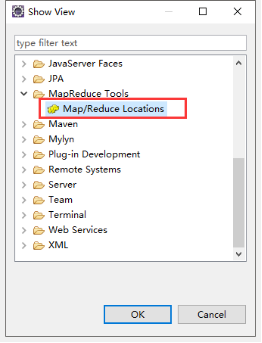
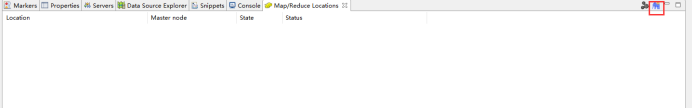
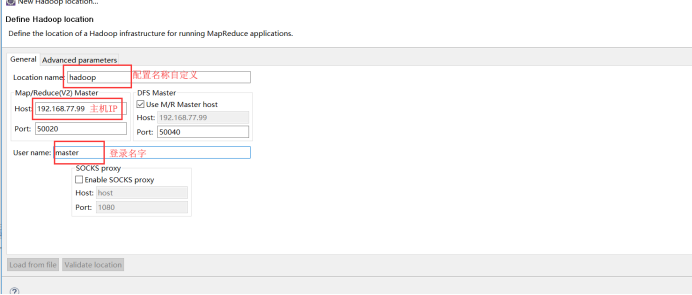
注意:主机名称亦可以换成ip地址,但是真机hosts文件要配置对应关系
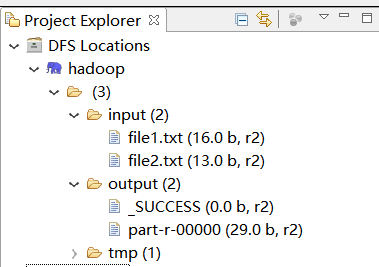
1.3 eclipse运行wordcount程序
1.3.1新建一个mapreduce程序

1.3.2创建WordCount运行程序
在真机安装的hadoop下找到hadoop-mapreduce-examples-2.8.0-sources.jar,目录为..../hadoop-2.8.0\share\hadoop\mapreduce\sources
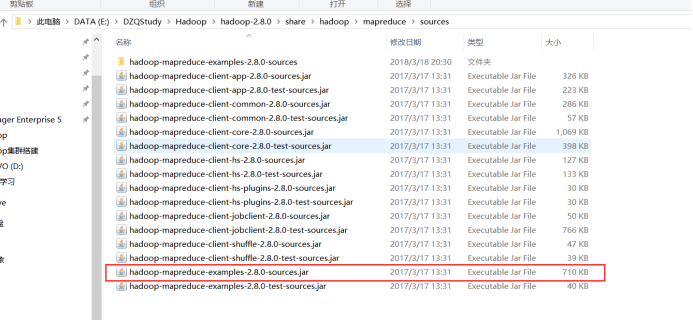
以解压包方式打开,找到WordCount.java,目录为:
hadoop-mapreduce-examples-2.8.0-sources.jar\org\apache\hadoop\examples
右键打开方式---360压缩


1.3.3运行WordCount程序
点击WordCount.java文件,配置启动参数

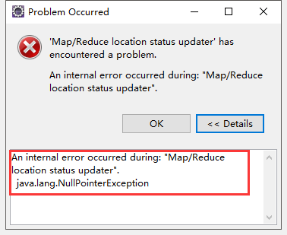
报错:

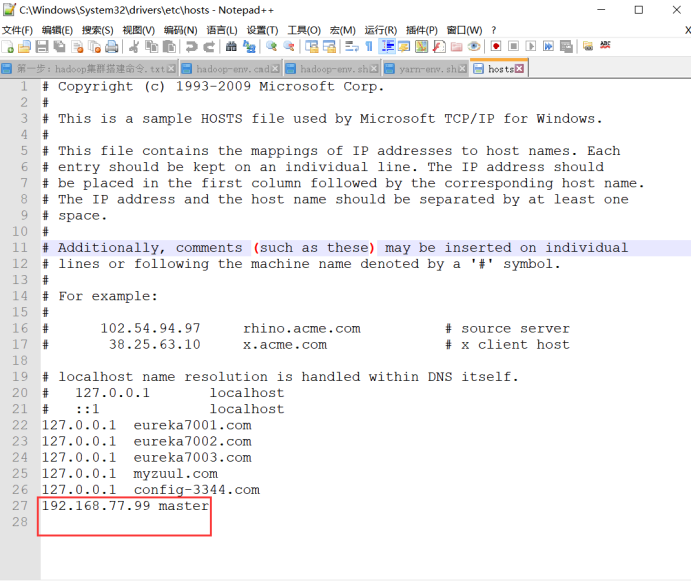
其中配置参数中master可以改为ip地址,如果配置成master那么需要在真机hosts文件当中配置master和ip的对应关系!
参考网址:
https://blog.csdn.net/Biexiansheng/article/details/78019642?tdsourcetag=s_pcqq_aiomsg
如下操作:
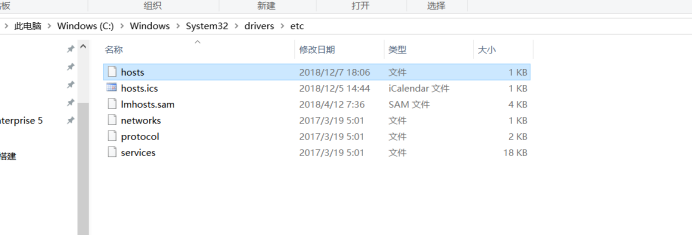
添加以下信息:
第一种错误信息:
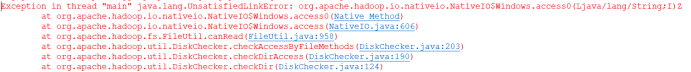
此错误可能在hadoop安装目录下缺少文件,将次压缩包的所有文件复制到hadoop安装目录下的bin

第二个错误
hadoop-2.8.0\share\hadoop\common\sources文件夹中找到hadoop-common-2.8.0-sources.jar,然后以压缩包的方式打开,找到hadoop-common-2.8.0-sources\org\apache\hadoop\io\nativeio\NativeIO.java,复制到项目中,注意,包名和报错的包名保持一致,org.apache.hadoop.io.nativeio

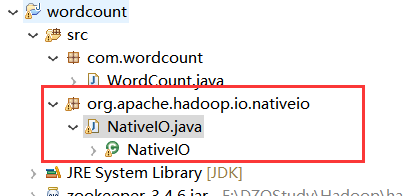
打开代码:
将
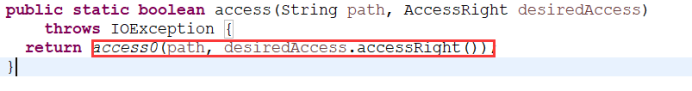
改为:
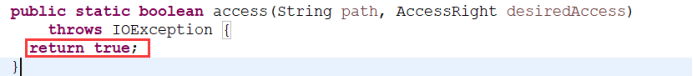
错误2:
org.apache.hadoop.security.AccessControlException: Permissiondenied: user=zhengcy, access=WRITE,inode="/user/root/output":root:supergroup:drwxr-xr-x
在集群中运行hadoop fs -chmod 777 /
运行结果如下所示:
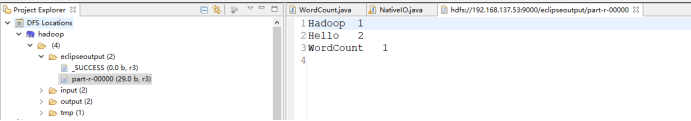
1.4将WordCount程序打成jar包放在集群中运行
1.4.1将程序打包
点击项目-->右键-->选择Export-->找到Runnable JAR File
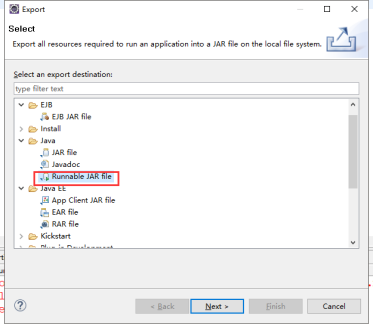

点击Finish,将打包好的Jar包通过XFTP传入到Linux指定位置(/usr/bigdata/hadoop)

在XShell中切换到Jar文件存放位置路径,通过命令运行查看 切入到wordcount.jar 架包所存放的位置 执行以下命令


Linux 搭建Hadoop集群 ----workcount案例的更多相关文章
- Linux 搭建Hadoop集群 成功
内容基于(自己的真是操作步骤编写) Linux 搭建Hadoop集群---Jdk配置 Linux 搭建Hadoop集群 ---SSH免密登陆 一:下载安装 Hadoop 1.1:下载指定的Hadoop ...
- Linux 搭建Hadoop集群错误锦集
一.Hadoop集群配置好后,执行start-dfs.sh后报错,一堆permission denied zf sbin $ ./start-dfs.sh Starting namenodes on ...
- Linux搭建Hadoop集群---Jdk配置
三台虚拟机:master slave1 slave2 192.168.77.99 master 192.168.77.88 slave1 192.168.77.77 slave2 1.修改主机名: ...
- Linux下搭建Hadoop集群
本文地址: 1.前言 本文描述的是如何使用3台Hadoop节点搭建一个集群.本文中,使用的是三个Ubuntu虚拟机,并没有使用三台物理机.在使用物理机搭建Hadoop集群的时候,也可以参考本文.首先这 ...
- 使用Windows Azure的VM安装和配置CDH搭建Hadoop集群
本文主要内容是使用Windows Azure的VIRTUAL MACHINES和NETWORKS服务安装CDH (Cloudera Distribution Including Apache Hado ...
- 搭建Hadoop集群 (三)
通过 搭建Hadoop集群 (二), 我们已经可以顺利运行自带的wordcount程序. 下面学习如何创建自己的Java应用, 放到Hadoop集群上运行, 并且可以通过debug来调试. 有多少种D ...
- 搭建Hadoop集群 (一)
上面讲了如何搭建Hadoop的Standalone和Pseudo-Distributed Mode(搭建单节点Hadoop应用环境), 现在我们来搭建一个Fully-Distributed Mode的 ...
- 在搭建Hadoop集群环境时遇到的一些问题
最近在学习搭建hadoop集群环境,在搭建的过程中遇到很多问题,在这里做一些记录.1. SSH相关的问题 问题一: ssh: connect to host localhost port 22: Co ...
- virtualbox 虚拟3台虚拟机搭建hadoop集群
用了这么久的hadoop,只会使用streaming接口跑任务,各种调优还不熟练,自定义inputformat , outputformat, partitioner 还不会写,于是干脆从头开始,自己 ...
随机推荐
- 关于php
public private protected 修饰词 public: 公有类型 在子类中可以通过self::var调用public方法或属性,parent::method调用父类方法 在实例中可以 ...
- dfs进阶
当自己以为自己深搜(其实就是暴力啦)小成的时候,发现没有题目的积累还是很难写出程序,自己真的是太年轻了:总结一下就是做此类题看是否需要使用vis数组优化以及继续搜索的条件或者满足答案的条件.以下为2题 ...
- 灵雀云容器PaaS平台助力知名股份制银行金融科技革新
互联网.科技和金融的碰撞给银行业带来巨大影响.IT技术起初是传统金融提升效率的工具和方法,随着新技术的演进,技术成为驱动变革的核心要素.Fintech金融科技以技术和数据为驱动,用创新的方法改变了金融 ...
- 【转】Sqlserver将数据从一个表插入到另一个表
-- 复制表结构CREATE TABLE empty_table_name LIKE table_name; --根据table_name创建一个空表empty_table_name,empty_ta ...
- JavaScript 原型链学习(二)原型的动态性
由于在原型中查找值的过程是一次搜索,因此我们对原型对象所做的任何修改都能够立即从实例上反映出来,即使是先创建了实例后修改原型也照样如此.如下示例: var friend = new Person(); ...
- 基于注解的Spring事务配置
spring采用@Transactional注解进行事务申明,@Transactional既可以在方法上申明,也可以在类上申明,方法申明优先于类申明. 1.pom配置 包括spring核心包引入以及s ...
- 在vue项目中引入jquery
在vue项目中引入jquerycnpm install jquery --save在main.js中引入,加入下面这行代码:import 'jquery'注:有些项目是按需加载的,在main.js里面 ...
- EPOCH batchsize
只有在数据很庞大的时候(在机器学习中,几乎任何时候都是),我们才需要使用 epochs,batch size,迭代这些术语,在这种情况下,一次性将数据输入计算机是不可能的.因此,为了解决这个问题,我们 ...
- Vue基础进阶 之 实例方法
常用的实例方法: 数据: vm.$set:设置属性值: vm.$delete:删除属性值: vm.$watch:观测数据变化: 生命周期: vm.$mount:手动挂载Vue实例: vm.$destr ...
- Python Gevent协程自动切换IO
Gevent Gevent 是一个第三方库,可以轻松通过gevent实现并发同步或异步编程,在gevent中用到的主要模式是Greenlet, 它是以C扩展模块形式接入Python的轻量级协程. Gr ...