
SnowFlake雪花算法
简介
自然界不存在两片完全一样的雪花,每一片都是独一无二的,雪花算法的命名由此而来,所有雪花算法表示生成的ID唯一,且生成的ID是按照一定的结构组成。
组成结构
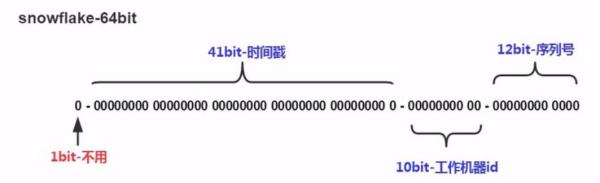
上图可以看到雪花算法的结构由四部分组成,首位无效符,所以我们主要看后面三部分
- 第一部分:由41位的时间戳组成,可以提高查询速度。
- 第二部分:由10位机器码组成,适用于分布式环境下各节点进行标记,10位的长度最多支持部署1024个节点。
- 第三部分:由12位序列号组成,可以同一节点同一毫秒生成多个2^12 - 1(4095)个ID序号。
由于生成的id按时间戳生成,所以ID是按时间递增
分布式系统内不会产生重复ID
使用
环境: .Net Core 3.0
先NuGet一下SnowFlake,这里使用的是Snowflake.Core
下面是实例Demo
private static List<string> list = new List<string>();

static void Main(string[] args)

{

    Snowflake.Core.IdWorker work = new Snowflake.Core.IdWorker(1, 1);

    for (int i = 0; i < 1000; i++)

    {

        var id = work.NextId();

        if (list.Contains(id.ToString()))

        {

            Console.WriteLine("存在");

        }

        else

        {

            list.Add(id.ToString());

            Console.WriteLine(id.ToString());

         }

    }

}
Code
使用时创建IdWorder对象需要单例,如果重复创建会造成重复生成重复ID
最后附上源码
/**

* Twitter的分布式自增ID雪花算法snowflake

* @author MENG

* @create 2018-08-23 10:21

**/

public class SnowFlake {

    /**

     * 起始的时间戳

     */

    private final static long START_STMP = 1480166465631L;

    /**

     * 每一部分占用的位数

     */

    private final static long SEQUENCE_BIT = 12; //序列号占用的位数

    private final static long MACHINE_BIT = 5;   //机器标识占用的位数

    private final static long DATACENTER_BIT = 5;//数据中心占用的位数

    /**

     * 每一部分的最大值

     */

    private final static long MAX_DATACENTER_NUM = -1L ^ (-1L << DATACENTER_BIT);

    private final static long MAX_MACHINE_NUM = -1L ^ (-1L << MACHINE_BIT);

    private final static long MAX_SEQUENCE = -1L ^ (-1L << SEQUENCE_BIT);

    /**

     * 每一部分向左的位移

     */

    private final static long MACHINE_LEFT = SEQUENCE_BIT;

    private final static long DATACENTER_LEFT = SEQUENCE_BIT + MACHINE_BIT;

    private final static long TIMESTMP_LEFT = DATACENTER_LEFT + DATACENTER_BIT;

    private long datacenterId;  //数据中心

    private long machineId;     //机器标识

    private long sequence = 0L; //序列号

    private long lastStmp = -1L;//上一次时间戳

    public SnowFlake(long datacenterId, long machineId) {

        if (datacenterId > MAX_DATACENTER_NUM || datacenterId < 0) {

            throw new IllegalArgumentException("datacenterId can't be greater than MAX_DATACENTER_NUM or less than 0");

        }

        if (machineId > MAX_MACHINE_NUM || machineId < 0) {

            throw new IllegalArgumentException("machineId can't be greater than MAX_MACHINE_NUM or less than 0");

        }

        this.datacenterId = datacenterId;

        this.machineId = machineId;

    }

    /**

     * 产生下一个ID

     *

     * @return

     */

    public synchronized long nextId() {

        long currStmp = getNewstmp();

        if (currStmp < lastStmp) {

            throw new RuntimeException("Clock moved backwards.  Refusing to generate id");

        }

        if (currStmp == lastStmp) {

            //相同毫秒内,序列号自增

            sequence = (sequence + 1) & MAX_SEQUENCE;

            //同一毫秒的序列数已经达到最大

            if (sequence == 0L) {

                currStmp = getNextMill();

            }

        } else {

            //不同毫秒内,序列号置为0

            sequence = 0L;

        }

        lastStmp = currStmp;

        return (currStmp - START_STMP) << TIMESTMP_LEFT //时间戳部分

                | datacenterId << DATACENTER_LEFT       //数据中心部分

                | machineId << MACHINE_LEFT             //机器标识部分

                | sequence;                             //序列号部分

    }

    private long getNextMill() {

        long mill = getNewstmp();

        while (mill <= lastStmp) {

            mill = getNewstmp();

        }

        return mill;

    }

    private long getNewstmp() {

        return System.currentTimeMillis();

    }

    public static void main(String[] args) {

        SnowFlake snowFlake = new SnowFlake(1, 1);

        long start = System.currentTimeMillis();

        for (int i = 0; i < 1000000; i++) {

            System.out.println(snowFlake.nextId());

        }

        System.out.println(System.currentTimeMillis() - start);

    }

}
总结
组成结构大致分为了无效位、时间位、机器位和序列号位。其特点是自增、有序、纯数字组成查询效率高且不依赖于数据库。适合在分布式的场景中应用,可根据需求调整具体实现细节。

SnowFlake雪花算法的更多相关文章
- 分布式Snowflake雪花算法
前言 项目中主键ID生成方式比较多,但是哪种方式更能提高的我们的工作效率.项目质量.代码实用性以及健壮性呢,下面作了一下比较,目前雪花算法的优点还是很明显的. 优缺点比较 UUID(缺点:太长.没法排 ...
- .Net Core ORM选择之路,哪个才适合你 通用查询类封装之Mongodb篇 Snowflake(雪花算法)的JavaScript实现 【开发记录】如何在B/S项目中使用中国天气的实时天气功能 【开发记录】微信小游戏开发入门——俄罗斯方块
.Net Core ORM选择之路,哪个才适合你 因为老板的一句话公司项目需要迁移到.Net Core ,但是以前同事用的ORM不支持.Net Core 开发过程也遇到了各种坑,插入条数多了也特别 ...
- 分布式ID生成器 snowflake(雪花)算法
在springboot的启动类中引入 @Bean public IdWorker idWorkker(){ return new IdWorker(1, 1); } 在代码中调用 @Autowired ...
- 说起分布式自增ID只知道UUID?SnowFlake(雪花)算法了解一下(Python3.0实现)
原文转载自「刘悦的技术博客」https://v3u.cn/a_id_155 但凡说起分布式系统,我们肯定会对一些海量级的业务进行分拆,比如:用户表,订单表.因为数据量巨大一张表完全无法支撑,就会对其进 ...
- SnowFlake 雪花算法详解与实现 & MP中的应用
BackGround 现在的服务基本是分布式,微服务形式的,而且大数据量也导致分库分表的产生,对于水平分表就需要保证表中 id 的全局唯一性. 对于 MySQL 而言,一个表中的主键 id 一般使用自 ...
- Snowflake(雪花算法)的JavaScript实现
现在好多的ID都是服务器端生成的,当然JS也可以生成GUID或者UUID之类的,但是如果想要有序……这时就想到了雪花算法,但是都知道JS中Number的最大值为Number.MAX_SAFE_INTE ...
- 分布式主键解决方案之--Snowflake雪花算法
0--前言 对于分布式系统环境,主键ID的设计很关键,什么自增intID那些是绝对不用的,比较早的时候,大部分系统都用UUID/GUID来作为主键,优点是方便又能解决问题,缺点是插入时因为UUID/G ...
- Go语言实现Snowflake雪花算法
转载请声明出处哦~,本篇文章发布于luozhiyun的博客:https://www.luozhiyun.com/archives/527 每次放长假的在家里的时候,总想找点简单的例子来看看实现原理,这 ...
- snowflake 雪花算法 分布式实现全局id生成
snowflake是Twitter开源的分布式ID生成算法,结果是一个long型的ID. 这种方案大致来说是一种以划分命名空间(UUID也算,由于比较常见,所以单独分析)来生成ID的一种算法,这种方案 ...
- 分布式系统为什么不用自增id,要用雪花算法生成id???
1.为什么数据库id自增和uuid不适合分布式id id自增:当数据量庞大时,在数据库分库分表后,数据库自增id不能满足唯一id来标识数据:因为每个表都按自己节奏自增,会造成id冲突,无法满足需求. ...
随机推荐
- Vue3 面试题 (2023-09-26更新)
Vue3 对比 Vue2 做了那些改进? 1. 响应式系统 vue2 中使用的 Object.defineProperty 实现的响应式,劫持整个对象,递归遍历所有属性,给每个属性添加 getter ...
- k3s 轻量级Kubernetes 安装实例
k3s是由Rancher开发的轻量级Kubernetes,支持嵌入式系统,边缘计算节点等 易于安装,所有组件都在一个小于100MB的二进制文件中,占用资源低 1.1.简单安装试例 curl -sfL ...
- kubernetes批量删除长期处于Terminating状态的namespace
环境是k3s 1.19.1版本 有时候跑实验,实验总是卡住,而且还删不了ns,一跑又n个 强行删除有风险,强删需谨慎!! 创建脚本 delns.sh #!/bin/bash for i in &quo ...
- Debian关闭防火墙命令详解
防火墙是保护计算机系统安全的关键组件.在一些情况下,需要关闭防火墙,以允许特定的应用程序或服务访问网络.在Debian系统中关闭防火墙的方法多种多样,本文将从多个方面对Debian关闭防火墙命令进行详 ...
- 在Ubuntu系统上手动安装GCC环境
Ubuntu系统是自带GCC安装指令的apt install gcc,当前apt源中gcc版本为5.4.0,版本太低,推荐手动安装gcc8.3.0 手动安装gcc8.3.0之前需要先确保安装gcc环境 ...
- Qt/C++开源作品45-CPU内存显示控件/和任务管理器一致
一.前言 在很多软件上,会在某个部位显示一个部件,专门显示当前的CPU使用率以及内存占用,方便用户判断当前程序或者当前环境中是否还有剩余的CPU和内存留给程序使用,在不用打开任务管理器或者资源查看器的 ...
- Qt编写可视化大屏电子看板系统27-模块5负荷分布
一.前言 负荷分布模块包括工序计划负荷.当日负荷.负荷百分比三个子模块,工序计划负荷用表格的形式展示不同工序在不同日期的负荷工作时长,比如组装工序在 2022-02-10 运行了88小时,一般表格显示 ...
- Qt通用方法及类库7
函数名 //int转字节数组 static QByteArray intToByte(int i); static QByteArray intToByteRec(int i); //字节数组转int ...
- Angular(一) - Typescript&Angular入门熟悉
1. Typescript 1.1 安装typescript 1.2 typescript的小例子 1.2.1 新建一个index.ts 1.2.2 编译ts成js 1.2.3 查看生成的index. ...
- java基础知识回顾之java Thread类学习(四)--线程的状态以及转化使用的方法介绍
java基础知识回顾之java Thread类学习(十)--线程的状态以及转化使用的方法介绍 线程的概述: 线程是程序的多个执行路径,执行调度的单位,依托于进程存在.线程不仅 ...