
Spark SQL解析查询parquet格式Hive表获取分区字段和查询条件
首先说一下,这里解决的问题应用场景:
sparksql处理Hive表数据时,判断加载的是否是分区表,以及分区表的字段有哪些?再进一步限制查询分区表必须指定分区?
这里涉及到两种情况:select SQL查询和加载Hive表路径的方式。这里仅就"加载Hive表路径的方式"解析分区表字段,在处理时出现的一些问题及解决作出详细说明。
如果大家有类似的需求,笔者建议通过解析Spark SQL logical plan和下面说的这种方式解决方案结合,封装成一个通用的工具。
问题现象
sparksql加载指定Hive分区表路径,生成的DataSet没有分区字段。
如,
sparkSession.read.format("parquet").load(s"${hive_path}"),hive_path为Hive分区表在HDFS上的存储路径。
hive_path的几种指定方式会导致这种情况的发生(test_partition是一个Hive外部分区表,dt是它的分区字段,分区数据有dt为20200101和20200102):
1. hive_path为"/spark/dw/test.db/test_partition/dt=20200101"
2. hive_path为"/spark/dw/test.db/test_partition/*"
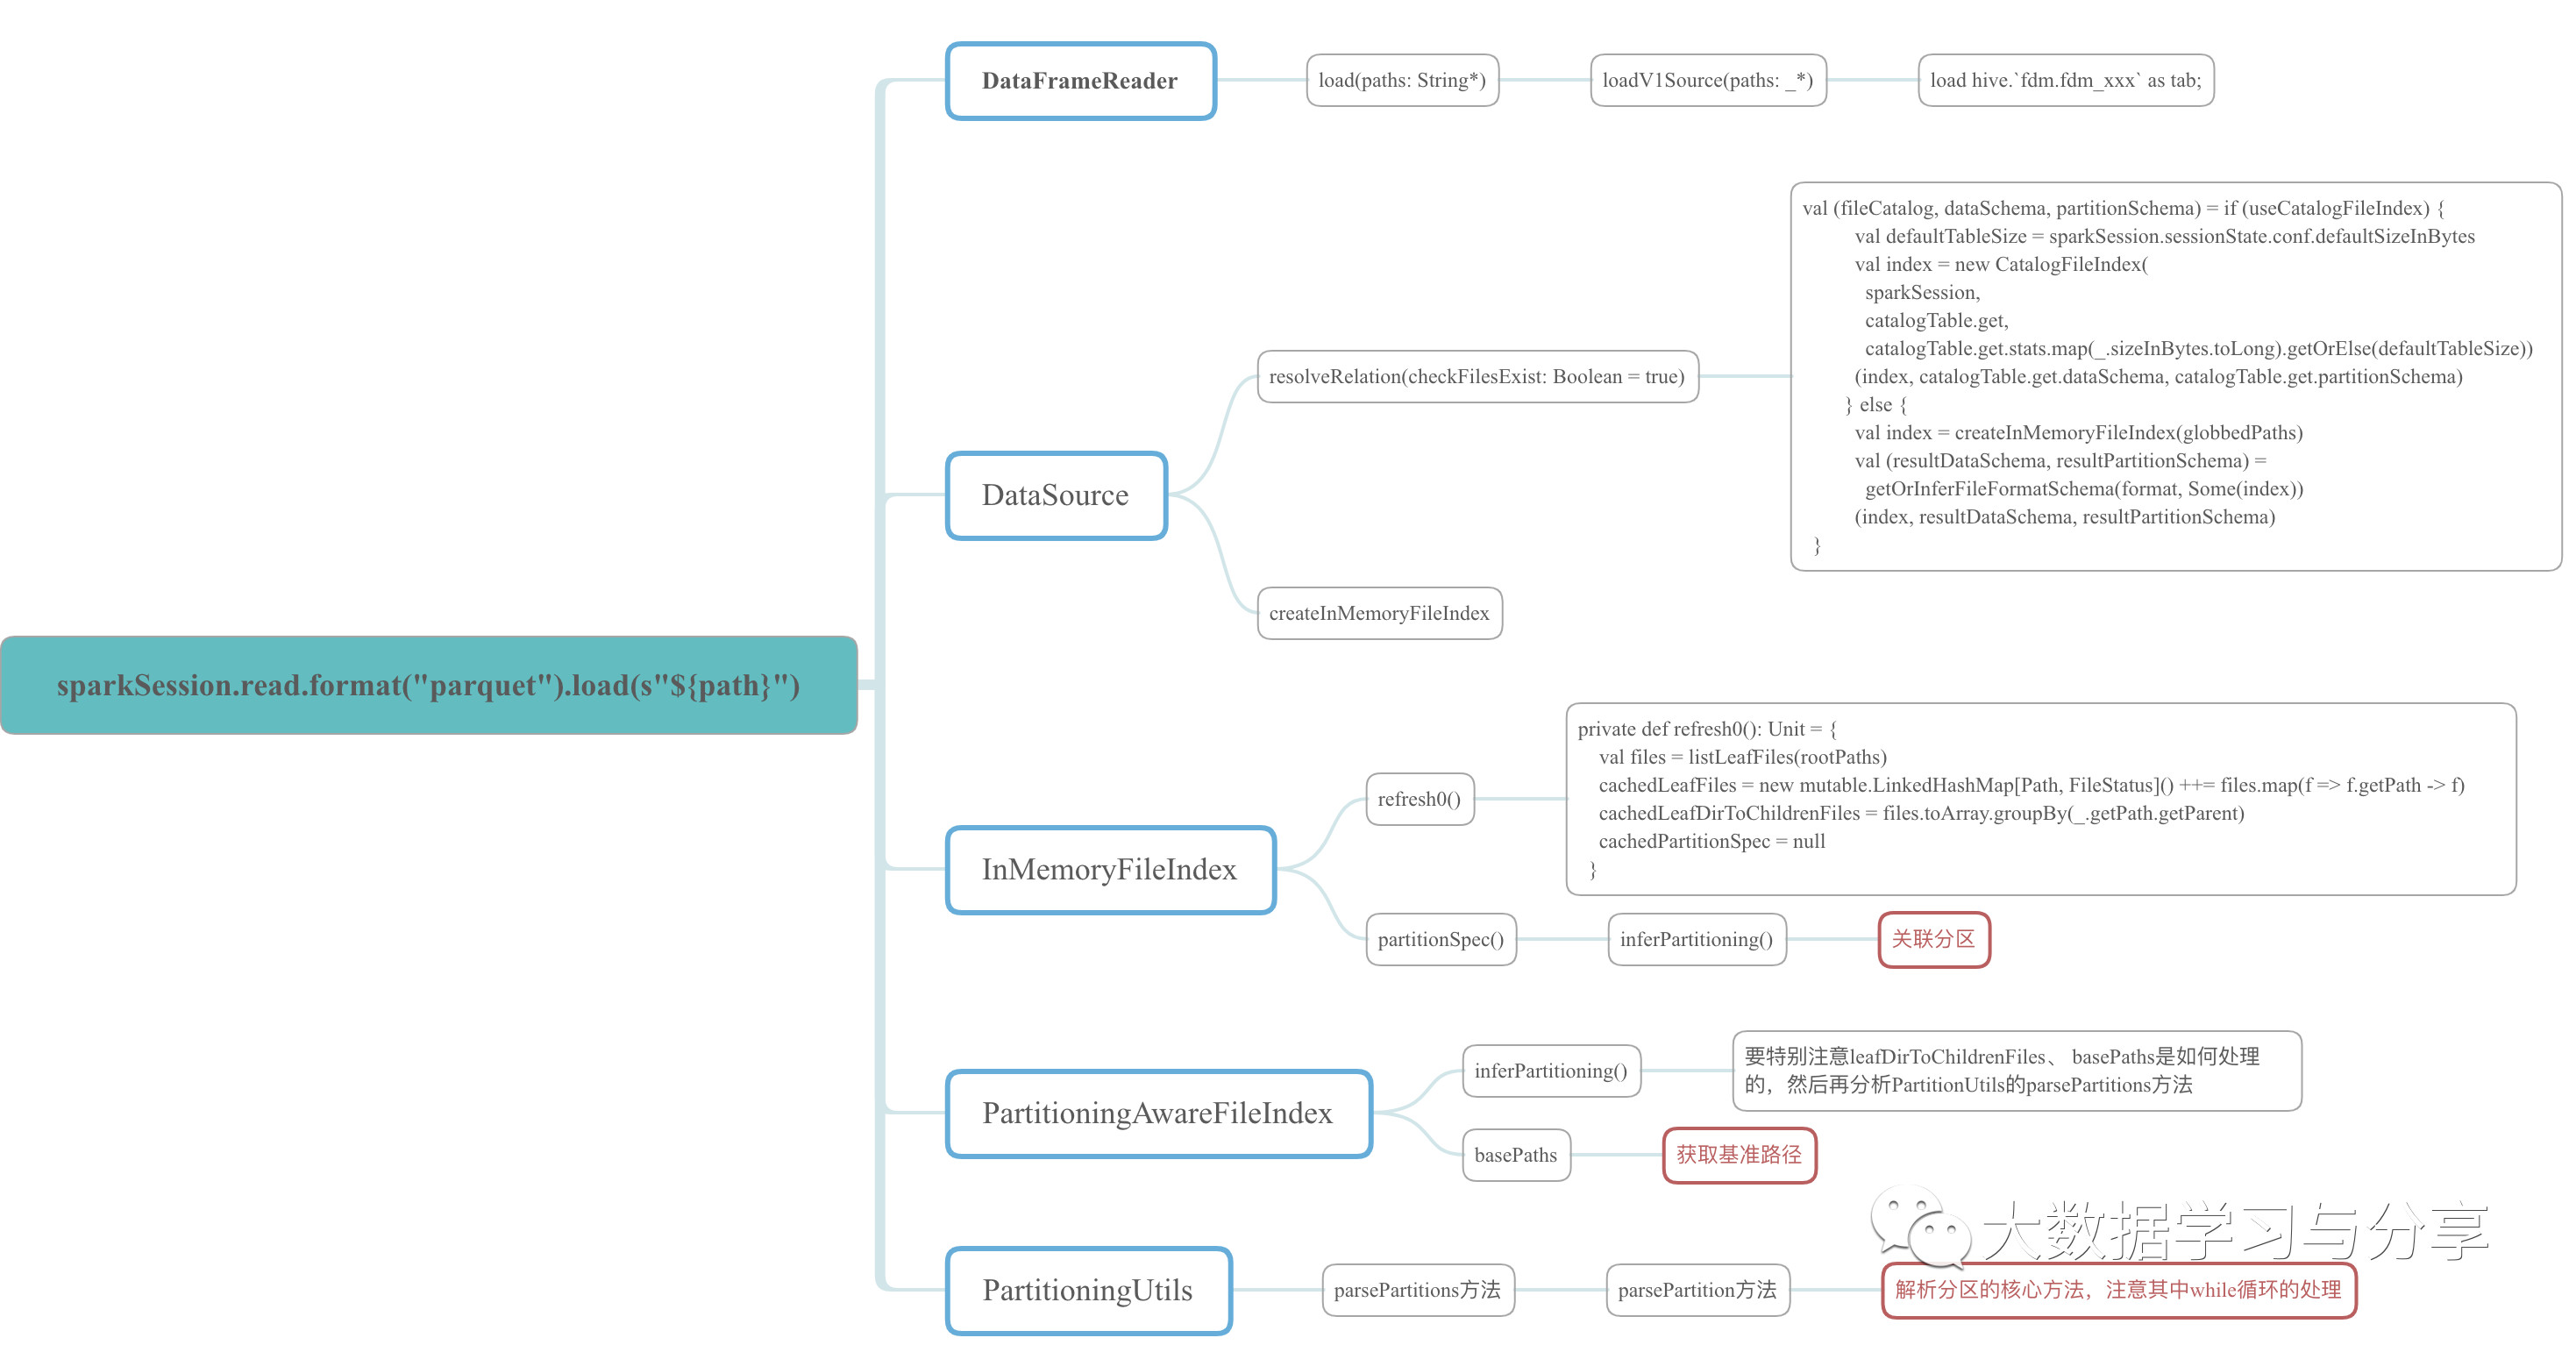
因为牵涉到的源码比较多,这里仅以示例的程序中涉及到的源码中的class、object和方法,绘制成xmind图如下,想细心研究的可以参考该图到spark源码中进行分析。
问题分析
我这里主要给出几个源码段,结合上述xmind图理解:
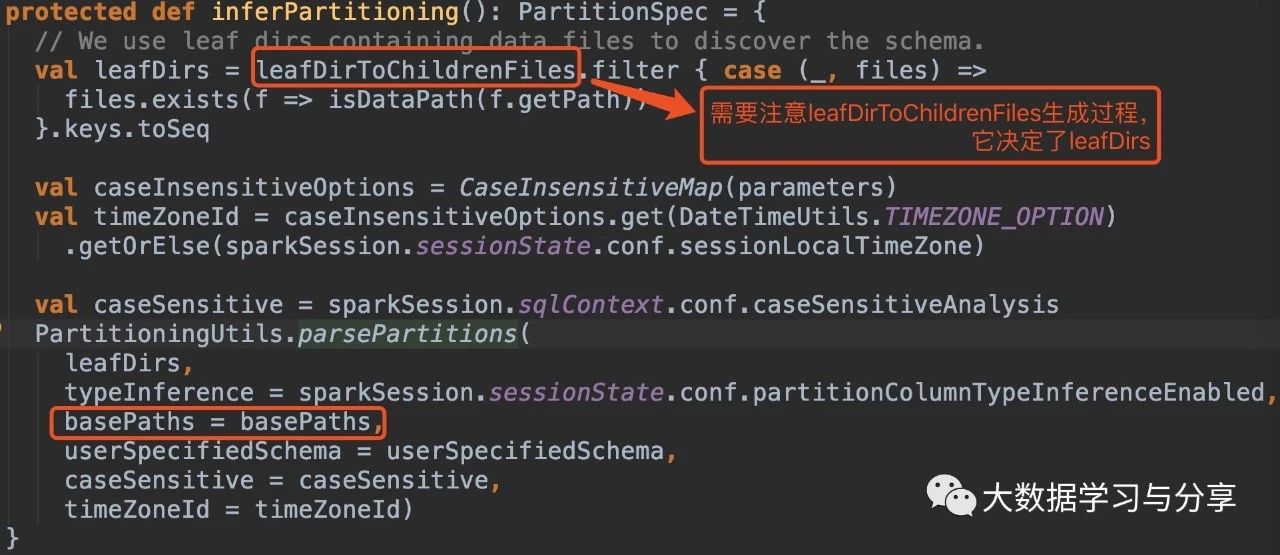
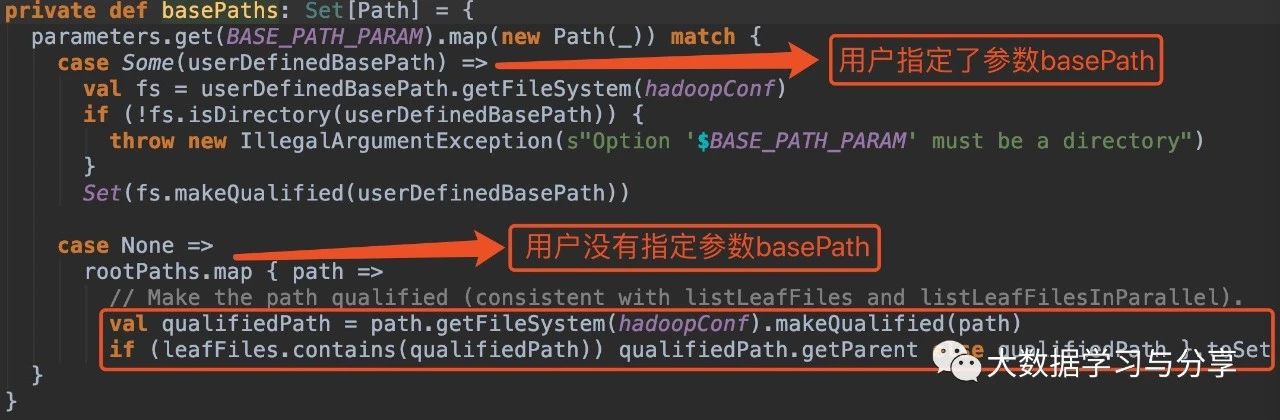
在没有指定参数basePath的情况下:
1. hive_path为/spark/dw/test.db/test_partition/dt=20200101
sparksql底层处理后得到的basePaths: Set(new Path(“/spark/dw/test.db/test_partition/dt=20200101”))【伪代码】

leafDirs: Seq(new Path(“/spark/dw/test.db/test_partition/dt=20200101”))【伪代码】
2. hive_path为/spark/dw/test.db/test_partition/*
sparksql底层处理后得到的basePaths: Set(new Path(“/spark/dw/test.db/test_partition/dt=20200101”),new Path(“/spark/dw/test.db/test_partition/dt=20200102”))【伪代码】

leafDirs: Seq(new Path(“/spark/dw/test.db/test_partition/dt=20200101”),new Path(“/spark/dw/test.db/test_partition/dt=20200102”))【伪代码】
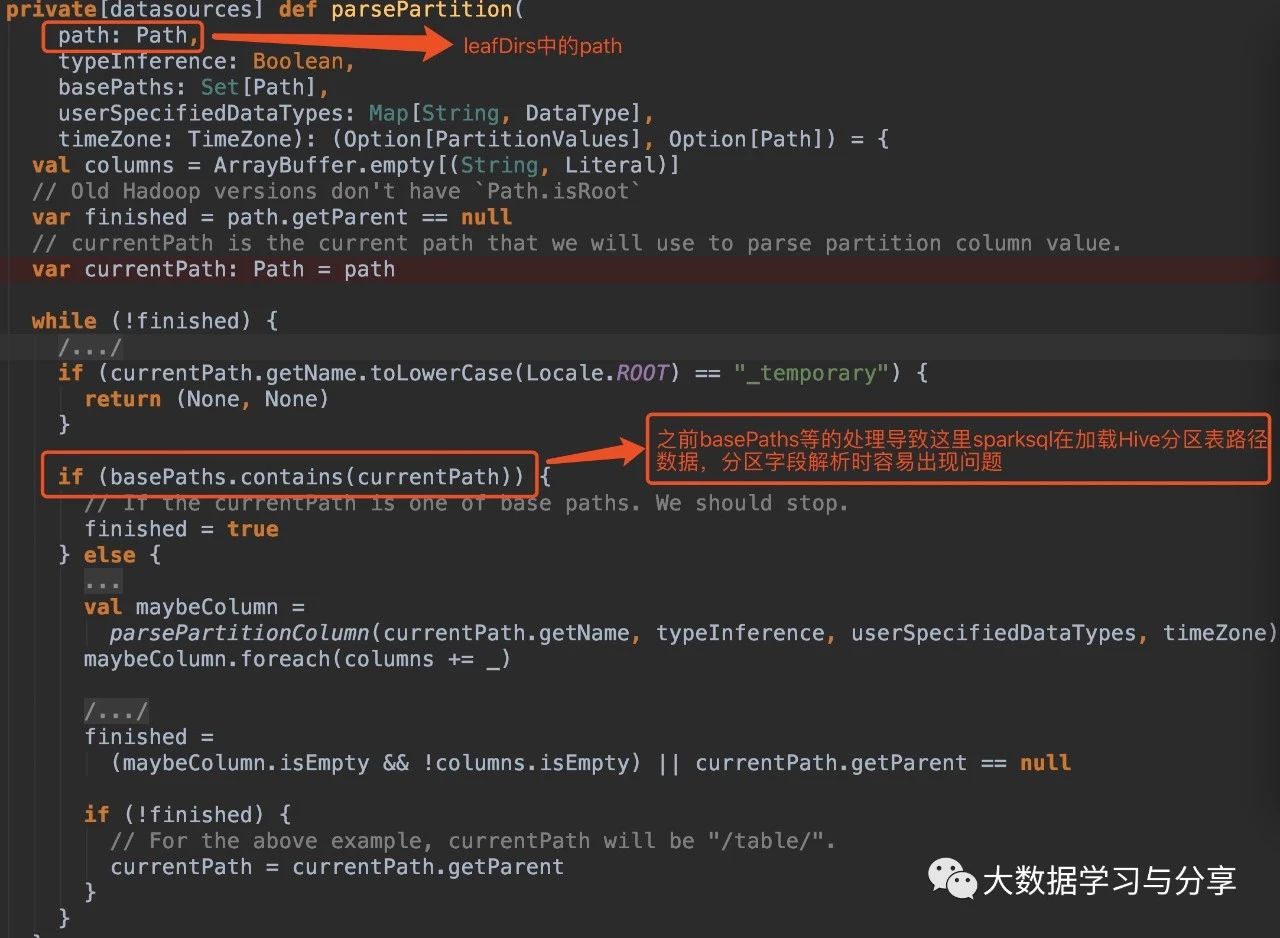
这两种情况导致源码if(basePaths.contains(currentPath))为true,还没有解析分区就重置变量finished为true跳出循环,因此最终生成的结果也就没有分区字段:
解决方案(亲测有效)
1. 在Spark SQL加载Hive表数据路径时,指定参数basePath,如
sparkSession.read.option("basePath","/spark/dw/test.db/test_partition")
2. 主要重写basePaths方法和parsePartition方法中的处理逻辑,同时需要修改其他涉及的代码。由于涉及需要改写的代码比较多,可以封装成工具
关联文章:
Spark SQL解析查询parquet格式Hive表获取分区字段和查询条件的更多相关文章
- Hive表种map字段的查询取用
建表可以用 map<string,string> 查询时可以按照 aaa[bbb], aaa 是map字段名,bbb是其中的参数名,就可以取到这个参数的值了 当参数名bbb是string时 ...
- Spark访问与HBase关联的Hive表
知识点1:创建关联Hbase的Hive表 知识点2:Spark访问Hive 知识点3:Spark访问与Hbase关联的Hive表 知识点1:创建关联Hbase的Hive表 两种方式创建,内部表和外部表 ...
- 3. Spark SQL解析
3.1 新的起始点SparkSession 在老的版本中,SparkSQL提供两种SQL查询起始点,一个叫SQLContext,用于Spark自己提供的SQL查询,一个叫HiveContext,用于连 ...
- Spark DataFrame vector 类型存储到Hive表
1. 软件版本 软件 版本 Spark 1.6.0 Hive 1.2.1 2. 场景描述 在使用Spark时,有时需要存储DataFrame数据到Hive表中,一般的存储方式如下: // 注册临时表 ...
- 【hive】hive表很大的时候查询报错问题
线上hive使用环境出现了一个奇怪的问题,跑一段时间就报如下错误: FAILED: SemanticException MetaException(message:Exception thrown w ...
- 查找sqlserver数据库中,查询某值所表名和字段名
有时候我们想通过一个值知道这个值来自数据库的哪个表以及哪个字段,通过一个存储过程实现的.只需要传入一个想要查找的值,即可查询出这个值所在的表和字段名. 前提是要将这个存储过程放在所查询的数据库. CR ...
- Oracle 查询库中所有表名、字段名、字段名说明,查询表的数据条数、表名、中文表名、
查询所有表名:select t.table_name from user_tables t;查询所有字段名:select t.column_name from user_col_comments t; ...
- sql server 按月对数据表进行分区
当某张数据表数据量较大时,我们就需要对该表进行分区处理,以下sql语句,会将数据表按月份,分为12个分区表存储数据,废话不多说,直接上脚本: use [SIT_L_TMS] --开启 XP_CMDSH ...
- 【转】Oracle 查询库中所有表名、字段名、表名说明、字段名说明
转自 :http://gis-conquer.blog.sohu.com/170243422.html 查询所有表名:select t.table_name from user_tables t; 查 ...
随机推荐
- 机器学习之K均值算法(K-means)聚类
K均值算法(K-means)聚类 [关键词]K个种子,均值 一.K-means算法原理 聚类的概念:一种无监督的学习,事先不知道类别,自动将相似的对象归到同一个簇中. K-Means算法是一种聚类分析 ...
- C语言重点——指针篇(一文让你完全搞懂指针)| 从内存理解指针 | 指针完全解析
有干货.更有故事,微信搜索[编程指北]关注这个不一样的程序员,等你来撩~ 注:这篇文章好好看完一定会让你掌握好指针的本质 C语言最核心的知识就是指针,所以,这一篇的文章主题是「指针与内存模型」 说到指 ...
- 【Elasticsearch 技术分享】—— 十张图带大家看懂 ES 原理 !明白为什么说:ES 是准实时的!
前言 说到 Elasticsearch ,其中最明显的一个特点就是 near real-time 准实时 -- 当文档存储在Elasticsearch中时,将在1秒内以几乎实时的方式对其进行索引和完全 ...
- 配置交换机基于接口划分VLAN(接入层设备作为网关)
组网图形 简介 划分VLAN的方式有:基于接口.基于MAC地址.基于IP子网.基于协议.基于策略(MAC地址.IP地址.接口).其中基于接口划分VLAN,是最简单,最常见的划分方式. 基于接口划分VL ...
- Boltzmann Machine 玻尔兹曼机入门
Generative Models 生成模型帮助我们生成新的item,而不只是存储和提取之前的item.Boltzmann Machine就是Generative Models的一种. Boltzma ...
- libcurl 使用记录
1.libcurl中 CURLOPT_TIMEOUT 是使用 SIGALRM实现的,所以要注意 其对别的 SIGALRM 的使用的影响.
- 机器学习——dbscan密度聚类
完整版可关注公众号:大数据技术宅获取 DBSCAN(Density-Based Spatial Clustering of Applications with Noise,基于密度的有噪应用中的空间聚 ...
- eclipse 和 myeclipse 字符编码设置
需要设置的几处地方为: Window->Preferences->General ->Content Type 所有 Default encoding 设置为UTF-8 Window ...
- Mysql_笔记2018.1.28
1.Mysql代码规范 1.关键字.函数名称大写 2.数据库名称.表名称.字段名称等全部小写 3.必须以分号;结尾 (或 \g) 2.记录mysql日志 开始记录 mysql> \T 日志地址 ...
- 协程实现爬虫的例子主要优势在于充分利用IO时间去请求其他的url
# 分别使用urlopen和requests两个模块进行演示 # import requests # 需要安装的 # from urllib.request import urlopen # # ur ...