
spark处理大规模语料库统计词汇
最近迷上了spark,写一个专门处理语料库生成词库的项目拿来练练手, github地址:https://github.com/LiuRoy/spark_splitter。代码实现参考wordmaker项目,有兴趣的可以看一下,此项目用到了不少很tricky的技巧提升性能,单纯只想看懂源代码可以参考wordmaker作者的一份简单版代码。
这个项目统计语料库的结果和执行速度都还不错,但缺点也很明显,只能处理GBK编码的文档,而且不能分布式运行,刚好最近在接触spark,所以用python实现了里面的算法,使之能处理更大规模的语料库,并且同时支持GBK和UTF8两种编码格式。
分词原理
wordmaker提供了一个统计大规模语料库词汇的算法,和结巴分词的原理不同,它不依赖已经统计好的词库或者隐马尔可夫模型,但是同样能得到不错的统计结果。原作者的文档提到是用多个线程独立计算各个文本块的词的信息,再按词的顺序分段合并,再计算各个段的字可能组成词的概率、左右熵,得到词语输出。下面就详细的讲解各个步骤:
- 读取文本,去掉文本中的换行、空格、标点,将语料库分解成一条一条只包含汉字的句子。
- 将上一步中的所有句子切分成各种长度的词,并统计所有词出现的次数。此处的切分只是把所有出现的可能都列出来,举个例子,天气真好 就可以切分为:天 天气 天气真 天气真好 气 气真 气真好 真 真好 好。不过为了省略一些没有必要的计算工作,此处设置了一个词汇长度限制。
- 针对上面切分出来的词汇,为了筛掉出那些多个词汇连接在一起的情况,会进一步计算这个词分词的结果,例如 月亮星星中的月亮和星星这两个词汇在步骤二得到的词汇中频率非常高,则认为月亮星星不是一个单独的词汇,需要被剔除掉。
- 为了进一步剔除错误切分的词汇,此处用到了信息熵的概念。举例:邯郸,邯字右边只有郸字一种组合,所以邯的右熵为0,这样切分就是错误的。因为汉字词语中汉字的关系比较紧密,如果把一个词切分开来,则他们的熵势必会小,只需要取一个合适的阈值过滤掉这种错误切分即可。
代码解释
原始的C++代码挺长,但是用python改写之后很少,上文中的1 2 3步用spark实现非常简单,代码在split函数中。第3部过滤后的结果已经相对较小,可以直接取出放入内存中,再计算熵过滤,在split中执行target_phrase_rdd.filter(lambda x: _filter(x))过滤的时候可以phrasedictmap做成spark中的广播变量,提升分布式计算的效率,因为只有一台机器,所以就没有这样做。split代码如下,原来很长的代码用python很容易就实现了。
 def split(self):

     """spark处理"""

     raw_rdd = self.sc.textFile(self.corpus_path)

     utf_rdd = raw_rdd.map(lambda line: str_decode(line))

     hanzi_rdd = utf_rdd.flatMap(lambda line: extract_hanzi(line))

     raw_phrase_rdd = hanzi_rdd.flatMap(lambda sentence: cut_sentence(sentence))

     phrase_rdd = raw_phrase_rdd.reduceByKey(lambda x, y: x + y)

     phrase_dict_map = dict(phrase_rdd.collect())

     total_count = 0

     for _, freq in phrase_dict_map.iteritems():

         total_count += freq

     def _filter(pair):

         phrase, frequency = pair

         max_ff = 0

         for i in xrange(1, len(phrase)):

             left = phrase[:i]

             right = phrase[i:]

             left_f = phrase_dict_map.get(left, 0)

             right_f = phrase_dict_map.get(right, 0)

             max_ff = max(left_f * right_f, max_ff)

         return total_count * frequency / max_ff > 100.0

     target_phrase_rdd = phrase_rdd.filter(lambda x: len(x[0]) >= 2 and x[1] >= 3)

     result_phrase_rdd = target_phrase_rdd.filter(lambda x: _filter(x))

     self.result_phrase_set = set(result_phrase_rdd.keys().collect())

     self.phrase_dict_map = {key: PhraseInfo(val) for key, val in phrase_dict_map.iteritems()}
分词结果
进入spark_splitter/splitter目录,执行命令PYTHONPATH=. spark-submit spark.py处理test/moyan.txt文本,是莫言全集,统计完成的结果在out.txt中,统计部分的结果如下,由于算法的原因,带有 的 地 这种连词词语不能正确的切分。
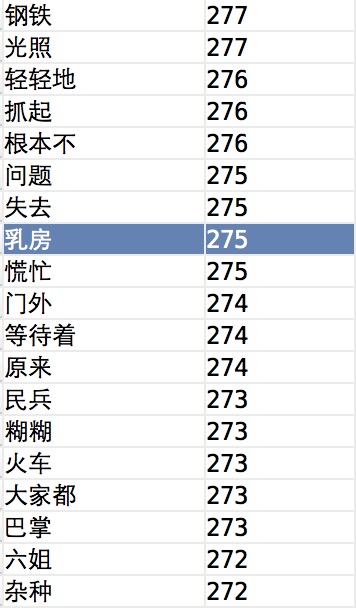
(我也不知道为什么这个词这么多)
问题统计
- 上述的算法不能去掉连词,结果中会出现很多类似于轻轻地 等待着这种词
- 单机上用spark处理小规模数据没有任何优势,比wordmaker中的C++代码慢很多
- 可以和结巴基于隐马尔科夫模型的分词结果做一下准确率的比较
spark处理大规模语料库统计词汇的更多相关文章
- Spark入门(三)--Spark经典的单词统计
spark经典之单词统计 准备数据 既然要统计单词我们就需要一个包含一定数量的文本,我们这里选择了英文原著<GoneWithTheWind>(<飘>)的文本来做一个数据统计,看 ...
- spark streaming - kafka updateStateByKey 统计用户消费金额
场景 餐厅老板想要统计每个用户来他的店里总共消费了多少金额,我们可以使用updateStateByKey来实现 从kafka接收用户消费json数据,统计每分钟用户的消费情况,并且统计所有时间所有用户 ...
- spark MLLib的基础统计部分学习
参考学习链接:http://www.itnose.net/detail/6269425.html 机器学习相关算法,建议初学者去看看斯坦福的机器学习课程视频:http://open.163.com/s ...
- Spark 大数据文本统计
此程序功能: 1.完成对10.4G.csv文件各个元素频率的统计 2.获得最大的统计个数 3.对获取到的统计个数进行降序排列 4.对各个元素出现次数频率的统计 import org.apache.sp ...
- python spark 通过key来统计不同values个数
>>> rdd = sc.parallelize([("), ("b", 1), ("a", 1), ("a", ...
- Spark Streaming:大规模流式数据处理的新贵(转)
原文链接:Spark Streaming:大规模流式数据处理的新贵 摘要:Spark Streaming是大规模流式数据处理的新贵,将流式计算分解成一系列短小的批处理作业.本文阐释了Spark Str ...
- Spark Streaming:大规模流式数据处理的新贵
转自:http://www.csdn.net/article/2014-01-28/2818282-Spark-Streaming-big-data 提到Spark Streaming,我们不得不说一 ...
- Spark MLlib LDA 基于GraphX实现原理及源代码分析
LDA背景 LDA(隐含狄利克雷分布)是一个主题聚类模型,是当前主题聚类领域最火.最有力的模型之中的一个,它能通过多轮迭代把特征向量集合按主题分类.眼下,广泛运用在文本主题聚类中. LDA的开源实现有 ...
- 学习笔记TF018:词向量、维基百科语料库训练词向量模型
词向量嵌入需要高效率处理大规模文本语料库.word2vec.简单方式,词送入独热编码(one-hot encoding)学习系统,长度为词汇表长度的向量,词语对应位置元素为1,其余元素为0.向量维数很 ...
随机推荐
- ASP.NET Core 之 Identity 入门(一)
前言 在 ASP.NET Core 中,仍然沿用了 ASP.NET里面的 Identity 组件库,负责对用户的身份进行认证,总体来说的话,没有MVC 5 里面那么复杂,因为在MVC 5里面引入了OW ...
- SQL Server 致程序员(容易忽略的错误)
标签:SQL SERVER/MSSQL/DBA/T-SQL好习惯/数据库/需要注意的地方/程序员/容易犯的错误/遇到的问题 概述 因为每天需要审核程序员发布的SQL语句,所以收集了一些程序员的一些常见 ...
- 【NLP】十分钟快览自然语言处理学习总结
十分钟学习自然语言处理概述 作者:白宁超 2016年9月23日00:24:12 摘要:近来自然语言处理行业发展朝气蓬勃,市场应用广泛.笔者学习以来写了不少文章,文章深度层次不一,今天因为某种需要,将文 ...
- 装饰者模式 Decoration
1.什么是装饰者模式 动态给对象增加功能,从一个对象的外部来给对象添加功能,相当于改变了对象的外观,比用继承的方式更加的灵活.当使用装饰后,从外部系统的角度看,就不再是原来的那个对象了,而是使用一系列 ...
- BPM配置故事之案例13-触发消息通知
老李:小明! 小明:--见你就没好事,又要我干嘛? 老李:额,小事小事,最近很多部门都觉得Boss的审批速度太慢了,能不能以后给审批人一个消息提醒? 小明:--有一种不太好的预感 老李:怎么,很困难么 ...
- iOS10之Expected App Behaviors
昨天上架到appStore的时候碰到个问题,构建好后上传到itunesconnect的的包都用不了, 显示错误为:此构建版本无效. 或者英文显示为:ITC.apps.preReleaseBuild.e ...
- 【教程】SQLite数据库修复
SQLite 大家都知道,就不多说了. 有时候数据量大了,或者存储过程中出现异常,数据库就可能会出问题. 这是以前公司产品出现过的问题,导致软件都打不开了,我花了不少时间才解决的,趁现在有空贡献出来. ...
- linux下配置matlab运行环境(MCR)
在安装好的matlab下有MCR(MatlabCompilerRuntime)在matlab2011/toolbox/compiler/deploy/glnxa64下找到MCRInstaller.zi ...
- OpenSUSE下编译安装OpenFoam
在不是Ubuntu系统下安装OpenFoam,需要采用编译安装的方式.以下以OpenSuSE为例进行编译安装. 1 软件包准备 需要下载两个程序包: OpenFOAM-4.x-version-4.1. ...
- 端盘子的服务生到月薪一万五的IT精英,你能相信吗
一直以来,我都觉得自己不是一个有故事的人. 以前的我,是个乖宝宝,对父母言听计从,特别内向,甚至一度感觉到自卑.不上学之后,我干过送货员,去工地除泥搬砖,当过油漆工,去过工厂,还去饭店当过端盘子的服务 ...