
Spark实现分组TopN
一.概述
在许多数据中,都存在类别的数据,在一些功能中需要根据类别分别获取前几或后几的数据,用于数据可视化或异常数据预警。在这种情况下,实现分组TopN就显得非常重要了,因此,使用了Spark聚合函数和排序算法实现了分布式TopN计算功能。
二.代码实现
 package scala

 import org.apache.log4j.{Level, Logger}

 import org.apache.spark.sql.types.{StringType, StructField, StructType}

 import org.apache.spark.sql.{Row, SparkSession}

 /**

   * 计算分组topN

   * Created by Administrator on 2019/11/20.

   */

 object GroupTopN {

   Logger.getLogger("org").setLevel(Level.WARN) // 设置日志级别

   def main(args: Array[String]) {

     //创建测试数据

     val test_data = Array("CJ20191120,201911", "CJ20191120,201910", "CJ20191105,201910", "CJ20191105,201909", "CJ20191111,201910")

     val spark = SparkSession.builder().appName("GroupTopN").master("local[2]").getOrCreate()

     val sc = spark.sparkContext

     val test_data_rdd = sc.parallelize(test_data).map(row => {

       val Array(scene, cycle) = row.split(",")

       Row(scene, cycle)

     })

     // 设置数据模式

     val structType = StructType(Array(

       StructField("scene", StringType, true),

       StructField("cycle", StringType, true)

     ))

     // 转换为df

     val test_data_df = spark.createDataFrame(test_data_rdd, structType)

     test_data_df.createOrReplaceTempView("test_data_df")

     // 拼接周期

     val scene_ws = spark.sql("select scene,concat_ws(',',collect_set(cycle)) as cycles from test_data_df group by scene")

     scene_ws.count()

     scene_ws.show()

     scene_ws.createOrReplaceTempView("scene_ws")

     /**

       * 定义参数确定N的大小,暂定为1

       */

     val sum = 1

     // 创建广播变量,把N的大小广播出去

     val broadcast = sc.broadcast(sum)

     /**

       * 定义Udf实现获取组内的前N个数据

       */

     spark.udf.register("getTopN", (cycles : String) => {

       val sum = broadcast.value

       var mid = ""

       if(cycles.contains(",")){ // 多值

         val cycle = cycles.split(",").sorted.reverse // 降序排序

         val min = Math.min(cycle.length, sum)

         for(i <- 0 until min){

           if(mid.equals("")){

             mid = cycle(i)

           }else{

             mid += "," + cycle(i)

           }

         }

       }else{ // 单值

         mid = cycles

       }

       mid

     })

     val result = spark.sql("select scene,getTopN(cycles) cycles from scene_ws")

     result.show()

     spark.stop()

   }

 }
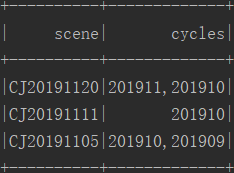
三.结果

四.备注
当N大于1时,多个数据会拼接在一起,若想每个一行,可是使用使用列转行功能,参考我的博客:https://www.cnblogs.com/yszd/p/11266552.html
Spark实现分组TopN的更多相关文章
- 020 Spark中分组后的TopN,以及Spark的优化(重点)
一:准备 1.源数据 2.上传数据 二:TopN程序编码 1.程序 package com.ibeifeng.bigdata.spark.core import java.util.concurren ...
- 大数据学习day29-----spark09-------1. 练习: 统计店铺按月份的销售额和累计到该月的总销售额(SQL, DSL,RDD) 2. 分组topN的实现(row_number(), rank(), dense_rank()方法的区别)3. spark自定义函数-UDF
1. 练习 数据: (1)需求1:统计有过连续3天以上销售的店铺有哪些,并且计算出连续三天以上的销售额 第一步:将每天的金额求和(同一天可能会有多个订单) SELECT sid,dt,SUM(mone ...
- QL查询案例:取得分组 TOP-N
[转]SQL查询案例:取得分组 TOP-N CREATE TABLE TopnTest ( name VARCHAR(10), --姓名 procDate DATETIME, ...
- 用Spark完成复杂TopN计算的两种逻辑
如果有商品品类的数据pairRDD(categoryId,clickCount_orderCount_payCount),用Spark完成Top5,你会怎么做? 这里假设使用Java语言进行编写,那么 ...
- 取分组TOPN好理解案例
- 分别使用Hadoop和Spark实现TopN(1)——唯一键
0.简介 TopN算法是一个经典的算法,由于每个map都只是实现了本地的TopN算法,而假设map有M个,在归约的阶段只有M x N个,这个结果是可以接受的并不会造成性能瓶颈. 这个TopN算法在ma ...
- TopN问题(分别使用Hadoop和Spark实现)
简介 TopN算法是一个经典的算法,由于每个map都只是实现了本地的TopN算法,而假设map有M个,在归约的阶段只有M x N个,这个结果是可以接受的并不会造成性能瓶颈. 这个TopN算法在map阶 ...
- spark面试总结3
Spark core面试篇03 1.Spark使用parquet文件存储格式能带来哪些好处? 1) 如果说HDFS 是大数据时代分布式文件系统首选标准,那么parquet则是整个大数据时代文件存储格式 ...
- Spark面试相关
Spark Core面试篇01 随着Spark技术在企业中应用越来越广泛,Spark成为大数据开发必须掌握的技能.前期分享了很多关于Spark的学习视频和文章,为了进一步巩固和掌握Spark,在原有s ...
随机推荐
- python-分割url字符串
url = ' http://images.jupiterimages.com/common/detail/27/68/22986827.jpg' url.strip().split('/')[-1] ...
- django之视图层和部分模板层
视图层 小白必会三板斧(三个返回的都是HttpResponse对象,通过看源码,可以知道是内部实现) 1.HttpResponse # 返回字符串 2.render # 返回一个html页面 还可以给 ...
- python cookbook3
1.算GC含量 def validate_base_sequence(base_sequence, RNAflag = False): #判断序列是否只含有A.T.G.C.U seq = base_s ...
- luoguP4551最长异或路径
P4551最长异或路径 链接 luogu 思路 从\(1\)开始\(dfs\)求出\(xor\)路径.然后根据性质\(x\)到\(y\)的\(xor\)路径就是\(xo[x]^xo[y]\) 代码 # ...
- 【PE512】Sums of totients of powers(欧拉函数)
点此看题面 大致题意: 求\(\sum_{n=1}^{5*10^8}((\sum_{i=1}^n\phi(n^i))(mod\ n+1))\). 大力推式子 单独考虑\((\sum_{i=1}^n\p ...
- 在程序中修改IP win7 winXP(参考1)
https://blog.csdn.net/bbdxf/article/details/7548443 Windows下程序修改IP的三种方法 以下讨论的平台依据是Window XP + SP1, 不 ...
- thinkphp5.0学习(九):TP5.0视图和模板
原文地址:http://blog.csdn.net/fight_tianer/article/details/78602711 一.视图 1.加载页面 1.继承系统控制器类 return $this- ...
- Windows 有没有办法查看文件被哪个进程占用
经常当我们删除文件时,有时会提示[操作无法完成,因为文件已在另一个程序中打开,请关闭该文件并重试],到底是哪些程序呢? 有时候一个一个找真不是办法,已经被这个问题折磨很久了,今天下决心要把它解决,找到 ...
- hyper-v安装centos后配置网络
YPE="Ethernet" PROXY_METHOD="none" BROWSER_ONLY="no" BOOTPROTO="n ...
- 【转】python 调用super()初始化报错“TypeError: super() takes at least 1 argument”
一.实验环境 1.Windows7x64_SP1 2.Anaconda2.5.0 + python2.7(anaconda集成,不需单独安装) 二.实验步骤 2.1 在python中有如下代码: cl ...