
DataFrames与RDDs的相互转换
import org.apache.spark.sql.{DataFrameReader, SQLContext}

import org.apache.spark.{SparkConf, SparkContext}

object InferringSchema {

  def main(args: Array[String]) {

    //创建SparkConf()并设置App名称

    val conf = new SparkConf().setAppName("SQL-intsmaze")

    //SQLContext要依赖SparkContext

    val sc = new SparkContext(conf)

    //创建SQLContext

    val sqlContext = new SQLContext(sc)

    //从指定的地址创建RDD

    val lineRDD = sc.textFile("hdfs://192.168.19.131:9000/person.tzt").map(_.split(","))

    //创建case class

    //将RDD和case class关联

    val personRDD = lineRDD.map(x => Person(x().toInt, x(), x().toInt))

    //导入隐式转换,如果不导入无法将RDD转换成DataFrame

    //将RDD转换成DataFrame

    import sqlContext.implicits._

    val personDF = personRDD.toDF

    //注册表

    personDF.registerTempTable("intsmaze")

    //传入SQL

    val df = sqlContext.sql("select * from intsmaze order by age desc limit 2")

    //将结果以JSON的方式存储到指定位置

    df.write.json("hdfs://192.168.19.131:9000/personresult")

    //停止Spark Context

    sc.stop()

  }

}

//case class一定要放到外面

case class Person(id: Int, name: String, age: Int)
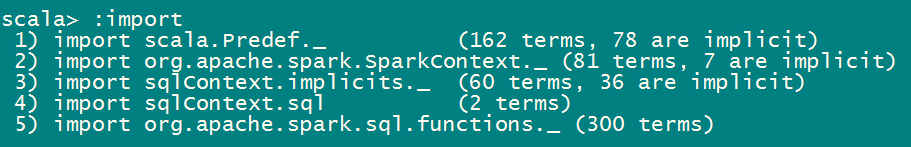
spark shell中不需要导入sqlContext.implicits._是因为spark shell默认已经自动导入了。
打包提交到yarn集群:
/home/hadoop/app/spark/bin/spark-submit --class InferringSchema \

--master yarn \

--deploy-mode cluster \

--driver-memory 512m \

--executor-memory 512m \

--executor-cores  \

--queue default \

/home/hadoop/sparksql-1.0-SNAPSHOT.jar
通过编程接口指定Schema(Programmatically Specifying the Schema)
当JavaBean不能被预先定义的时候,编程创建DataFrame分为三步:
从原来的RDD创建一个Row格式的RDD.
创建与RDD中Rows结构匹配的StructType,通过该StructType创建表示RDD的Schema.
通过SQLContext提供的createDataFrame方法创建DataFrame,方法参数为RDD的Schema.
import org.apache.spark.sql.{Row, SQLContext}

import org.apache.spark.sql.types._

import org.apache.spark.{SparkContext, SparkConf}

object SpecifyingSchema {

  def main(args: Array[String]) {

    //创建SparkConf()并设置App名称

    val conf = new SparkConf().setAppName("SQL-intsmaze")

    //SQLContext要依赖SparkContext

    val sc = new SparkContext(conf)

    //创建SQLContext

    val sqlContext = new SQLContext(sc)

    //从指定的地址创建RDD

    val personRDD = sc.textFile(args()).map(_.split(","))

    //通过StructType直接指定每个字段的schema

    val schema = StructType(

      List(

        StructField("id", IntegerType, true),

        StructField("name", StringType, true),

        StructField("age", IntegerType, true)

      )

    )

    //将RDD映射到rowRDD

    val rowRDD = personRDD.map(p => Row(p().toInt, p().trim, p().toInt))

    //将schema信息应用到rowRDD上

    val personDataFrame = sqlContext.createDataFrame(rowRDD, schema)

    //注册表

    personDataFrame.registerTempTable("intsmaze")

    //执行SQL

    val df = sqlContext.sql("select * from intsmaze order by age desc ")

    //将结果以JSON的方式存储到指定位置

    df.write.json(args())

    //停止Spark Context

    sc.stop()

  }

}
将程序打成jar包,上传到spark集群,提交Spark任务
/home/hadoop/app/spark/bin/spark-submit --class SpecifyingSchema \

--master yarn \

--deploy-mode cluster \

--driver-memory 512m \

--executor-memory 512m \

--executor-cores  \

--queue default \

/home/hadoop/sparksql-1.0-SNAPSHOT.jar \

hdfs://192.168.19.131:9000/person.txt hdfs://192.168.19.131:9000/intsmazeresult
/home/hadoop/app/spark/bin/spark-submit --class SpecifyingSchema \

--master yarn \

--deploy-mode client \

--driver-memory 512m \

--executor-memory 512m \

--executor-cores  \

--queue default \

/home/hadoop/sparksql-1.0-SNAPSHOT.jar \

hdfs://192.168.19.131:9000/person.txt hdfs://192.168.19.131:9000/intsmazeresult
在maven项目的pom.xml中添加Spark SQL的依赖
<dependency>

  <groupId>org.apache.spark</groupId>

  <artifactId>spark-sql_2.</artifactId>

  <version>1.6.</version>

</dependency>
DataFrames与RDDs的相互转换的更多相关文章
- 2.sparkSQL--DataFrames与RDDs的相互转换
Spark SQL支持两种RDDs转换为DataFrames的方式 使用反射获取RDD内的Schema 当已知类的Schema的时候,使用这种基于反射的方法会让代码更加简洁而且效果也很好. 通 ...
- Spark SQL 之 DataFrame
Spark SQL 之 DataFrame 转载请注明出处:http://www.cnblogs.com/BYRans/ 概述(Overview) Spark SQL是Spark的一个组件,用于结构化 ...
- Spark SQL 官方文档-中文翻译
Spark SQL 官方文档-中文翻译 Spark版本:Spark 1.5.2 转载请注明出处:http://www.cnblogs.com/BYRans/ 1 概述(Overview) 2 Data ...
- SparkSql官方文档中文翻译(java版本)
1 概述(Overview) 2 DataFrames 2.1 入口:SQLContext(Starting Point: SQLContext) 2.2 创建DataFrames(Creating ...
- Spark记录-SparkSql官方文档中文翻译(部分转载)
1 概述(Overview) Spark SQL是Spark的一个组件,用于结构化数据的计算.Spark SQL提供了一个称为DataFrames的编程抽象,DataFrames可以充当分布式SQL查 ...
- 转】Spark SQL 之 DataFrame
原博文出自于: http://www.cnblogs.com/BYRans/p/5003029.html 感谢! Spark SQL 之 DataFrame 转载请注明出处:http://www.cn ...
- DataFrames,Datasets,与 SparkSQL
v\:* {behavior:url(#default#VML);} o\:* {behavior:url(#default#VML);} w\:* {behavior:url(#default#VM ...
- A Tale of Three Apache Spark APIs: RDDs, DataFrames, and Datasets(中英双语)
文章标题 A Tale of Three Apache Spark APIs: RDDs, DataFrames, and Datasets 且谈Apache Spark的API三剑客:RDD.Dat ...
- Spark RDDs vs DataFrames vs SparkSQL
简介 Spark的 RDD.DataFrame 和 SparkSQL的性能比较. 2方面的比较 单条记录的随机查找 aggregation聚合并且sorting后输出 使用以下Spark的三种方式来解 ...
随机推荐
- eclipse (ADT) svn插件 过滤上传的 文件 文件夹 一劳永逸
其实很简单哈,过滤的有三种类型,1.文件.2.文件夹.3.android的target 在ADT中 window->preferences-> 会打开如下界面 ignore就是忽视的意思 ...
- css两列等高布局
布局方案 等高布局有几种不同的方法,但目前为止我认为浏览器兼容最好最简便的应该是padding补偿法.首先把列的padding-bottom设为一个足够大的值,再把列的margin-bottom设一个 ...
- GLSL/C++ 实现滤镜效果
入门效果之浮雕 "浮雕"图象效果是指图像的前景前向凸出背景.常见于一些纪念碑的雕刻上.要实现浮雕事实上很easy.我们把图象的一个象素和左上方的象素进行求差运算.并加上一个灰度.这 ...
- Android移动网络如何抓取数据包
1)下载tcpdump工具 tcpdump(dump the traffic on a network)是Linux中强大的网络数据采集分析工具之一,可以将网络中传送的数据包头完全截获下来提供分析.它 ...
- hasattr() 、getattr() 、setattr()
hasattr(object, name) :用于判断一个对象中是否有指定的属性或方法,如果存在返回 True,否则返回 False getattr(object, name, [default]) ...
- iOS事件拦截(实现触摸任意位置隐藏指定view)
项目里有一个需求,类似新浪或者腾讯微博的顶部title栏的类别选择器的消失(在选择器展开的时候,触摸屏幕任何地方使其消失). 最开始的想法是当这个选择器(selectorView)展开的时候,在当前屏 ...
- beginUpdates和endUpdates-实现UITableView的动画块
我们在做UITableView的修改,删除,选择时,需要对UITableView进行一系列的动作操作. 这样,我们就会用到 [tableView beginUpdates]; if (newCount ...
- piblog 0.1
搭建开发环境首先,确认系统安装的Python版本是2.7.x. $ python --version Python 然后,安装开发Web App需要的第三方库:$ sudo pip install j ...
- ubuntu 备忘
卷组扩容 Linux mint采用默认卷组的安装方式 sain@Linux ~ $ df -hl Filesystem Size Used Avail Use% Mounted on udev .7G ...
- Kotlin——初级篇(一):最详细的环境搭建
众所周知,Kotlin出来已经良久了.Kotlin有着众多优势,不管是用于Android开发中,还是Java开发,都能缩减很大的代码量,大大提高了工作效率.而小生本人也是才从忙碌的个工作中抽身出来,有 ...