
七、spark核心数据集RDD
简介
spark RDD操作具体参考官网:http://spark.apache.org/docs/latest/rdd-programming-guide.html#overview
RDD全称叫做Resilient Distributed Datasets,直译为弹性分布式数据集,是spark中非常重要的概念。
首先RDD是一个数据的集合,这个数据集合被划分成了许多的数据分区,而这些分区被分布式地存储在不同的物理机器当中,如图:
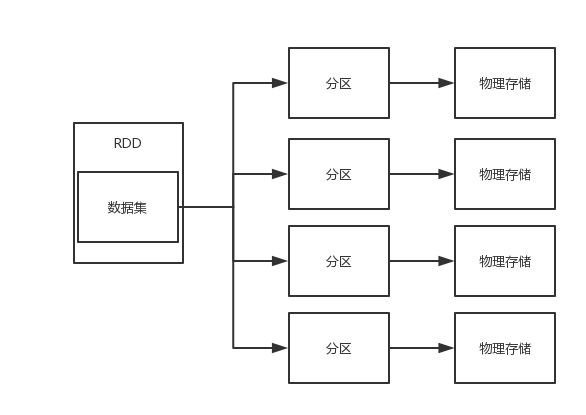
我们反过来想一下,RDD就是很多物理数据块的逻辑抽象。不仅如此,RDD还提供了一些列接口来操作这个逻辑抽象的数据集合。
我们把这些接口分成两大类:
1)transformation 转换
2)action 操作
transformation主要就是把一个RDD转换成另一个RDD,或者就是一开始把原始数据加载成为一个RDD;
注意:transformation并不会马上执行,只有等到action操作的时候才会执行。
action主要就是把一个RDD存储到硬盘,或者触发transformation的执行。
RDD转换和操作示例
我们先看一张图
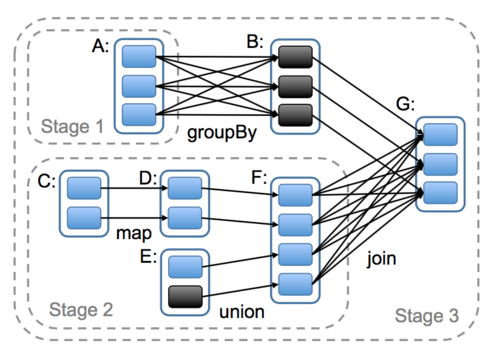
1)首先我们会从数据源中把数据加载成为RDD,也就是左边的RDDA和RDDC以及RDDE
2)RDDC经过map转换成为了RDDD
3)RDDE和RDDC经过union转换成为了RDDF
4)RDDA经过groupBy转换成为了RDDB
5)RDDB和RDDF经过join转换成为了RDDG
以上这些转换只是对整个过程进行一个描述,并没有立即执行,我们可以理解为对过程进行一个计划。直到我们调用一个saveAsSequenceFile持久化action操作的时候就会把上面的步骤催生出一个job,这个job根据是否shuffle(shuffle即宽依赖,下文提及)划分为了三个stage,并开始并行执行。
宽依赖和窄依赖
为了更加理解RDD,我们继续了解一下spark的核心原理
如图
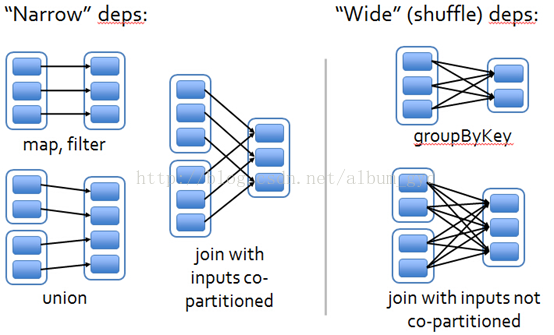
左边的部分是窄依赖,右边的部分是宽依赖即shuffle
上图的每一个蓝色块就是一个分区,而分区的集合就是一个RDD。同时RDD经过转换就会变成另一个RDD,那么也就会存在父子关系,由父RDD转换为子RDD。同时一个子RDD可能由多个父RDD转换而来。
那么,如果一个子RDD的每一个分区都只依赖于任意一个父RDD的其中一个分区,我们就认为它是窄依赖;
而,如果一个子RDD的任意一个分区都依赖于某一个父RDD的一个到多个的分区,我们就认为它是宽依赖。
我们的程序代码被解析成dag有向无环图以后,DagScheduler根据是否shuffle宽依赖来划分stage,每一个shuffle之前都是一个stage。
这么做的理由是这样划分的话,每一个stage的task都可以独立并行计算,而TaskScheduler也不用去了解stage的存在只需要知道task即可,然后TaskScheduler把task分发给WorkNode节点的executor去执行。
七、spark核心数据集RDD的更多相关文章
- Spark 核心概念 RDD 详解
RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此,RDD支持 ...
- Spark 核心概念RDD
文章正文 RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此, ...
- 深入理解Spark(一):Spark核心概念RDD
RDD全称叫做弹性分布式数据集(Resilient Distributed Datasets),它是一种分布式的内存抽象,表示一个只读的记录分区的集合,它只能通过其他RDD转换而创建,为此,RDD支持 ...
- Spark核心类:弹性分布式数据集RDD及其转换和操作pyspark.RDD
http://blog.csdn.net/pipisorry/article/details/53257188 弹性分布式数据集RDD(Resilient Distributed Dataset) 术 ...
- spark系列-2、Spark 核心数据结构:弹性分布式数据集 RDD
一.RDD(弹性分布式数据集) RDD 是 Spark 最核心的数据结构,RDD(Resilient Distributed Dataset)全称为弹性分布式数据集,是 Spark 对数据的核心抽象, ...
- Spark核心—RDD初探
本文目的 最近在使用Spark进行数据清理的相关工作,初次使用Spark时,遇到了一些挑(da)战(ken).感觉需要记录点什么,才对得起自己.下面的内容主要是关于Spark核心-RDD的相关 ...
- Spark弹性分布式数据集RDD
RDD(Resilient Distributed Dataset)是Spark的最基本抽象,是对分布式内存的抽象使用,实现了以操作本地集合的方式来操作分布式数据集的抽象实现.RDD是Spark最核心 ...
- 1.spark核心RDD特点
RDD(Resilient Distributed Dataset) Spark源码:https://github.com/apache/spark abstract class RDD[T: C ...
- Spark计算模型-RDD介绍
在Spark集群背后,有一个非常重要的分布式数据架构,即弹性分布式数据集(Resilient Distributed DataSet,RDD),它是逻辑集中的实体,在集群中的多台集群上进行数据分区.通 ...
随机推荐
- PHP和JS中全局变量和局部变量
一,PHP中全局变量和局部变量 php与C++中对全局变量和局部变量定义类似,全局变量:函数外定义的变量,在全局通用:局部变量:在函数内定义的变量,只在函数内有效.PHP中变量范围跨越了include ...
- 初探APT 攻击
作者:joe 所属团队:Arctic Shell 本文编写参考: https://www.freebuf.com/vuls/175280.html https://www.freebuf. ...
- mxonline实战11,课程详情页2,课程章节页
对应github地址:第11天 一. 课程详情页2 1. 课程详情页第2块中的课程介绍中,修改course-detail.html中代码,搜索课程详情,找到如下代码
- 负载均衡群集LB
负载均衡群集是目前企业用得最多的群集类型,通过主节点负载调度器(Director),使用特定的分流算法,将来自客户机的访问请求分担给多个服务器节点共同处理,从而缓解整个系统的负载压力,响应更多请求:群 ...
- C++多线程编程一
1.C++多线程初步: #include <iostream> #include <thread> #include <Windows.h> using names ...
- delphi 10.2 ---treeview 基本用法
unit Unit2; interface uses Winapi.Windows, Winapi.Messages, System.SysUtils, System.Variants, System ...
- mybaits中"#"和"$"的区别
动态 sql 是 mybatis 的主要特性之一,在 mapper 中定义的参数传到 xml 中之后,在查询之前 mybatis 会对其进行动态解析.mybatis 为我们提供了两种支持动态 sql ...
- Hexo博客系列(一)-Windows系统配置Hexo v3.x个人博客环境
[原文链接]:https://www.tecchen.xyz/blog-hexo-env-01.html 我的个人博客:https://www.tecchen.xyz,博文同步发布到博客园. 由于精力 ...
- CentO7 安装 redis, 主从配置,Sentinel集群故障转移切换
一.Redis的安装(前提是已经安装了EPEL) 安装redis: yum -y install redis 启动/停止/重启 Redis 启动服务: systemctl start re ...
- 16.Generator函数的语法
1.简介 Generator 函数是 ES6 提供的一种异步编程解决方案,语法行为与传统函数完全不同. 执行 Generator 函数会返回一个遍历器对象,也就是说,Generator 函数除了状态机 ...