
Spark弹性分布式数据集RDD
RDD(Resilient Distributed Dataset)是Spark的最基本抽象,是对分布式内存的抽象使用,实现了以操作本地集合的方式来操作分布式数据集的抽象实现。RDD是Spark最核心的东西,它表示已被分区,不可变的并能够被并行操作的数据集合,不同的数据集格式对应不同的RDD实现。RDD必须是可序列化的。RDD可以cache到内存中,每次对RDD数据集的操作之后的结果,都可以存放到内存中,下一个操作可以直接从内存中输入,省去了MapReduce大量的磁盘IO操作。这对于迭代运算比较常见的机器学习算法, 交互式数据挖掘来说,效率提升比较大。
RDD的理解可以简化为:
- 数据集:故名思议RDD是数据集合的抽象,从外部来看,RDD的确可以被看待成经过封装,带扩展特性(如容错性)的数据集合;
- 分布式:数据的计算并非只局限于单个节点,而是多个节点之间协同计算是到;
- 弹性:在计算处理过程中,机器的内存不够时,它会和硬盘进行数据交换,某种程度上会减低性能,但是可以确保计算得以继续进行
可以把RDD理解为Scala集合的分布式版本,Scala集合位于单个JVM,而RDD通过分区分布在多个JVM,这些JVM可能跨越不同的物理机器节点。下图是RDD的一个示意图:

一、编程模型
在Spark中,RDD被表示为对象,通过这些对象上的方法(或函数)调用转换。
定义RDD之后,程序员就可以在动作(注:即action操作)中使用RDD了。动作是向应用程序返回值,或向存储系统导出数据的那些操作,例如,count(返回RDD中的元素个数),collect(返回元素本身),save(将RDD输出到存储系统)。在Spark中,只有在动作第一次使用RDD时,才会计算RDD(即延迟计算)。这样在构建RDD的时候,运行时通过管道的方式传输多个转换。
程序员还可以从两个方面控制RDD,即缓存和分区。用户可以请求将RDD缓存,这样运行时将已经计算好的RDD分区存储起来,以加速后期的重用。缓存的RDD一般存储在内存中,但如果内存不够,可以写到磁盘上。
另一方面,RDD还允许用户根据关键字(key)指定分区顺序,这是一个可选的功能。目前支持哈希分区和范围分区。例如,应用程序请求将两个RDD按照同样的哈希分区方式进行分区(将同一机器上具有相同关键字的记录放在一个分区),以加速它们之间的join操作。在Pregel和HaLoop中,多次迭代之间采用一致性的分区置换策略进行优化,我们同样也允许用户指定这种优化。

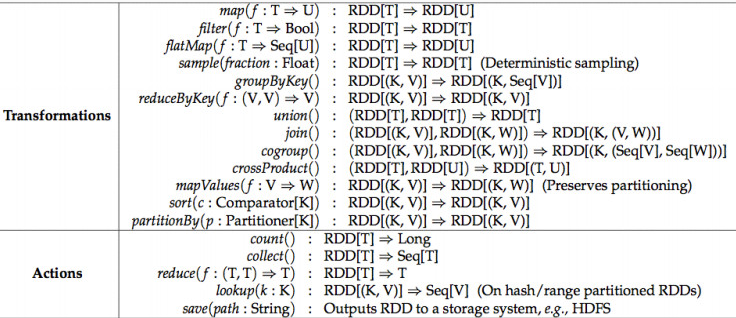
对于RDD,有两种类型的动作,一种是Transformation,一种是Action。它们本质区别是:
- Transformation返回值还是一个RDD。它使用了链式调用的设计模式,对一个RDD进行计算后,变换成另外一个RDD,然后这个RDD又可以进行另外一次转换。这个过程是分布式的
- Action返回值不是一个RDD。它要么是一个Scala的普通集合,要么是一个值,要么是空,最终或返回到Driver程序,或把RDD写入到文件系统中
Transformations转换操作,返回值还是一个 RDD,如 map、 filter、 union
Actions行动操作,返回结果或把RDD持久化起来,如 count、 collect、 save
A=>B表示以=>操作符左边的部分作为输入,对其执行一个函数,并以=>操作符右边代码的执行结果作为输出

参见:http://blog.jasonding.top/2015/07/08/Spark/【Spark】弹性分布式数据集RDD http://www.jianshu.com/p/0b75ddd66999和https://www.zybuluo.com/BrandonLin/note/448121
Spark弹性分布式数据集RDD的更多相关文章
- Spark核心类:弹性分布式数据集RDD及其转换和操作pyspark.RDD
http://blog.csdn.net/pipisorry/article/details/53257188 弹性分布式数据集RDD(Resilient Distributed Dataset) 术 ...
- spark系列-2、Spark 核心数据结构:弹性分布式数据集 RDD
一.RDD(弹性分布式数据集) RDD 是 Spark 最核心的数据结构,RDD(Resilient Distributed Dataset)全称为弹性分布式数据集,是 Spark 对数据的核心抽象, ...
- 5.spark弹性分布式数据集
弹性分布式数据集 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性分布式数据集 ...
- 弹性分布式数据集RDD概述
[Spark]弹性分布式数据集RDD概述 弹性分布数据集RDD RDD(Resilient Distributed Dataset)是Spark的最基本抽象,是对分布式内存的抽象使用,实现了以操作 ...
- 【Spark】Spark核心之弹性分布式数据集RDD
1. RDD概述 1.1 什么是RDD (1) RDD(Resilient Distributed Dataset)弹性分布式数据集,它是Spark的基本数据抽象,它代表一个不可变.可分区.里面的元素 ...
- [Berkeley]弹性分布式数据集RDD的介绍(RDD: A Fault-Tolerant Abstraction for In-Memory Cluster Computing 论文翻译)
摘要: 本文提出了分布式内存抽象的概念--弹性分布式数据集(RDD,Resilient Distributed Datasets).它同意开发者在大型集群上运行基于内存的计算.RDD适用于两种 ...
- RDD内存迭代原理(Resilient Distributed Datasets)---弹性分布式数据集
Spark的核心RDD Resilient Distributed Datasets(弹性分布式数据集) Spark运行原理与RDD理论 Spark与MapReduce对比,MapReduce的计 ...
- Spark - RDD(弹性分布式数据集)
org.apache.spark.rddRDDabstract class RDD[T] extends Serializable with Logging A Resilient Distribut ...
- Spark的核心RDD(Resilient Distributed Datasets弹性分布式数据集)
Spark的核心RDD (Resilient Distributed Datasets弹性分布式数据集) 原文链接:http://www.cnblogs.com/yjd_hycf_space/p/7 ...
随机推荐
- hadoop集群配置SSH免登陆
今天给大家总结一下hadoop集群之间免登陆的步骤 node1 ssh node4 1.在node1中生成密钥 [root@node1 ~]# ssh-keygen -t dsa -P '' -f ~ ...
- Struts2的Action继承ActionSupport时,利用AOP来拦截Action出现NoSuchMethodException
参考:http://zhanghua.1199.blog.163.com/blog/static/46449807201111139501298/ 做项目的时候,由于要用到在Struts2的Actio ...
- [Git] Undo a commit that has already been pushed to the remote repository
If we pushed our changes already to the remote repository we have to pay attention to not change the ...
- iOS 8 swift 键盘不出来 ios 8 uitextfield keyboard not appearing
ios 8 uitextfield keyboard not appearing //发现在iphone 6 and iPhone plus 上面键盘不出来.后来查了下原来要在模拟器里设置下 var ...
- 学习 Linux,302(混合环境): Samba 角色
http://www.ibm.com/developerworks/cn/linux/l-lpic3-310-2/ 概述 在本文中,了解下列概念: Samba 安全模式 核心 Samba 守护程序的角 ...
- Linux安装和设置Samba服务器
1. 安装 安装前先关闭iptables和SELinux. Centos输入以下命令: yum install samba samba-client Ubuntu输入以下命令: apt-get ins ...
- HDFS之FileStatus
任何文件系统的一个重要特性都是提供其目录结构浏览和检索它所存文件和目录相关信息的功能.FileStatus对象封装了文件系统中文件和目录的元数据,包括文件的长度.块大小.备份数.修改时间.所有者以及权 ...
- 很赞的idea教程
感谢: http://pan.baidu.com/s/1dDEaVxn
- CentOS安装Oracle 11gR2(x64)
本文主要步骤是参考:https://www.linuxidc.com/Linux/2014-02/97374.htm 后来自己加入了一些安装过程中遇到的问题和解决方法.使用图形界面安装Oracle已经 ...
- unique_ptr与std::move的使用
形参为unique_ptr u2,而后实参为std::move(unique_ptr u1),这样会将原本u1的内存传递给u2,避免了传递拷贝.例如: void fun(std::unique_ptr ...